El arrastre de la volatilidad: por qué tu retorno promedio exagera tu riqueza
El arrastre de la volatilidad es la brecha entre el retorno promedio de una inversión y la tasa a la que realmente se compone: más o menos la mitad de la varianza. De dónde sale y qué hacer.
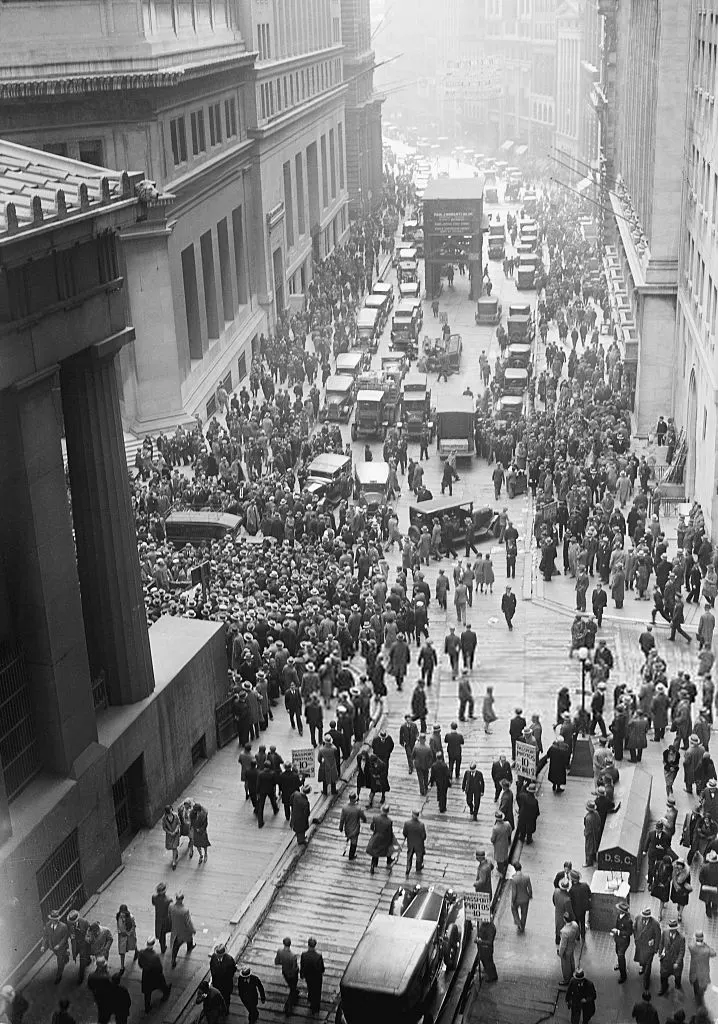
Sobre la imagen El Dow perdió 89% entre su pico de 1929 y su piso de 1932. Para volver tuvo que ganar más de 800%, y en precio no recuperó el máximo de 1929 hasta 1954. Una multitud llena Wall Street frente a la Bolsa de Nueva York durante el crash, 29 de octubre de 1929. Foto: gobierno de los Estados Unidos, dominio público, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
El arrastre de la volatilidad (volatility drag) es la brecha entre el retorno promedio de una inversión y la tasa a la que realmente se compone. Para retornos que no son muy grandes, la tasa de crecimiento compuesta es más o menos el retorno promedio menos la mitad de la varianza, $G \approx \mu - \sigma^2/2$. Cuanto más oscila una inversión, más exagera su retorno promedio lo que terminás teniendo.
Esta es la versión corta de un argumento que desarrollo en detalle en Las finanzas son geometría. Si vas a leer una sola cosa sobre el tema, leé esta.
#Un año que promedia cero y pierde plata
Arrancá con 100 dólares. Sube 50% y después baja 50%.
- Después de la suba: $\$100 \times 1{,}5 = \$150$
- Después de la baja: $\$150 \times 0{,}5 = \$75$
El promedio de los dos retornos es cero, y perdiste un cuarto de tu plata. La baja se aplicó sobre 150 dólares y la suba sobre 100 dólares, así que la baja se llevó más de lo que la suba había puesto. No pasó nada raro. Es lo que la composición le hace a cualquier cosa que oscila.
La misma asimetría aparece en la ganancia que necesitás para recuperarte de una pérdida:
| Pérdida | Ganancia necesaria para empatar |
|---|---|
| 10% | 11,1% |
| 20% | 25% |
| 50% | 100% |
| 80% | 400% |
| 89% | 809% |
La última fila es el Dow Jones Industrial Average entre septiembre de 1929 y julio de 1932. En precio, tardó hasta noviembre de 1954 en volver a su pico de 1929.
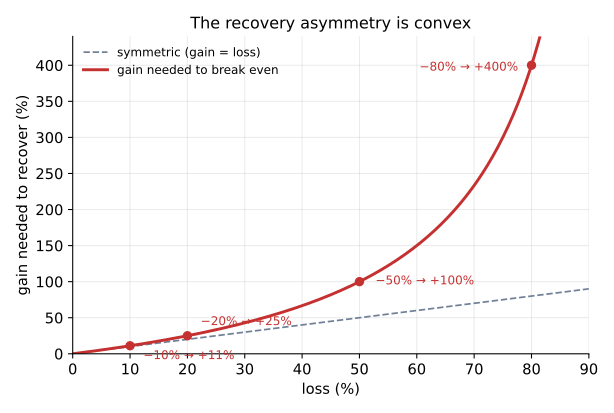
Si la recuperación fuera simétrica, seguiría la línea punteada. Cuanto más profunda la pérdida, más se aleja de ella la ganancia necesaria.
#La fórmula
La regla general es que una pérdida $L$ necesita una ganancia de $L/(1-L)$ para recuperarse. Para una secuencia entera de retornos, el número que importa es el promedio de $\ln(1+R)$, el logaritmo del factor de crecimiento de cada período, porque los logaritmos convierten la multiplicación de la composición en una suma. Desarrollándolo alrededor del retorno promedio $\mu$ queda
$$G = \mathbb{E}[\ln(1+R)] \approx \mu - \frac{\sigma^2}{2}$$
donde $\sigma^2$ es la varianza de los retornos. En las finanzas en tiempo continuo el mismo término aparece de forma exacta: bajo un movimiento browniano geométrico, el logaritmo de la riqueza deriva a $\mu - \sigma^2/2$, no a $\mu$.
Algunos números. Un portafolio que promedia 10% anual con 20% de volatilidad se compone a más o menos 8%. Dos fondos que promedian 10% anual, uno con 10% de volatilidad y otro con 30%, se componen a más o menos 9,5% y 5,5%. En treinta años es la diferencia entre convertir 10.000 dólares en unos 150.000 dólares o en unos 50.000 dólares. El retorno promedio es el mismo, y la riqueza final difiere por un factor de tres.
#Por qué pasa
El logaritmo se curva hacia abajo. Tomá los dos resultados del ejemplo, un factor de 1,5 y uno de 0,5, y marcalos sobre la curva del logaritmo. Si primero promediás los factores te da 1,0, y $\ln 1{,}0 = 0$. Si primero tomás logaritmos y después promediás te da $\frac{\ln 1{,}5 + \ln 0{,}5}{2} \approx -0{,}144$. El segundo queda debajo del primero porque la recta entre dos puntos de una curva que se dobla hacia abajo queda por debajo de la curva.
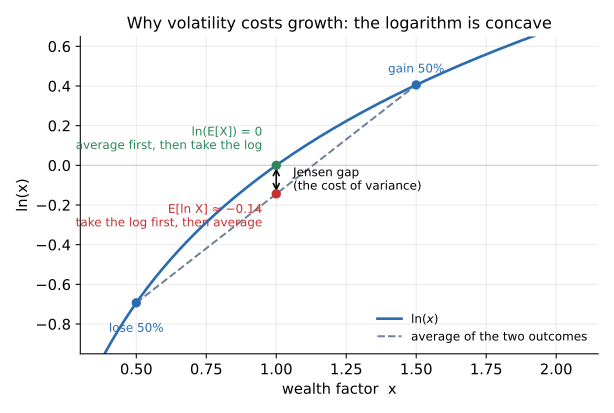
Promediar primero cae sobre la curva en cero. Tomar logaritmos primero cae sobre la cuerda, debajo, en alrededor de −0,14. Esa brecha vertical es el costo de la varianza.
Esa es la desigualdad de Jensen: para una función cóncava, el promedio de la función es a lo sumo la función del promedio. Aplicada a la riqueza dice que $\mathbb{E}[\ln(1+R)] \le \ln(1 + \mathbb{E}[R])$, con igualdad solo cuando los retornos no varían nunca. La fórmula de $\sigma^2/2$ es el primer término de esa brecha.
#Cuál de los promedios es el tuyo
El promedio aritmético no está mal. Es el número correcto para un período, o para el resultado promedio entre muchos inversores que tienen el activo una sola vez. Es el número equivocado para un inversor que lo tiene durante muchos períodos, que es lo que hacemos casi todos. Ese inversor vive la tasa compuesta.
La brecha entre esos dos promedios es lo que hace que la riqueza no sea ergódica, algo que explico con una sola moneda en La ergodicidad, explicada.
Abrí esta simulación en Explorar →
Poné el retorno promedio en 10% y mové la volatilidad. Con 0% todas las trayectorias son la línea roja. Con 20% el inversor mediano se compone cerca del 8%, y con 40% cerca del 2%, con el mismo retorno promedio todo el tiempo.
#Qué hacer
Si la volatilidad es un costo, reducirla vale algo aunque no suba el retorno promedio.
Diversificá. Combinar activos que no se mueven juntos baja $\sigma^2$ para un $\mu$ dado. El arrastre cae con el cuadrado de la volatilidad, así que reducir la volatilidad a la mitad baja el arrastre a un cuarto.
Cuidado con el apalancamiento. Duplicar tu exposición duplica $\mu$ y cuadruplica $\sigma^2$. Pasado cierto punto, más apalancamiento baja la tasa de crecimiento, y el punto donde el crecimiento es máximo es la fracción de Kelly, que en esta aproximación es $\mu/\sigma^2$ con $\mu$ medido por encima de la tasa libre de riesgo.
Cortá las peores pérdidas. Como el arrastre viene del tamaño de las oscilaciones, las pérdidas grandes hacen la mayor parte del daño. Pagar un costo chico y constante para sacártelas de encima puede subir la tasa compuesta aunque baje el promedio. Ese es el argumento a favor de la cobertura de colas, que probé con diecisiete años de datos de opciones en el debate sobre la cobertura de colas.
#Qué dicen los datos
La fórmula no es solo un modelo. Tomá las cuarenta monedas de forex-centuries, el dataset abierto de tipos de cambio que armé para Leptokurtic, con datos anuales que llegan hasta 1791. Para cada una, medí la brecha entre el cambio anual promedio de su tipo de cambio contra el dólar y el cambio anual compuesto, y comparala con lo que predice $\sigma^2/2$.
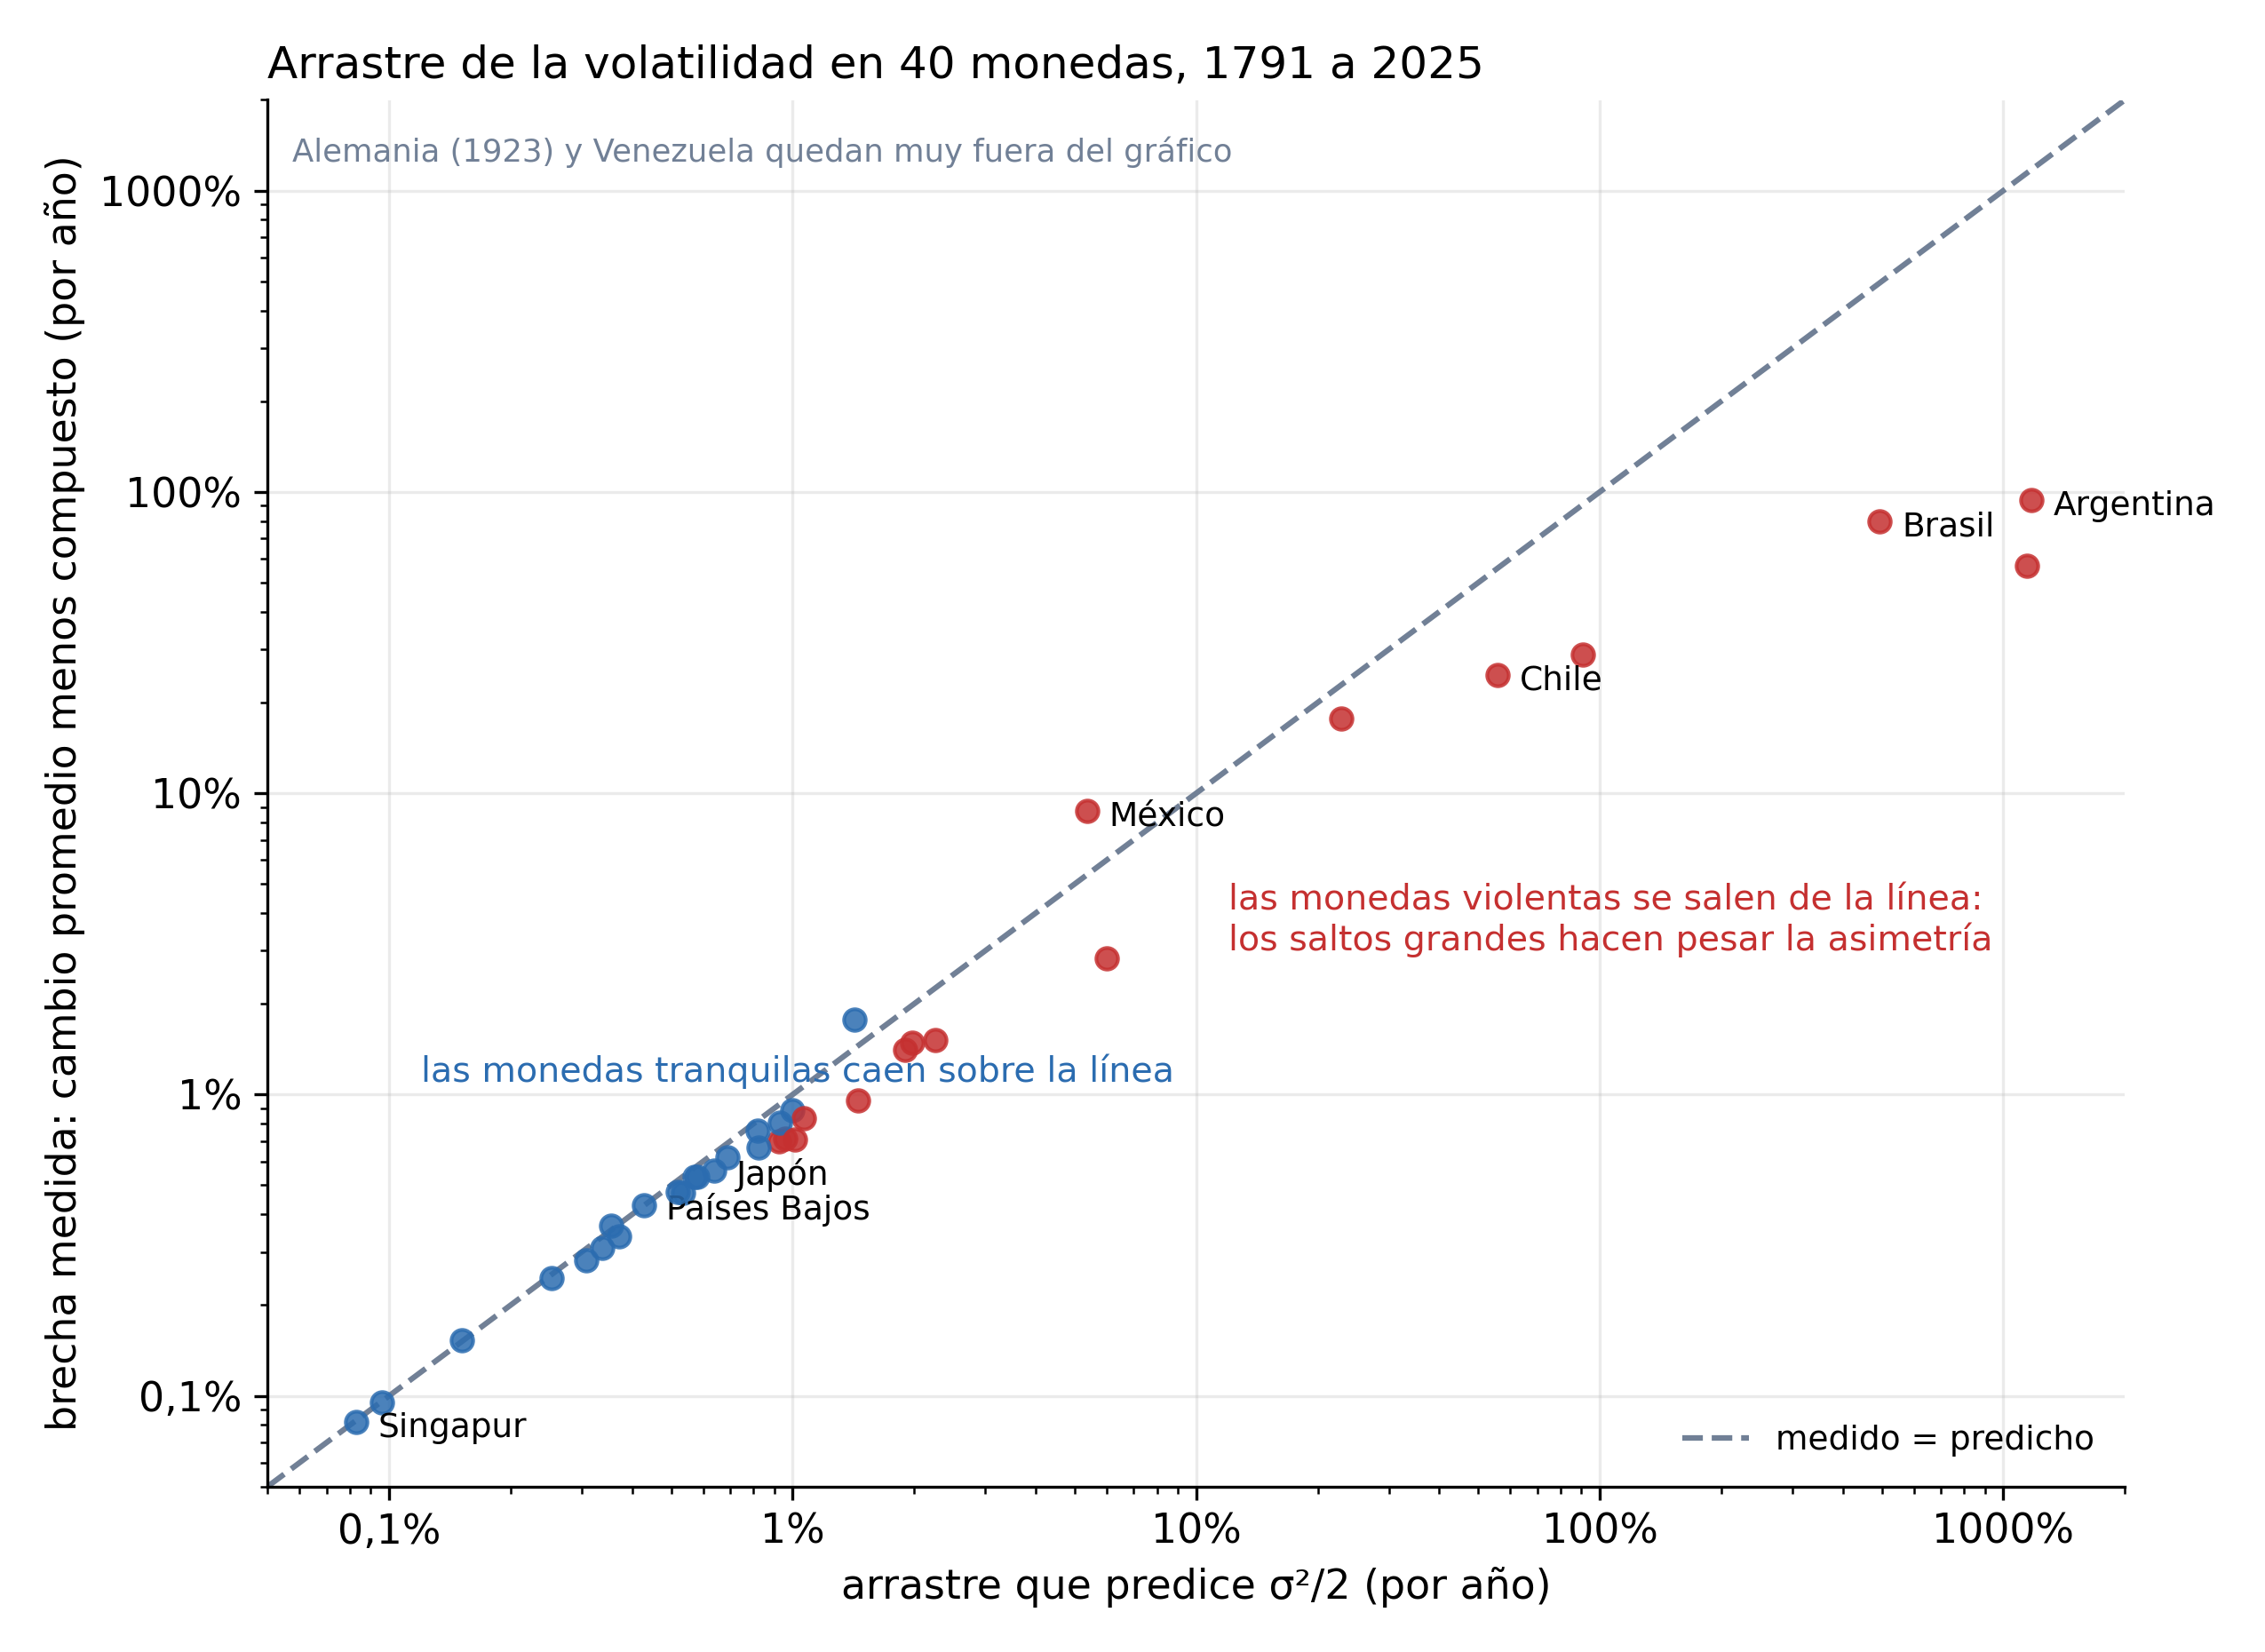
Cada punto es una moneda. Los puntos azules están a menos de 25% de la predicción, los rojos no.
Para las monedas tranquilas la coincidencia es casi exacta. Los Países Bajos muestran una brecha medida de 0,430% anual contra 0,429% predicho; Singapur, 0,082% contra 0,083%. Pasado un par de puntos por año, los puntos se salen de la línea. $\sigma^2/2$ es solo el término de segundo orden, y el siguiente, $+\mathbb{E}[R^3]/3$, se vuelve grande cuando los movimientos son grandes y asimétricos. Acá los movimientos grandes son devaluaciones, saltos en el precio del dólar, que tiran la brecha medida por debajo de la predicción. Para alguien que tiene pesos o reales, esos mismos saltos son pérdidas, y empujan el arrastre para el otro lado.
#Verificado en Lean
La fórmula está demostrada, no solo derivada, en lean-ergodicity. Para cualquier distribución finita de retornos menores al 100%, la tasa de crecimiento compuesta es $\mu - \sigma^2/2 - \mu^2/2$ salvo un error que el teorema acota explícitamente. El $\mu^2/2$ extra es el precio de trabajar en tiempo discreto y desaparece en la versión en tiempo continuo.
theorem volatility_drag (s : Finset ι) (w R : ι → ℝ)
    (hw : ∀ i ∈ s, 0 ≤ w i) (hsum : ∑ i ∈ s, w i = 1) (hR : ∀ i ∈ s, |R i| < 1) :
    |∑ i ∈ s, w i * log (1 + R i) -
        (mean s w R - variance s w R / 2 - mean s w R ^ 2 / 2)| ≤
∑ i ∈ s, w i * (|R i| ^ 3 / (1 - |R i|))#Los límites
La fórmula de $\sigma^2/2$ es una aproximación para retornos chicos y más o menos normales. Los retornos reales tienen colas pesadas, y los momentos superiores alejan el arrastre de $\sigma^2/2$ en las dos direcciones: las pérdidas grandes (asimetría negativa) lo empeoran, las ganancias grandes (asimetría positiva) lo achican, y una curtosis alta lo agranda. La cantidad exacta es siempre $\mathbb{E}[\ln(1+R)]$, y cuando una sola pérdida alcanza para fundirte, ninguna fórmula basada en la varianza lo captura. Del cero no se vuelve.
#Para seguir leyendo
- Las finanzas son geometría, y todo vuelve a la desigualdad de Jensen: la versión larga, con el desarrollo de Taylor, el lema de Itô, Kelly y las colas pesadas.
- La ergodicidad, explicada: la misma brecha vista como promedios temporales contra promedios de ensamble.
- La serie Leptokurtic: dos mil años de datos financieros, detección de crashes y cobertura de colas con opciones reales.
De la serie Una sola trayectoria.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.