Las finanzas son geometría, y todo vuelve a la desigualdad de Jensen
Los logaritmos, Kelly, la ergodicidad y el riesgo de cola se encuentran en la misma geometría: la riqueza se capitaliza de forma multiplicativa, el logaritmo es cóncavo y la desigualdad de Jensen mide el costo de la variabilidad.
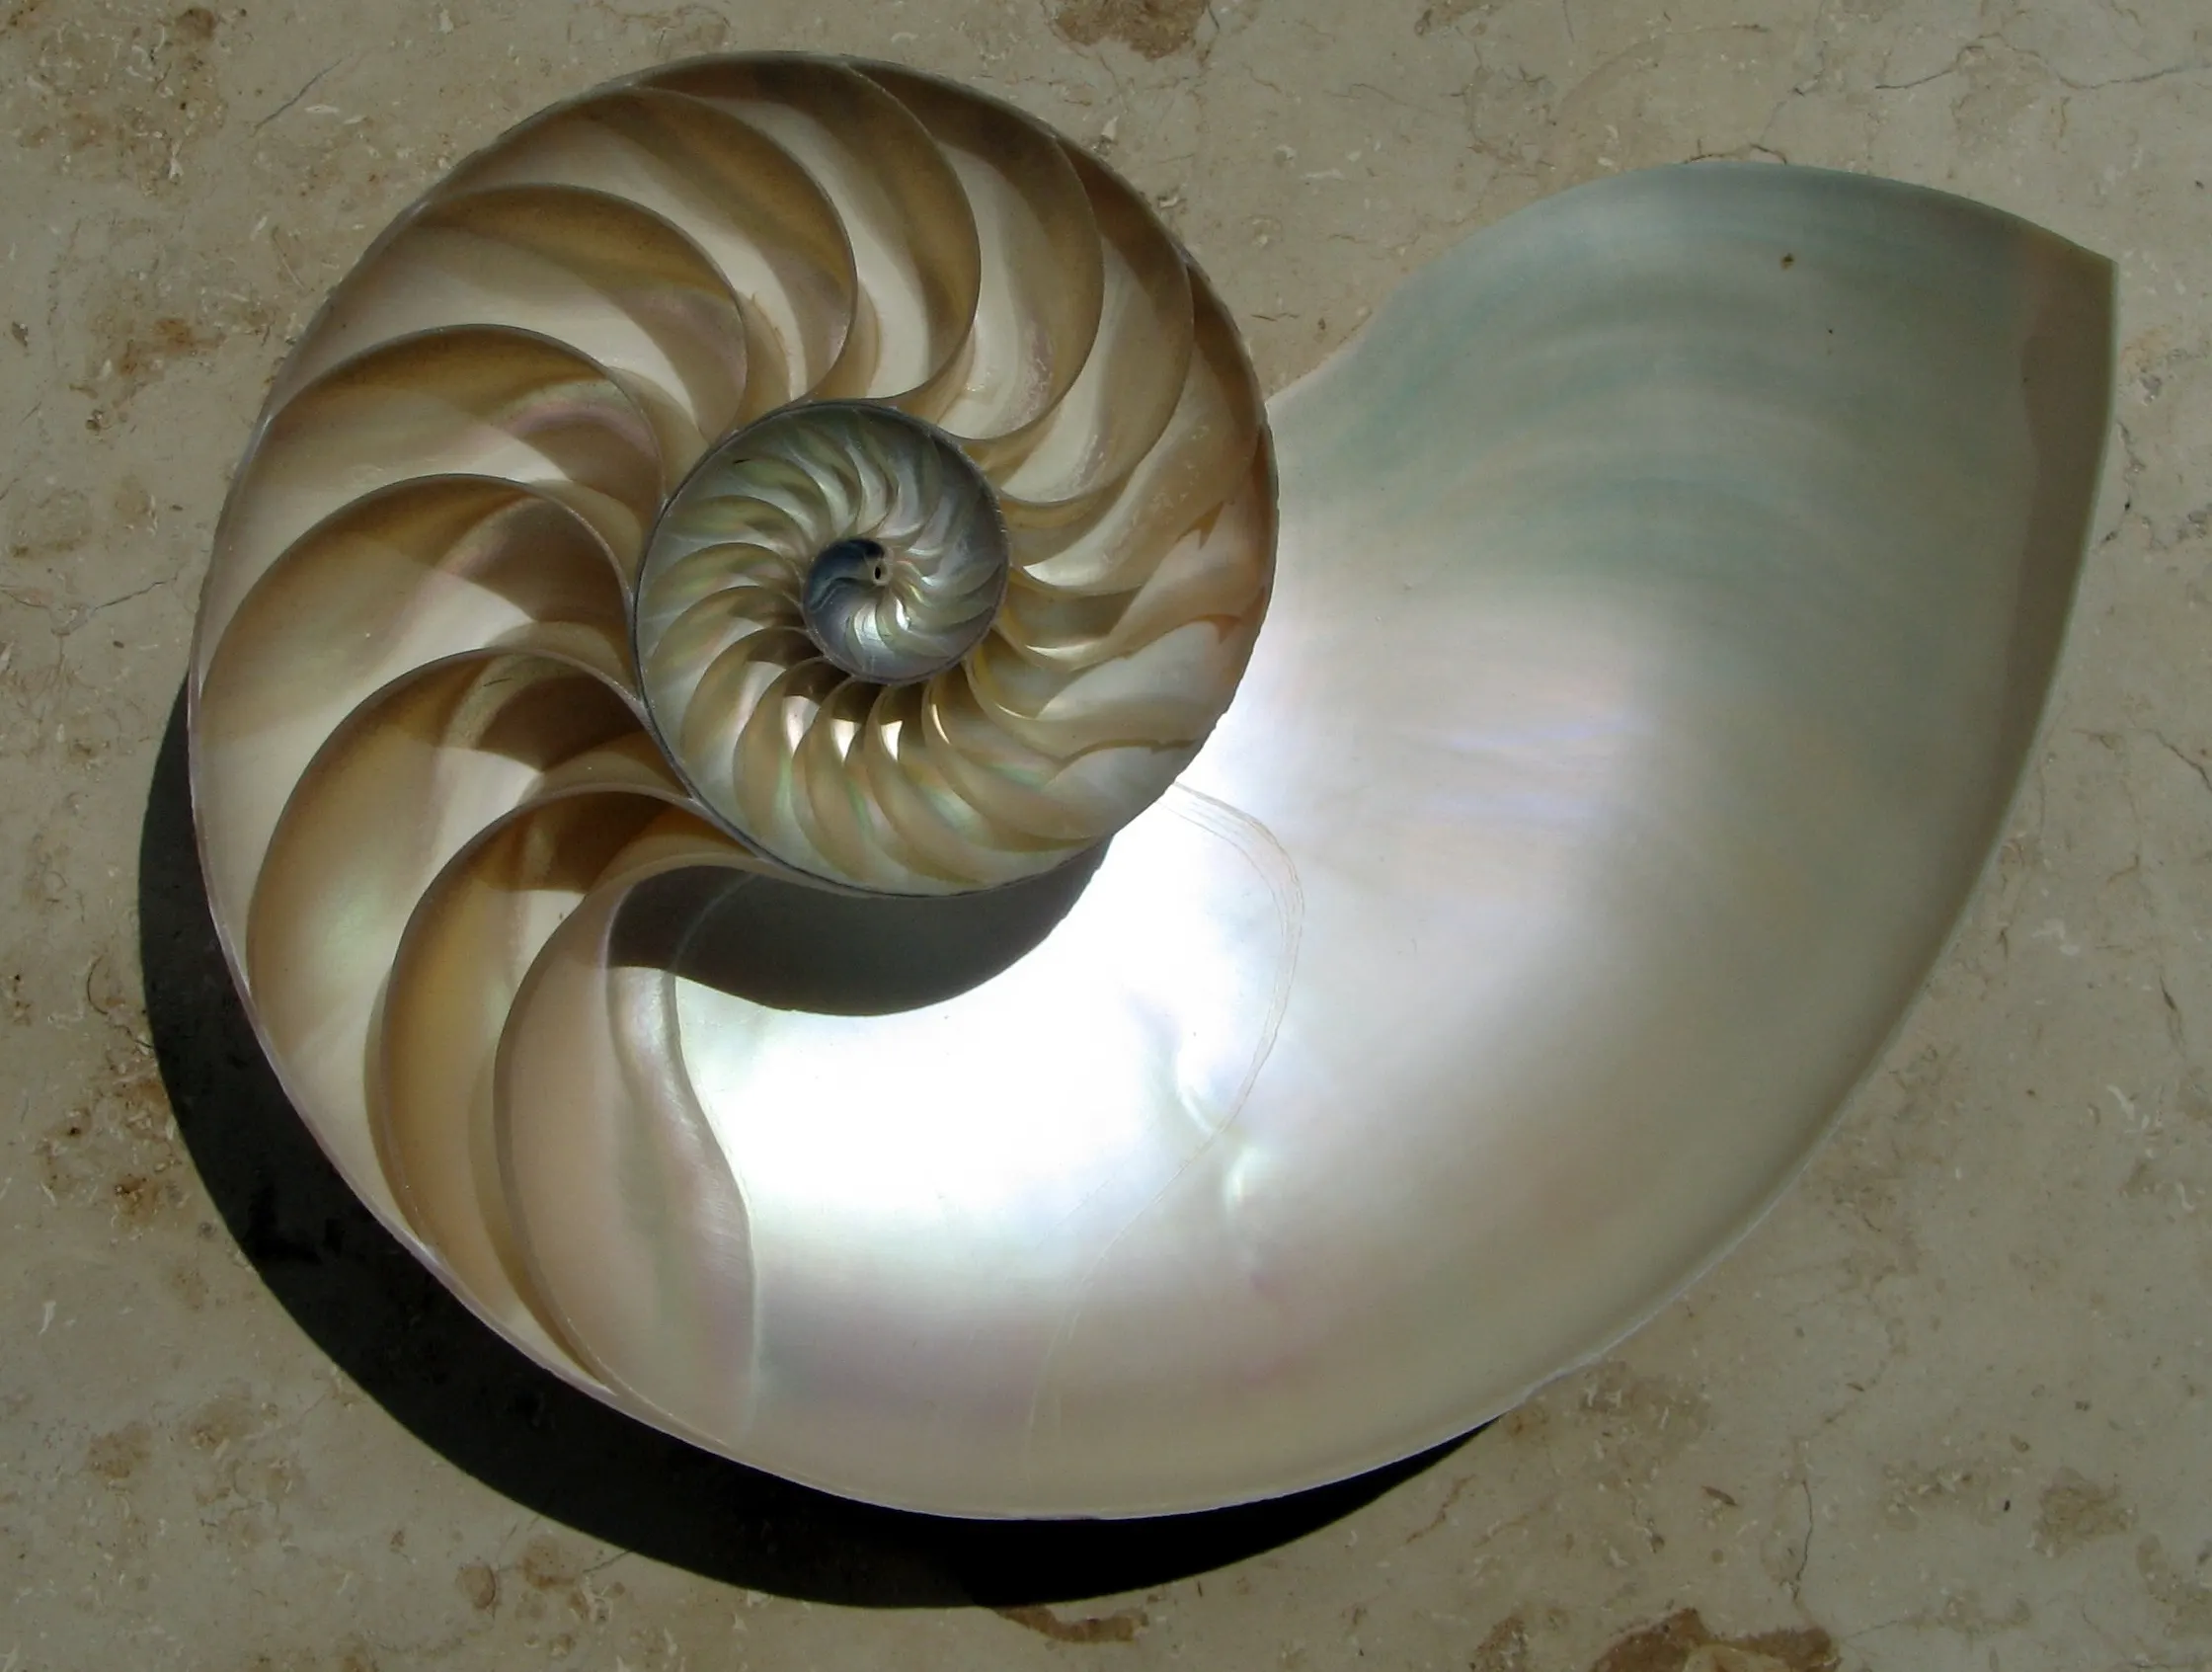
Sobre la imagen Cada cámara es la anterior escalada por el mismo factor, así que la concha crece por multiplicación y dibuja una espiral logarítmica. La riqueza se capitaliza de la misma manera, y por eso el logaritmo es la regla correcta para medirla. Una concha de nautilus cortada al medio para mostrar sus cámaras. Foto: Chris 73, CC BY-SA 3.0, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Nunca cruces un río que tiene en promedio cuatro pies de profundidad. Si el río tiene ocho pies de profundidad en el medio y está seco en los costados, el promedio no te dice nada sobre si te vas a ahogar. Te vas a ahogar en el medio, o no. No existe un promedio entre universos paralelos en los que sobrevivís y morís a la vez.
La misma asimetría aparece en todos lados donde los resultados se capitalizan. Si perdés el 50% de tu riqueza, necesitás una ganancia del 100% solo para salir hecho, porque la pérdida golpea sobre una base más grande que aquella desde la que se construye la recuperación. Pasar de $100 a $200 y de $200 a $400 son montos distintos en dólares pero el mismo movimiento proporcional: una duplicación. La riqueza es una cuestión de razones y de escala, no de diferencias absolutas.
Esta estructura multiplicativa tiene consecuencias más profundas de lo que sugiere la intuición. La matemática que gobierna la supervivencia en entornos de capitalización compuesta se inventó hace 400 años para ayudar a los astrónomos a multiplicar números grandes, se redescubrió en parte en el siglo XVIII para resolver una paradoja sobre el juego, se formalizó de nuevo a través de la teoría de la información y después quedó en gran medida tapada por teorías que optimizaban a través de mundos hipotéticos en lugar de a lo largo de un único camino en el tiempo.
Esa es la afirmación geométrica de este ensayo: la riqueza evoluciona de forma multiplicativa, mientras que la mayor parte de la intuición común es aditiva. El logaritmo es el cambio de coordenadas que nos permite movernos entre esas dos descripciones.
Esta es la historia de por qué la geometría está en el centro de las finanzas, de por qué una sola desigualdad ata todo el cuadro y de por qué reducir la varianza puede valer más que aumentar los retornos.
Ninguna de las partes es mía. Kelly, Peters, Spitznagel y Taleb resolvieron cada uno una de ellas. Lo único que afirmo es que son el mismo cuadro, y este ensayo muestra cómo encajan las piezas.
#I. La invención de la linealización (1614)
A principios del siglo XVII, los astrónomos se estaban ahogando en cálculos. Johannes Kepler acababa de publicar sus leyes del movimiento planetario, y los navegantes intentaban calcular posiciones con trigonometría esférica. Un solo problema podía requerir multiplicar dos números de siete dígitos, un proceso que a calculistas expertos les llevaba media hora y que era propenso a errores.
John Napier, un terrateniente escocés y matemático aficionado, pasó 20 años buscando una forma de simplificar esto. Su idea: si pudieras convertir la multiplicación en suma, los cálculos se volverían triviales. Inventó los “logaritmos” (del griego logos = razón, arithmos = número), una tabla que asignaba a cada número su “representante de razón”.
La propiedad crucial: $\log(ab) = \log(a) + \log(b)$. La multiplicación se vuelve suma. La división se vuelve resta. La potenciación se vuelve multiplicación.
Pero el invento de Napier era más que un truco de cálculo. Había descubierto la herramienta matemática para linealizar procesos multiplicativos. Cuatrocientos años después, esta misma herramienta iba a revelar por qué la volatilidad destruye riqueza y por qué funciona la cobertura de colas (tail hedging).
#II. El número que crece de forma continua (década de 1680)
En la década de 1680, Jacob Bernoulli investigó un acertijo financiero: si prestás plata a un interés anual del 100%, ¿qué pasa si lo capitalizás con más frecuencia?
- Anual: $(1 + 1)^1 = 2$
- Mensual: $(1 + 1/12)^{12} \approx 2.61$
- Diaria: $(1 + 1/365)^{365} \approx 2.71$
Bernoulli mostró que, a medida que el intervalo de capitalización se achica hacia cero, el resultado se acerca a un límite:
$$e = \lim_{n \to \infty} \left(1 + \frac{1}{n}\right)^n \approx 2.71828$$
El número que más tarde se denotó con $e$ surge naturalmente del crecimiento compuesto continuo. Es la base del logaritmo que mide tasas de crecimiento, el logaritmo “natural” $\ln(x)$. Donde Napier nos dio la herramienta para linealizar la multiplicación, Bernoulli identificó la constante que aparece cuando el crecimiento se vuelve continuo.
Juntos, Napier y Bernoulli dieron la base matemática: la riqueza crece de forma multiplicativa, y los logaritmos convierten ese crecimiento multiplicativo en incrementos aditivos.
#III. El avance de Jensen (1906)
El paso geométrico que faltaba llegó en 1906. El matemático danés Johan Jensen demostró la desigualdad que hoy lleva su nombre. Mostró que, siempre que una función es cóncava, promediar las entradas antes de aplicar la función da un resultado más grande que aplicar primero la función y después promediar.
Ese resultado suena abstracto, pero es exactamente el puente que necesita esta historia. Napier nos dio los logaritmos. Bernoulli mostró por qué el logaritmo natural le corresponde a la capitalización compuesta. Jensen explicó por qué la variabilidad hace daño una vez que la función relevante se curva hacia abajo.
#IV. La desigualdad de Jensen: la geometría de la concavidad
Una función es cóncava si se curva hacia abajo. Si trazás una línea recta entre dos puntos de la curva, esa línea queda por debajo de la curva misma. El logaritmo es cóncavo. Ese simple hecho geométrico resulta importar muchísimo en finanzas, porque la riqueza se capitaliza.
Hay una razón por la que el logaritmo es la función correcta acá, y no solo una cómoda: es la transformación que convierte la dinámica multiplicativa de la riqueza en incrementos aditivos que podés sumar a lo largo del tiempo. En el espacio de la riqueza en bruto, los retornos se multiplican. En el espacio logarítmico, se suman. La desigualdad de Jensen importa porque este cambio de coordenadas no es lineal: la transformación se curva hacia abajo, y esa curvatura es exactamente la razón por la que la dispersión de los retornos se vuelve un lastre para el crecimiento de largo plazo.
La desigualdad de Jensen dice que, para una función cóncava $\varphi$:
$$\mathbb{E}[\varphi(X)] \leq \varphi(\mathbb{E}[X])$$
La notación es simple una vez que la desarmás. $\mathbb{E}[X]$ significa el valor esperado, o promedio, de $X$. El símbolo $\varphi(X)$ significa “evaluar la función $\varphi$ en $X$”. Así que la desigualdad dice: para una función cóncava, el valor esperado de la variable transformada es menor o igual que el valor esperado transformado. La brecha entre esas dos cantidades es la brecha de Jensen (Jensen gap). Es la penalidad matemática que genera la variabilidad bajo concavidad.
Este es el ejemplo más simple posible. Supongamos que tu factor de riqueza es $1.5$ o $0.5$ con igual probabilidad. En otras palabras, o ganás el 50% o perdés el 50%.
- El factor de riqueza promedio aritmético es $(1.5 + 0.5)/2 = 1.0$
- El logaritmo de ese promedio es $\ln(1.0) = 0$
- Pero el promedio de los logaritmos es $\frac{\ln(1.5) + \ln(0.5)}{2} \approx -0.144$
Entonces el resultado promedio parece plano, pero el crecimiento logarítmico esperado es negativo. Bajo exposición repetida al mismo tipo de apuesta multiplicativa, eso significa que el crecimiento compuesto de largo plazo es negativo aunque el promedio aritmético parezca inofensivo. Esa es la desigualdad de Jensen en acción.

Todo el efecto en una sola imagen. Marcá los dos resultados en la curva, ×0.5 y ×1.5, y trazá la línea recta entre ellos. Promediar primero y después tomar el logaritmo cae sobre la curva en $\ln(1.0)=0$ (verde). Tomar primero el logaritmo y después promediar cae sobre la cuerda, por debajo, en alrededor de $-0.14$ (rojo). Como el logaritmo se curva hacia abajo, lo segundo siempre es más bajo. Esa brecha vertical es el costo de la varianza.
Para verlo de forma más visceral, arrancá con $100:
- Después de una ganancia del 50%: $$100 \times 1.5 = $150$
- Después de una pérdida del 50%: $$150 \times 0.5 = $75$
Terminás con $75, una pérdida total del 25%, a pesar de que el retorno promedio aritmético es cero. La pérdida se aplicó sobre una base más grande ($150) que la ganancia ($100), así que se llevó más de lo que la ganancia había sumado. La capitalización compuesta hace que la volatilidad salga cara.
Esta asimetría se generaliza. Un drawdown (caída desde máximos) y la ganancia necesaria para recuperarse de él no son simétricos:
- Perdés el 10%, necesitás +11,1% para salir hecho
- Perdés el 20%, necesitás +25% para salir hecho
- Perdés el 50%, necesitás +100% para salir hecho
- Perdés el 80%, necesitás +400% para salir hecho
Ese calendario de recuperación convexo es otra forma de ver la misma geometría. Las pérdidas dañan la base desde la que el crecimiento futuro tiene que capitalizarse.

La ganancia necesaria para salir hecho, graficada contra la pérdida. Si la recuperación fuera simétrica, seguiría la línea punteada. En cambio, se curva y se aleja: una pérdida del 10% necesita 11%, una del 50% necesita 100%, una del 80% necesita 400%. Cuanto más hondo el pozo, más desproporcionada la subida para salir, que es la misma concavidad vista desde el otro lado.
Apliquemos esto a la log-riqueza:
$$\mathbb{E}[\ln(1+R)] \leq \ln(1 + \mathbb{E}[R])$$
Acá $R$ significa el retorno en un período. Si ganás el 10%, entonces $R = 0.10$. Si perdés el 20%, entonces $R = -0.20$. La expresión $1+R$ es tu factor de riqueza, el número por el que se multiplica tu plata en ese período.
Esta expresión solo tiene sentido cuando $1+R > 0$. Los retornos por debajo de $-100%$ quedan fuera del modelo porque corresponden a la ruina.
El lado izquierdo es la tasa de crecimiento logarítmico promedio, que es lo que determina la capitalización compuesta de largo plazo. El lado derecho es el logaritmo de uno más el retorno promedio. La desigualdad es estricta siempre que los retornos varíen. Si los retornos fueran perfectamente constantes, los dos lados serían iguales. La variabilidad es lo que crea la brecha.
Esa distinción importa. La brecha de Jensen es el hecho geométrico general. El lastre de varianza (variance drag) es la aproximación de segundo orden a ese hecho cuando los retornos no son demasiado grandes.
Para estimar el tamaño de la brecha, desarrollá $\ln(1+R)$ en serie de Taylor alrededor del retorno medio $\mu$:
$$\ln(1+R) \approx \ln(1+\mu) + \frac{R-\mu}{1+\mu} - \frac{(R-\mu)^2}{2(1+\mu)^2} + …$$
Ahora tomá esperanzas término a término. Como $\mu = \mathbb{E}[R]$, tenemos $\mathbb{E}[R-\mu] = 0$, así que el término lineal desaparece. Y como $\sigma^2 = \mathbb{E}[(R-\mu)^2]$, el término cuadrático se vuelve la varianza. Eso da:
$$\mathbb{E}[\ln(1+R)] \approx \ln(1+\mu) - \frac{\sigma^2}{2(1+\mu)^2}$$
Para retornos chicos, y por lo tanto para $|\mu| \ll 1$, podemos usar $\ln(1+\mu) \approx \mu$ y $(1+\mu)^2 \approx 1$. Entonces esto se simplifica a:
$$G \approx \mu - \frac{\sigma^2}{2}$$
Acá $\mu$ es el retorno medio aritmético, $\sigma^2$ es la varianza de los retornos y $G$ es la tasa de crecimiento geométrico aproximada. Así que la tasa de crecimiento geométrico es aproximadamente igual a la media aritmética $\mu$ menos la mitad de la varianza. El lastre de varianza es literalmente el término de segundo orden del desarrollo de Taylor de una función cóncava.
Esta es la desigualdad de Jensen apareciendo en una forma fácil de calcular. Como el logaritmo es cóncavo, la varianza baja el retorno logarítmico esperado. Una cartera con $\mu = 10%$ y $\sigma = 20%$ tiene un crecimiento geométrico de aproximadamente $8%$, lo que significa un lastre anual del 2% solo por la volatilidad.
En las finanzas en tiempo continuo, el mismo efecto aparece como el término de corrección de Itô en el movimiento browniano geométrico. Por eso el crecimiento logarítmico esperado queda por debajo de la deriva aritmética en aproximadamente $\sigma^2/2$ también ahí.
Si escribís la riqueza como
$$\frac{dW_t}{W_t} = \mu,dt + \sigma,dB_t$$
entonces el lema de Itô da
$$d\ln W_t = \left(\mu - \frac{\sigma^2}{2}\right)dt + \sigma,dB_t$$
El término de deriva de la log-riqueza no es $\mu$ sino $\mu - \sigma^2/2$. En otras palabras, el mismo “lastre de varianza” que apareció más arriba como un efecto local de Jensen aparece de forma exacta en el modelo canónico de las finanzas en tiempo continuo.
Si querés ver la diferencia en números, una simple simulación de trayectorias hace visible la brecha:

La línea roja es la esperanza aritmética. La línea azul es la esperanza geométrica. La línea dorada sigue una trayectoria realizada más típica. Las líneas grises tenues son trayectorias de muestra. Todas arrancan desde la misma riqueza, pero el promedio aritmético se va por encima de la trayectoria que la mayoría de los inversores realmente vive.
Los números exactos cambian de una corrida a otra, pero el patrón es estable: los promedios aritméticos se ven mejor que los geométricos, y la riqueza final mediana típicamente queda por debajo de la media aritmética porque la capitalización compuesta castiga la volatilidad trayectoria por trayectoria.
#V. El criterio de Kelly: optimización bajo concavidad
El criterio de Kelly es la consecuencia, en términos de optimización, de la geometría que acabamos de describir. La desigualdad de Jensen dice que la concavidad del logaritmo penaliza la varianza. Kelly pregunta: dada esa penalidad, ¿qué nivel de exposición maximiza el crecimiento logarítmico esperado? La respuesta pone la varianza directamente en el denominador.
Mucho antes de Kelly, Daniel Bernoulli ya se había movido en la dirección correcta. En 1738, en su análisis de la paradoja de San Petersburgo, propuso la utilidad logarítmica. No lo planteó en términos de promedios temporales ni de ergodicidad, pero vio correctamente que el valor del dinero no es lineal y que el riesgo multiplicativo cambia el problema.
El trabajo de Claude Shannon es fundamental acá. En 1948, Shannon creó la teoría de la información, un marco matemático para razonar sobre señal, ruido y transmisión. La idea profunda es que la información se puede medir, que la incertidumbre tiene estructura y que una mejor información cambia cómo se ve una decisión repetida óptima. Esa es la base intelectual sobre la que se para Kelly.
En el marco de Shannon, la información tiene valor operativo porque mejora tu capacidad de actuar bajo incertidumbre. La idea central de Kelly fue tomar esa lógica y aplicarla a las apuestas y a la asignación de capital. Si la información mejora la calidad de tu ventaja, entonces hay una forma óptima de convertir esa ventaja en crecimiento compuesto de la riqueza.
En 1956, John Larry Kelly Jr., investigador de Bell Labs, derivó la estrategia de apuestas óptima para un apostador con una línea privada que le daba información ruidosa sobre carreras de caballos. Su derivación salió directamente de la teoría de la información de Shannon, la matemática de la transmisión de señales a través de canales ruidosos.
Kelly maximizó el logaritmo esperado de la riqueza porque la riqueza se capitaliza de forma multiplicativa, y el logaritmo convierte eso en tasas de crecimiento aditivas que se pueden promediar en el tiempo.
El criterio de Kelly maximiza:
$$G = \mathbb{E}[\ln(W_t/W_{t-1})]$$
Acá $W_t$ significa tu riqueza en el momento $t$. Entonces $W_t/W_{t-1}$ es simplemente “cuánto cambió tu riqueza en este período”, y el logaritmo convierte ese cambio multiplicativo en algo que podés sumar a lo largo del tiempo.
Para una apuesta simple con probabilidad $p$ de ganar, cuota $b$ y probabilidad $q=1-p$ de perder, la fracción óptima $f^*$ de la riqueza a apostar es:
$$f^* = \frac{pb - q}{b} = \frac{p(b+1) - 1}{b}$$
Para retornos continuos, donde $\mu$ es el retorno esperado, $r$ es la tasa libre de riesgo y $\sigma^2$ es la varianza, la fracción de Kelly pasa a ser:
$$f^* = \frac{\mu - r}{\sigma^2}$$
Fijate qué aparece en el denominador: la varianza. La fórmula de Kelly muestra explícitamente que el tamaño óptimo de la posición depende de la razón entre la ventaja y la varianza. Una estrategia con el doble de ventaja pero el doble de varianza recibe la misma asignación que la original. Acá la varianza hace más que medir el “riesgo”: fija directamente el tamaño de la posición óptima.
Bajo los supuestos habituales de apuesta favorable, apostar según Kelly hace crecer la riqueza más rápido que cualquier otra estrategia de fracción fija en el largo plazo, y domina a las alternativas con una probabilidad que tiende a 1 a medida que el tiempo tiende a infinito.
Edward O. Thorp fue quien llevó esto de la teoría a la práctica. Usó razonamientos al estilo Kelly primero en el blackjack y después en los mercados, y mostró que el dimensionamiento log-óptimo era una regla de decisión aplicable bajo incertidumbre además de un teorema elegante.
Leo Breiman le dio al resultado una de sus formulaciones matemáticas más claras. En 1961, mostró que la estrategia log-óptima domina asintóticamente a las estrategias alternativas bajo condiciones amplias. Kelly dio la regla. Thorp la hizo operativa. Breiman ayudó a precisar la afirmación de largo plazo.
Thomas Cover llevó la idea más lejos. Su trabajo sobre carteras universales (universal portfolios) mostró que podés acercarte al desempeño de largo plazo de la mejor cartera de rebalanceo constante vista en retrospectiva sin conocer de antemano la verdadera distribución de los retornos. Esto extiende la lógica de Kelly de “¿cuál es la fracción óptima si conozco la ventaja?” a “¿cómo me adapto hacia el crecimiento log-óptimo cuando el mundo es incierto y mis estimaciones son imperfectas?”. Es uno de los puentes más limpios entre la optimalidad del crecimiento y el aprendizaje.
Robert Fernholz extendió la visión geométrica en otra dirección a través de la teoría estocástica de carteras (stochastic portfolio theory). Su aporte fue mostrar que el desempeño relativo de una cartera puede surgir de la estructura misma del mercado, la diversidad, el rebalanceo y la geometría de los flujos de capital, y no solo de pronosticar retornos esperados. Refuerza el mismo punto: en un mundo multiplicativo, los resultados de una cartera los moldean la estructura de la trayectoria y la mecánica de la capitalización compuesta, no solo las esperanzas estáticas de un período.
#Kelly fraccional
Los profesionales rara vez usan Kelly completo. La fracción óptima maximiza la tasa de crecimiento pero produce una volatilidad extrema, y los drawdowns del 50% o más son comunes. En su lugar, usan medio Kelly o un cuarto de Kelly:
$$f_{half} = \frac{f^*}{2}$$
Bajo la aproximación local estándar alrededor del óptimo de Kelly, esto reduce la tasa de crecimiento en alrededor del 25% pero corta la volatilidad a la mitad. También da un margen de seguridad contra el error de estimación. Si tu estimación de $\mu$ o de $\sigma$ está mal, Kelly completo puede ser catastrófico. Kelly fraccional es el reconocimiento de que maximizar el crecimiento geométrico es el objetivo, pero la incertidumbre de estimación exige humildad.
#VI. Economía de la ergodicidad: tiempo vs. conjunto
En 2019, el físico Ole Peters publicó un paper en Nature Physics que debería haber forzado un debate mucho más afilado sobre los fundamentos de la teoría de la decisión. Peters es una de las figuras modernas centrales en el argumento de este artículo porque redefine el objetivo en lugar de agregar otro modelo de riesgo. Su programa de investigación más amplio, incluido trabajo anterior con Alexander Adamou, mostró que la teoría de la utilidad esperada, el fundamento de la economía moderna, descansa sobre el supuesto implícito de ergodicidad.
Para entender la fuerza de esa crítica, ayuda nombrar el punto de referencia. En 1944, John von Neumann y Oskar Morgenstern formalizaron la teoría de la utilidad esperada en Theory of Games and Economic Behavior. Su marco pregunta qué acción maximiza la utilidad promedio entre los posibles estados del mundo. Se convirtió en el lenguaje matemático dominante de la elección racional. La crítica de Peters apunta a este punto de referencia formal, no a una intuición vaga.
Un proceso es ergódico si el promedio temporal es igual al promedio de conjunto (ensemble average). En los sistemas ergódicos, promediar entre muchas realizaciones paralelas da el mismo resultado de largo plazo que seguir una sola realización a lo largo del tiempo.
El crecimiento de la riqueza no es ergódico. Pensá en una apuesta que multiplica tu riqueza por $1.5$ si sale cara y por $0.6$ si sale ceca, cada una con probabilidad un medio. Promediada entre muchas personas apostando en paralelo, la riqueza crece: el factor promedio de conjunto es $0.5 \times 1.5 + 0.5 \times 0.6 = 1.05$, una ganancia del 5% por ronda. Pero una sola persona que apuesta repetidamente casi con seguridad se funde, porque el factor de crecimiento del promedio temporal es $\sqrt{1.5 \times 0.6} = \sqrt{0.9} \approx 0.95$, una pérdida de alrededor del 5% por ronda. El conjunto parece una apuesta ganadora. La trayectoria vivida es la ruina.
Acá es donde la distinción entre optimalidad de conjunto y optimalidad de trayectoria se vuelve decisiva. Una estrategia puede parecer óptima cuando promediás entre muchos mundos paralelos y aun así ser desastrosa para una persona que vive una única secuencia realizada de resultados.
En el planteo de Peters y Adamou, la teoría estándar de la utilidad esperada evalúa las elecciones entre los posibles estados del mundo, mientras que los inversores individuales viven una sola trayectoria en el tiempo. No tienen acceso a universos paralelos en los que a la vez sobrevivieron y quebraron.
El aporte de Adamou importa acá porque el trabajo conjunto de Peters y Adamou hizo más que reformular en abstracto la objeción de la ergodicidad: usó paradojas concretas, sobre todo la paradoja de San Petersburgo, para mostrar cómo cambiar la resolución temporal del problema cambia lo que cuenta como una decisión racional. Eso volvió concreta la interpretación del promedio temporal en lugar de meramente filosófica.
La corrección es simple: maximizar la tasa de crecimiento del promedio temporal. Esto es exactamente el criterio de Kelly. La utilidad logarítmica que Daniel Bernoulli inventó para resolver la paradoja de San Petersburgo en 1738 era correcta, pero los economistas olvidaron por qué: surge naturalmente de la no ergodicidad del crecimiento multiplicativo.
La desigualdad de Jensen es lo que hace que los dos promedios sean distintos. Como el logaritmo es cóncavo, el crecimiento logarítmico esperado (el promedio temporal) siempre es menor que el logaritmo del crecimiento esperado (el promedio de conjunto). La brecha entre ellos es la brecha de Jensen de la Sección IV. La no ergodicidad es lo que convierte esa brecha en una cuestión de supervivencia y no en un tecnicismo: te capitalizás a lo largo de una trayectoria, no a través de todas las trayectorias posibles.
Esto también aclara el límite del pensamiento de media-varianza. El marco de Markowitz es útil como primera aproximación, pero trata el riesgo como un intercambio entre el retorno promedio y la dispersión en un único período. Por sí solo no codifica la asimetría de la capitalización compuesta en el tiempo ni la importancia especial de la ruina.
Paul Samuelson pasó años argumentando en contra de extender demasiado la lógica de Kelly. Sus objeciones no eran triviales: obligaron a poner sobre la mesa la distinción entre maximizar la utilidad esperada y maximizar el crecimiento de largo plazo. Aunque al final uno se ponga del lado de Kelly y Peters para la riqueza multiplicativa, Samuelson es parte de la razón por la que el debate se volvió intelectualmente afilado.
#VII. Barreras absorbentes y el río
La analogía del río de Taleb hace visceral la matemática:
Nunca cruces un río que tiene en promedio cuatro pies de profundidad.
Si el río tiene ocho pies de profundidad en el medio y está seco en los costados:
- Media aritmética: $(0 + 8)/2 = 4$ pies, lo que parece seguro
- Restricción real: si medís menos de ocho pies, la parte honda te mata igual
La profundidad promedio del río es irrelevante. Lo que importa es si algún punto del camino es lo bastante hondo como para matarte. La misma lógica se aplica a la riqueza multiplicativa: un solo resultado ruinoso importa más que un promedio tomado entre trayectorias paralelas hipotéticas.
Matemáticamente, el cero es una barrera absorbente. Si la riqueza llega a cero, el proceso se detiene. No te podés recuperar. La media aritmética ignora esto porque promedia entre trayectorias en las que sobreviviste y trayectorias en las que moriste. La media geométrica, a través del logaritmo, le asigna al cero una utilidad infinitamente negativa: $\ln(0) = -\infty$.
Por eso el dimensionamiento log-óptimo penaliza fuertemente las estrategias que te exponen a la ruina. La concavidad del logaritmo hace que la ruina sea infinitamente peor de lo que cualquier ganancia potencial puede compensar, y por eso el dimensionamiento de Kelly en la práctica siempre está restringido por la posibilidad de una pérdida catastrófica.
#VIII. Colas pesadas y momentos superiores
El desarrollo de Taylor de $\ln(1+R)$ no supone normalidad: es un desarrollo local que sirve cuando los retornos son lo bastante chicos y los momentos relevantes existen. Pero los retornos financieros viven en Extremistán (el término de Taleb para los dominios gobernados por distribuciones de colas pesadas, o fat tails), donde los eventos extremos son mucho más probables de lo que predice la distribución normal.
El matemático Benoit Mandelbrot es la figura fundacional acá. Mucho antes que Taleb, Mandelbrot sostuvo que los precios especulativos no se comportan como prolijas variables gaussianas. Saltan, se agrupan y producen movimientos extremos mucho más seguido de lo que sugerirían los modelos clásicos. Una vez que eso es cierto, la aproximación simple basada en la varianza ya no alcanza. Las colas empiezan a dominar la economía del asunto.
El físico Jean-Philippe Bouchaud llevó esta crítica más lejos al sostener que el cuadro estándar de equilibrio de los mercados es demasiado limpio. Su aporte distintivo es conectar las colas pesadas con la microestructura del mercado y la dinámica de masas. Los precios los moldean el amontonamiento de posiciones, la retroalimentación, el impacto de mercado y la estructura institucional, además de las distribuciones alrededor de una media estable. El riesgo de cola está incorporado en cómo funcionan realmente los mercados, no es solo una molestia estadística.
El físico Didier Sornette agrega otra capa. Modela las burbujas y los crashes como fenómenos críticos endógenos generados por la retroalimentación positiva, la imitación y una estructura de mercado inestable. En su marco, algunos de los crashes más grandes son el punto final natural de un sistema que se volvió reflexivo y frágil, no rayos aleatorios caídos del cielo.
Cuando los retornos tienen colas pesadas, los momentos superiores importan. La forma más limpia de verlo es desarrollar el logaritmo directamente alrededor de $R=0$. Para $|R|<1$,
$$\ln(1+R) = R - \frac{R^2}{2} + \frac{R^3}{3} - \frac{R^4}{4} + …$$
Tomar esperanzas da
$$\mathbb{E}[\ln(1+R)] = \mathbb{E}[R] - \frac{1}{2}\mathbb{E}[R^2] + \frac{1}{3}\mathbb{E}[R^3] - \frac{1}{4}\mathbb{E}[R^4] + …$$
Esta versión es más explícita que la fórmula abreviada de media-varianza. El segundo momento entra con signo negativo, así que la dispersión daña el crecimiento. El tercer momento bruto entra con signo positivo, y por eso la asimetría positiva tiende a ayudar y la asimetría negativa tiende a dañar. El cuarto momento bruto también entra con signo negativo, lo que significa que los movimientos extremos grandes, sean positivos o negativos, reducen el crecimiento logarítmico esperado salvo que se compensen en otra parte de la distribución. En la práctica, eso significa que el cuadro simple de media y varianza deja de alcanzar una vez que los movimientos extremos se vuelven comunes.
En sentido estricto, estos son momentos brutos, no la asimetría y la curtosis propiamente dichas. Pero la intuición coincide con las versiones estandarizadas: la asimetría importa, y el grosor de las colas importa. Si quisieras escribir la misma lógica de forma más limpia, los cumulantes muchas veces serían el mejor lenguaje. El punto es el mismo de cualquier manera: una vez que los momentos superiores se vuelven grandes, la abreviatura de media-varianza pierde poder explicativo.
Los modelos estándar de valuación de opciones (Black-Scholes) suponen retornos log-normales con colas livianas. En la práctica, los traders corrigen esto en parte con las sonrisas y los sesgos de volatilidad, pero cualquier marco que se quede demasiado cerca de un mundo de colas livianas va a seguir subestimando la probabilidad de movimientos extremos. La frecuencia exacta de los crashes importa menos que la implicancia más amplia: los eventos de la cola izquierda ocurren bastante más seguido de lo que sugiere una calibración gaussiana ingenua.
La estrategia barbell de Taleb es la respuesta filosófica práctica a toda esta sección. Su punto central va más allá de afirmar que las colas son más pesadas de lo que admiten los modelos estándar: la respuesta correcta a un mundo de colas pesadas es organizar una cartera de modo que los resultados comunes sean sobrevivibles y las dislocaciones extraordinarias se vuelvan oportunidades en lugar de amenazas existenciales. Una barbell hace exactamente eso: la mayor parte del capital está en posiciones robustas al ruido común, mientras que una asignación chica compra convexidad extrema.
Esa estructura importa porque cambia la forma misma de la distribución de retornos. Los puts tienen una pérdida acotada (la prima pagada) y una ganancia muy grande en los crashes. Eso genera asimetría positiva, limita la exposición a los estados ruinosos de la cola izquierda y preserva la posibilidad de grandes ganancias cuando el sistema se rompe. En términos de Jensen y Kelly, el aporte de Taleb es insistir en que el objetivo es sobrevivir y capitalizarse en un mundo discontinuo, no maximizar un promedio suave en uno que se porta bien.
El economista Hyman Minsky también pertenece a este cuadro. Su idea central era que la estabilidad engendra fragilidad. Los períodos largos de calma fomentan el apalancamiento, los descalces de plazos y las posiciones amontonadas, lo que hace que la ruptura final sea mucho más violenta. Ese es exactamente el tipo de entorno en el que los resultados promedio se ven benignos hasta el momento en que llega la cola izquierda. Mandelbrot, Bouchaud, Sornette y Minsky empujan todos en la misma dirección: la cola izquierda es parte de la estructura misma del mundo, no una pequeña corrección a una línea de base tranquila.
Vale la pena ser preciso sobre qué es lo que hace el trabajo acá, porque hay dos hechos en juego, no uno. La concavidad, el efecto Jensen, dice que la variabilidad es costosa. Las colas pesadas dicen que la variabilidad es más grande y más unilateral de lo que supone un mundo gaussiano. Lo primero es geometría; lo segundo es un hecho sobre la distribución sobre la que actúa esa geometría. La cobertura de colas importa porque las dos cosas son ciertas a la vez: la penalidad por la dispersión es real, y la dispersión es más grande de lo que admite el libro de texto.
#IX. La estrategia de puts como óptima según Jensen
La cobertura de cola de Spitznagel, 100% SPY más puts muy fuera del dinero (deep OTM), es donde la lógica abstracta se vuelve una cartera concreta. La mejor forma de entenderla es como dos patas que hacen trabajos distintos.
El motor de crecimiento. La primera pata es la exposición completa al mercado: 100% SPY. Esta es la parte que se capitaliza. Sola, también carga con toda la cola izquierda, y como mostraron las secciones anteriores, la cola izquierda es la que le hace un daño desproporcionado al crecimiento de largo plazo. El motor de crecimiento aporta la exposición al mercado y la mayor parte del retorno aritmético; por sí solo no hace nada respecto del lastre de varianza y del riesgo de ruina que impone la concavidad.
El overlay convexo. La segunda pata es una asignación chica a opciones de venta (puts) muy fuera del dinero. La mayor parte del tiempo vencen sin valor. En un crash pagan muchas veces la prima. Su trabajo es truncar la cola izquierda, eliminando los estados que la capitalización compuesta castiga más; sumar retorno en promedio no es el punto. Esta es la pata que se ocupa de la geometría de la que trata el resto del artículo.

Las dos patas y su suma. SPY solo (azul) es exposición lineal pura: carga con toda la cola izquierda. El put deep OTM (rojo) cuesta una prima chica la mayor parte del tiempo y paga solo en un crash. Sumalos y obtenés el overlay (verde): conserva la suba, menos la prima, pero su cola izquierda tiene un piso. El motor de crecimiento se capitaliza; el overlay convexo elimina los estados que más daño le hacen a esa capitalización.
En lugar de simplemente comprar un seguro contra desastres en el sentido convencional, Spitznagel toma la cadena completa, capitalización compuesta, concavidad, lastre de varianza, colas pesadas y no ergodicidad, y la convierte en una regla concreta de asignación de capital. Por eso es central para este argumento y no un ejemplo opcional de un profesional. Muchos inversores entienden las palabras “colas pesadas” y aun así arman carteras como si los crashes fueran solo drawdowns desagradables alrededor de una media estable. El aporte de Spitznagel es llevar la implicancia hasta el final: si la cola izquierda domina los resultados de largo plazo, entonces la convexidad pertenece al núcleo de la arquitectura de la cartera, no a un agregado cosmético atornillado por afuera.
Incluso en la aproximación de segundo orden más simple, el mecanismo es claro. Recordá la fórmula aproximada de crecimiento:
$$G \approx \mu - \frac{\sigma^2}{2}$$
Las dos patas se corresponden con los dos términos. El motor de crecimiento aporta $\mu$. El overlay trabaja sobre el segundo término:
- El costo: los puts tienen retorno esperado negativo, ya que normalmente vencen sin valor. Esto reduce $\mu$ en la prima pagada, digamos 0,5% anual.
- El beneficio: en un crash, los puts pueden pagar muchas veces la prima, truncando la cola izquierda. En una aproximación local, eso reduce el término efectivo de varianza. Más importante todavía, elimina los estados más destructivos para la capitalización futura.
Como el lastre de varianza es cuadrático en la aproximación local, una reducción modesta del riesgo de cola puede pesar más que un costo lineal de prima. Pero esa es la parte condicional de la afirmación, y vale la pena decirla sin vueltas. Jensen y Kelly explican por qué reducir el daño de la cola izquierda puede valer lo que cuesta. No garantizan que un put en particular valga su precio. La operación funciona solo si la convexidad es lo bastante barata en relación con la protección que compra, y solo si se implementa con disciplina: elección del strike (precio de ejercicio), mecánica del roll, dimensionamiento y una lectura de cuán persistentemente el mercado subvalúa el riesgo de la cola izquierda. La matemática te dice qué buscar. No promete que el mercado lo esté ofreciendo ahora.
Acá es también donde se encuentran Taleb y Spitznagel. Taleb aporta la doctrina filosófica y estadística: evitar la ruina, respetar las discontinuidades, buscar convexidad. Spitznagel aporta la expresión de esa doctrina en una cartera: mantener el motor de crecimiento y después agregar una estructura convexa chica que cambia lo que pasa en los peores estados. La combinación es lo que hace que la cobertura de colas sea más que una apuesta por miedo. Se vuelve una estrategia de capitalización compuesta.
#X. Más allá de las acciones: dónde la convexidad es más barata
La estrategia de puts sobre SPY funciona, pero puede no ser óptima. La misma lógica de Jensen y Kelly se aplica en cualquier lugar donde haya una asimetría confiable entre la calma y la crisis:
- Tasas: los bancos centrales recortan de forma agresiva en las crisis (alrededor de 500 pb en 2007–08, 150 pb en dos semanas durante el COVID). Los calls OTM sobre futuros de SOFR pueden capturar esos recortes de pánico con un bajo costo de mantenimiento (carry), aunque la estanflación rompe la tesis.
- Carry de monedas: monedas como AUD/JPY ofrecen un carry anual del 3-5% que se desarma de forma violenta en los eventos de aversión al riesgo (risk-off) (AUD/JPY cayó de más de 104 en julio de 2008 a cerca de 55 en octubre). El propio carry puede financiar puts OTM sobre la moneda de alto rendimiento.
- Crédito: los bonos con grado de inversión (IG) cobran spread, pero los eventos de crédito se agrupan. La protección con CDS es convexa: los spreads del CDX IG pasaron de alrededor de 50 pb a mediados de los 200 en 2008, mientras que el CDX HY pasó de unos pocos cientos hacia la zona de 1.500–1.600 pb. La barbell es cobrar el spread IG y comprar protección con CDS HY.
- Materias primas: el petróleo se arrastra en un rango estrecho y después se dispara por encima de $140 o se desploma a la zona de los $30. Los strangles deep OTM capturan las dos colas, aunque los shocks de oferta hacen del crudo una cobertura más ruidosa que las otras.
La idea de Universa es recorrer estos mercados buscando dónde la convexidad de cola está más barata ahora mismo. A veces es la volatilidad de acciones, a veces el crédito, a veces las tasas. El artículo anterior desarrolla cada mercado con más detalle, con estructuras de operaciones concretas, contraejemplos y notas de implementación.
#XI. Cómo encaja esto en la serie
Las tres piezas anteriores de la serie Leptocúrtico parecían separadas, pero son todas instancias de la misma estructura. Veinte siglos de datos financieros estableció el telón de fondo empírico: las colas pesadas, las devaluaciones y los cambios de régimen son la línea de base histórica, no anomalías modernas. Detectar crashes con estadística de colas pesadas pasó al diagnóstico en vivo, mostrando que los crashes tienen precursores detectables y un comportamiento de cola que las herramientas estándar no ven. El debate sobre la cobertura de colas puso a prueba el overlay de puts con datos reales de opciones sobre SPY y encontró que la convexidad muy fuera del dinero puede mejorar la trayectoria realizada de una cartera cuando se financia y se dimensiona como describe Spitznagel. Esas tres aportaron los datos, el diagnóstico y la implementación; esta aporta la matemática que las conecta.
Vale la pena ser explícito sobre la división del trabajo. La desigualdad de Jensen es el núcleo geométrico, pero no es toda la historia por sí sola. Jensen explica por qué la concavidad penaliza la variabilidad. Kelly convierte eso en una regla de dimensionamiento. La no ergodicidad explica por qué el objetivo relevante es la trayectoria en el tiempo y no el promedio de conjunto. La teoría de las colas pesadas explica por qué la varianza sola muchas veces no alcanza, porque los estados extremos dominan la economía del asunto. El argumento completo funciona porque estas piezas encajan entre sí, no porque un teorema reemplace a todos los demás.
#XII. El linaje intelectual completo
Lo que parece una única idea moderna de inversión es en realidad una cadena en la que cada figura agrega una pieza faltante, o corrige un error, que dejó el marco anterior. Corre en dos hebras, cada una más o menos cronológica por su cuenta: primero la construcción clásica de la inversión de crecimiento óptimo, después el ajuste de cuentas moderno con las colas pesadas, la fragilidad y el tiempo.
#La construcción: logaritmos, crecimiento y dimensionamiento óptimo
-
Napier (1614): Napier da la primera herramienta indispensable. Los logaritmos linealizan los procesos multiplicativos, así que $\log(ab) = \log(a) + \log(b)$. Sin ese movimiento, no hay una forma limpia de convertir la capitalización compuesta en algo que se pueda analizar de forma aditiva.
-
Jacob Bernoulli (década de 1680): Bernoulli estudia el límite que más tarde se denotó con $e$. Eso conecta la herramienta logarítmica de Napier con la capitalización continua. Napier da el lenguaje. Bernoulli identifica la constante natural que le corresponde a ese lenguaje.
-
Daniel Bernoulli (1738): Daniel Bernoulli es el primer gran puente entre la matemática pura y la teoría de la decisión. Toma el logaritmo y lo aplica a la elección riesgosa, argumentando que el riesgo multiplicativo cambia el comportamiento racional. Todavía no tiene a Kelly ni la ergodicidad, pero apunta en esa dirección.
-
Jensen (1906): Jensen aporta el teorema geométrico que faltaba. Si la función relevante es cóncava, la variabilidad se penaliza. Eso convierte la intuición logarítmica de Daniel Bernoulli en un hecho estructural general: una vez que la riqueza se evalúa a través de una función cóncava, el azar tiene un costo sistemático.
-
von Neumann y Morgenstern (1944): formalizan la utilidad esperada como el punto de referencia dominante para la elección racional. Este es el marco que pensadores posteriores van a refinar, cuestionar o rechazar en parte. Su papel no es resolver el problema de la capitalización compuesta. Su papel es definir el punto de referencia que Peters va a criticar después.
-
Shannon (1948): Shannon vuelve operativa la incertidumbre. La información es medible, el ruido tiene estructura y mejores señales cambian cómo se ve una decisión repetida óptima. Esta es la base matemática que Kelly después convierte en una regla de asignación de capital.
-
Markowitz (1952): Markowitz le da a las finanzas una aproximación manejable de un período a través del análisis de media-varianza. Es un avance real, pero también una simplificación. Hace práctica la elección de cartera, mientras deja poco enfatizados la capitalización compuesta, la dependencia de la trayectoria y la ruina.
-
Kelly (1956): Kelly toma el marco de la teoría de la información de Shannon y lo traduce a las apuestas repetidas y la inversión. Muestra cómo una ventaja debería convertirse en tamaño de posición cuando el objetivo es el crecimiento compuesto de largo plazo. Acá es donde los logaritmos, la información y la capitalización compuesta se vuelven una sola regla explícita.
-
Thorp y Breiman (de 1961 en adelante): Thorp muestra que Kelly se puede usar en la práctica, y Breiman le da fuerza matemática al resultado de dominancia de largo plazo.
-
Cover (1991): Cover extiende la tradición del crecimiento óptimo hacia el aprendizaje. Las carteras universales muestran que, incluso sin un modelo completamente conocido, es posible acercarse asintóticamente al desempeño de la mejor cartera rebalanceada vista en retrospectiva. Esto hace más robusta la lógica de Kelly bajo incertidumbre de modelo.
-
Fernholz (2002): Fernholz extiende la tradición geométrica a la construcción misma de carteras. La teoría estocástica de carteras muestra que la diversidad, el rebalanceo y la estructura del mercado pueden generar retornos relativos incluso sin pronósticos heroicos. Eso amplía el argumento del dimensionamiento óptimo a la geometría del diseño de carteras.
#El ajuste de cuentas: colas pesadas, fragilidad, ergodicidad y práctica
-
Mandelbrot (1963): Mandelbrot cuestiona la comodidad estadística detrás de las finanzas estándar. Los retornos no quedan bien descriptos por supuestos gaussianos de colas livianas. Una vez que eso es cierto, el razonamiento simple de media-varianza se vuelve menos confiable, y la cola izquierda importa mucho más.
-
Samuelson (1969): Samuelson es el crítico que obliga a formular con claridad la distinción entre la utilidad esperada y el crecimiento de largo plazo.
-
Minsky (1986): Minsky agrega el mecanismo macrofinanciero: la estabilidad engendra fragilidad, así que el riesgo de la cola izquierda lo genera el propio sistema.
-
Bouchaud (2003 a 2008): Bouchaud vincula las colas pesadas con la microestructura del mercado, la retroalimentación y el comportamiento de masas.
-
Sornette (2003): Sornette modela las burbujas y los crashes como fenómenos críticos endógenos en lugar de shocks exógenos.
-
Taleb (2007 a 2012): con Taleb, la crítica estadística de las colas pesadas se vuelve una doctrina de supervivencia. La ruina, la fragilidad, la convexidad y la asimetría dejan de ser notas técnicas al margen y se vuelven el problema central de la cartera. Mandelbrot te dice que las colas son más pesadas de lo que creés. Taleb te dice que, una vez que aceptás ese hecho, toda la lógica de la toma de riesgo tiene que cambiar.
-
Peters y Adamou (2011 a 2019): Peters y Adamou reabren los fundamentos de la teoría de la decisión al mostrar que los procesos multiplicativos no ergódicos tienen que evaluarse a lo largo de trayectorias en el tiempo, no a través de conjuntos hipotéticos. Esto reconecta a Kelly con una justificación más profunda: más que una regla de apuestas ingeniosa, es el objetivo correcto para un proceso de capitalización compuesta no ergódico.
-
Spitznagel (2021): Spitznagel es la capa de implementación. Toma toda la cadena, logaritmos, concavidad, dimensionamiento de Kelly, colas pesadas, fragilidad y no ergodicidad, y la convierte en una arquitectura práctica de cartera construida alrededor de la protección convexa y la supervivencia a través de los crashes. Es el punto en el que la matemática deja de ser interpretación y se vuelve un diseño de cartera real.
#Conclusión: la geometría de la supervivencia
La desigualdad de Jensen es la geometría de la supervivencia en un mundo multiplicativo, no una curiosidad matemática. La riqueza se organiza por razones, no por diferencias, y el logaritmo es el sistema de coordenadas que hace visible esa estructura. Como ese cambio de coordenadas es cóncavo, la volatilidad es geométricamente destructiva: un lastre cuadrático sobre el crecimiento compuesto.
La larga confusión de la economía fue tratar el promedio de conjunto como si fuera la trayectoria vivida por el inversor. La media aritmética mira lo que pasa a través de una población de inversores en paralelo. La media geométrica mira lo que te pasa a vos a lo largo del tiempo. Para un único inversor que se capitaliza durante décadas, solo importa el promedio temporal.
La cobertura de colas funciona porque respeta esta geometría. Acepta una reducción chica y segura del retorno aritmético (la prima de los puts) a cambio de protección contra los estados que más daño le hacen al crecimiento compuesto. En una aproximación local, eso se ve como pagar para reducir una penalidad cuadrática de varianza. En el cuadro más completo de colas pesadas, se entiende mejor como pagar para reducir la exposición a trayectorias ruinosas de la cola izquierda.
El logaritmo se inventó para ayudar a los astrónomos a multiplicar. Cuatrocientos años después, revela por qué un seguro contra crashes puede valer lo que cuesta, y por qué, cuando los retornos se capitalizan, la supervivencia viene antes que el crecimiento.
#Referencias
- Bernoulli, D. (1738). “Specimen Theoriae Novae de Mensura Sortis.”
- Bernoulli, J. (1685). Ars Conjectandi (póstumo, 1713)
- Bouchaud, J. P. & Potters, M. (2003). Theory of Financial Risk and Derivative Pricing. Cambridge University Press.
- Bouchaud, J. P. (2008). “Economics Needs a Scientific Revolution.” Nature, 455.
- Breiman, L. (1961). “Optimal Gambling Systems for Favorable Games.”
- Cover, T. M. (1991). “Universal Portfolios.” Mathematical Finance, 1(1).
- Fernholz, R. (2002). Stochastic Portfolio Theory. Springer.
- Jensen, J. L. W. V. (1906). “Sur les fonctions convexes et les inégalités entre les valeurs moyennes.” Acta Mathematica, 30.
- Kelly, J. L. (1956). “A New Interpretation of Information Rate.” Bell System Technical Journal, 35(4).
- Mandelbrot, B. (1963). “The Variation of Certain Speculative Prices.” The Journal of Business, 36(4).
- Mandelbrot, B. & Hudson, R. L. (2004). The (Mis)Behavior of Markets. Basic Books.
- Markowitz, H. (1952). “Portfolio Selection.” The Journal of Finance, 7(1).
- Minsky, H. P. (1986). Stabilizing an Unstable Economy. Yale University Press.
- Napier, J. (1614). Mirifici Logarithmorum Canonis Descriptio
- Peters, O. & Adamou, A. (2011). “The Time Resolution of the St Petersburg Paradox.” Philosophical Transactions of the Royal Society A, 369(1956).
- Peters, O. & Gell-Mann, M. (2016). “Evaluating Gambles Using Dynamics.” Chaos, 26(2).
- Peters, O. (2019). “The Ergodicity Problem in Economics.” Nature Physics, 15.
- Samuelson, P. A. (1969). “Lifetime Portfolio Selection by Dynamic Stochastic Programming.”
- Shannon, C. E. (1948). “A Mathematical Theory of Communication.” Bell System Technical Journal, 27.
- Sornette, D. (2003). Why Stock Markets Crash. Princeton University Press.
- Sornette, D. (2017). Why Stock Markets Crash: Critical Events in Complex Financial Systems (edición actualizada). Princeton University Press.
- Spitznagel, M. (2021). Safe Haven: Investing for Financial Storms. Wiley.
- Taleb, N. N. (2007). The Black Swan: The Impact of the Highly Improbable. Random House.
- Taleb, N. N. (2012). Antifragile: Things That Gain from Disorder. Random House.
- Thorp, E. O. (1997). “The Kelly Criterion in Blackjack, Sports Betting, and the Stock Market.”
- von Neumann, J. & Morgenstern, O. (1944). Theory of Games and Economic Behavior. Princeton University Press.
De la serie Leptocúrtico.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.