Leyes de potencia, Extremistán y no ergodicidad
La invariancia de escala se vuelve ley de potencia; las leyes de potencia mueven la importancia hacia los extremos; los extremos vuelven inestables los promedios a lo largo del tiempo.
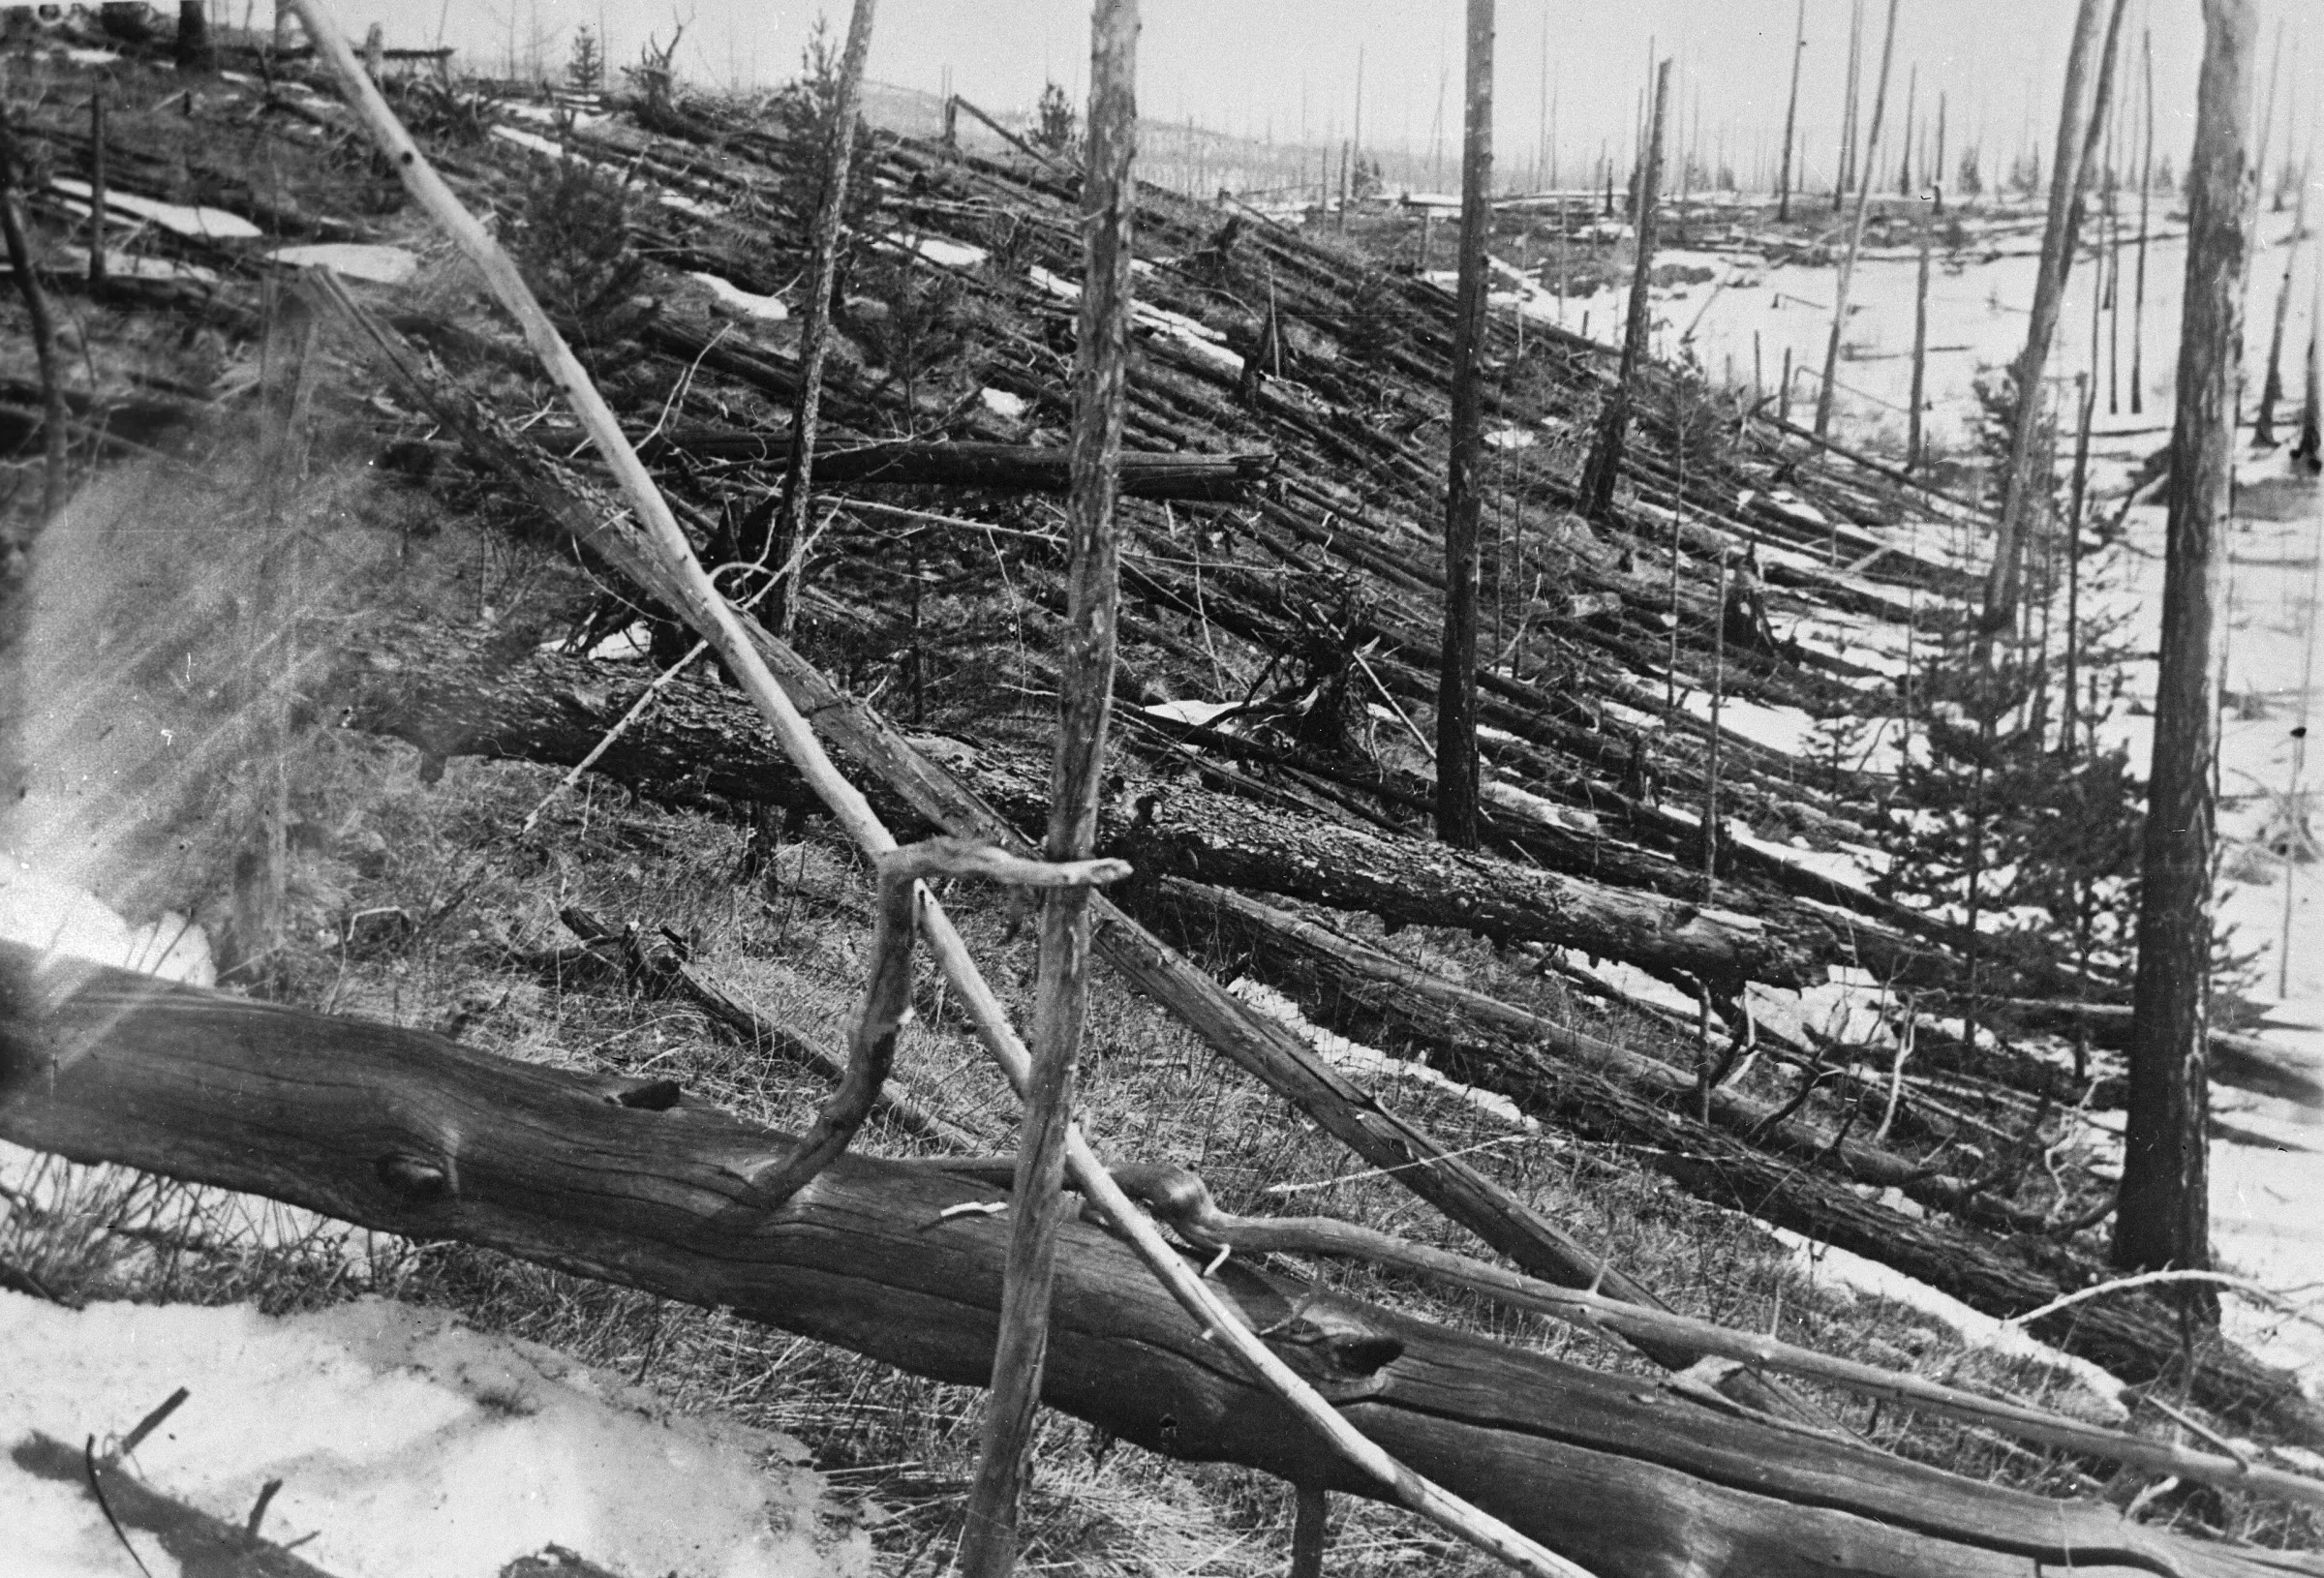
Sobre la imagen Una sola explosión aérea en 1908 arrasó unos 2.000 kilómetros cuadrados de bosque. Eso es Extremistán: un solo evento pesa más que miles de eventos comunes, y el promedio de todos ellos no te dice casi nada sobre él. Árboles derribados por la explosión de Tunguska de 1908, fotografiados durante la expedición de Leonid Kulik, Siberia, 1929. Foto: expedición de Leonid Kulik, dominio público, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
El ensayo anterior terminó con fractales: objetos cuya estructura sobrevive a hacer zoom una y otra vez. Este ensayo convierte esa afirmación geométrica en una afirmación estadística.
Si un objeto no tiene una escala de longitud característica, contarlo suele producir una ley de potencia (power law). Si una distribución tiene una cola de ley de potencia, los extremos dejan de ser despreciables. Si los extremos dejan de ser despreciables, los promedios se vuelven inestables. Si el proceso es multiplicativo o tiene estados de ruina absorbentes, el promedio sobre muchos mundos posibles puede volverse irrelevante para la trayectoria que una persona efectivamente vive.
Ese es el camino:
$$\text{scale invariance}\to\text{power laws}\to\text{fat tails}\to\text{non-ergodicity}.$$
Acá es donde Mandelbrot, Taleb, Peters, Kelly, Wilson, Bak y el teorema central del límite empiezan a formar parte de la misma conversación.
#El vocabulario mínimo
Una distribución te dice qué tan probables son los distintos resultados. Para una variable continua, la densidad $p(x)$ describe la probabilidad por unidad de $x$. La función de supervivencia:
$$P(X>x)$$
pregunta por la probabilidad de ver un resultado mayor que $x$.
Una cola es el extremo lejano de una distribución: los valores grandes y raros. Una distribución de cola liviana (thin-tailed), como una gaussiana, hace que los eventos muy grandes desaparezcan rapidísimo. Una distribución de colas pesadas (fat tails) hace que desaparezcan lo bastante despacio como para que los extremos sigan siendo estructuralmente importantes.
Una ley de potencia es una relación de escala:
$$P(X>x)\sim Cx^{-\alpha}.$$
Multiplicar $x$ por una constante multiplica la probabilidad por otra constante. No hay una escala preferida.
Un promedio de conjunto (ensemble average) promedia a través de muchos mundos posibles o de muchas copias paralelas de un proceso. Un promedio temporal sigue un solo proceso a lo largo del tiempo y promedia sobre esa única trayectoria.
Un proceso es ergódico cuando el promedio temporal y el promedio de conjunto coinciden en el sentido de largo plazo que importa. Es no ergódico cuando no coinciden. La riqueza multiplicativa, la ruina y los sistemas que dependen de la trayectoria suelen ser no ergódicos.
#De la invariancia de escala a las leyes de potencia
Ahora hacé zoom sobre un fractal.
Se ve parecido.
Zoom otra vez.
Sigue pareciéndose.
Otra vez.
Sigue pareciéndose.
No hay una escala característica. Eso es la invariancia de escala.
A veces esta sección se resume como “los fractales crean leyes de potencia”, pero esa frase es demasiado burda. La implicación real es:
$$\text{scale invariance}\Rightarrow\text{power-law form}.$$
Los fractales son una fuente geométrica de invariancia de escala. No son la única fuente, y no toda medición de un fractal da una ley de potencia limpia. Los mercados, las ciudades, los terremotos, los idiomas y las redes pueden producir escalamiento a través de mecanismos que no son literalmente geometría fractal: conexión preferencial (preferential attachment), crecimiento multiplicativo, criticidad, mezclas de regímenes y renormalización. El objeto común no es “fractal” sino “sin escala preferida”.
Una escala característica es un tamaño típico. La altura de los humanos adultos tiene una escala característica. Podés hablar de una altura normal. El tamaño de los terremotos, el tamaño de las ciudades, la riqueza, el tamaño de las empresas y los cracks de mercado muchas veces no se comportan así. Hay muchos eventos chicos, menos eventos medianos y eventos enormes y raros, sin ningún tamaño único que organice toda la distribución.
Una ley de potencia es una relación en la que multiplicar la entrada por una cantidad fija multiplica la salida por una cantidad fija. La forma más simple es:
$$y=Cx^{-\alpha}.$$
Si duplicás $x$, entonces:
$$y(2x)=C(2x)^{-\alpha}=2^{-\alpha}Cx^{-\alpha}=2^{-\alpha}y(x).$$
Así que cada duplicación del tamaño reduce la frecuencia por el mismo factor. Eso es lo que significa en la práctica “sin escala característica”. A la distribución le da lo mismo si pasás de $10$ a $20$, de $100$ a $200$ o de $1000$ a $2000$. La relación multiplicativa es la misma.
La invariancia de escala tiene una forma matemática simple. Supongamos que una distribución $P(x)$ cumple:
$$P(\lambda x)=\lambda^{-\alpha}P(x).$$
Las soluciones son leyes de potencia:
$$P(x)=Cx^{-\alpha}.$$
Esta es la derivación más general. La invariancia de escala dice primero que reescalar $x$ cambia $P$ solo por un multiplicador que depende de la escala:
$$P(\lambda x)=c(\lambda)P(x).$$
Ahora reescalá dos veces. Escalar por $\mu$ y después por $\lambda$ tiene que dar lo mismo que escalar una sola vez por $\lambda\mu$:
$$P(\lambda\mu x)=c(\lambda)c(\mu)P(x).$$
Pero el mismo lado izquierdo también es:
$$P(\lambda\mu x)=c(\lambda\mu)P(x).$$
Entonces:
$$c(\lambda\mu)=c(\lambda)c(\mu).$$
Las soluciones regulares de esta ecuación multiplicativa son:
$$c(\lambda)=\lambda^{-\alpha}.$$
Por lo tanto:
$$P(\lambda x)=\lambda^{-\alpha}P(x),$$
y las formas compatibles son leyes de potencia:
$$P(x)=Cx^{-\alpha}.$$
Así que la ley de potencia no sale de la rugosidad visual por sí sola. Sale de la consistencia bajo reescalados repetidos.
Acá estoy usando $P(x)$ de manera informal para una cantidad que depende de la escala. En probabilidad hay que distinguir dos exponentes relacionados. Si la densidad se comporta como $p(x)\sim Cx^{-\beta}$, entonces la función de supervivencia se comporta como:
$$P(X>x)\sim C’x^{-(\beta-1)}.$$
Al exponente de supervivencia se lo suele llamar índice de cola (tail index). En la próxima sección, cuando escribo:
$$P(X>x)\sim x^{-\alpha},$$
$\alpha$ es el índice de cola, no el exponente de la densidad. Esta convención es común cuando se habla de colas de Pareto, pero vale la pena hacerla explícita porque los dos exponentes difieren en uno.
Lo podés ver tomando logaritmos. Si:
$$P(x)=Cx^{-\alpha},$$
entonces:
$$\log P(x)=\log C-\alpha \log x.$$
Así que en ejes log-log la distribución se vuelve una línea recta.

#Gráfico: ley de potencia versus gaussiana
Abrí esta simulación en Explorar →
import numpy as np
import matplotlib.pyplot as plt

x = np.logspace(0, 3, 400)
power = x ** -1.7
gaussian_tail = np.exp(-x**2 / 2_000)

plt.loglog(x, power, label="power law")
plt.loglog(x, gaussian_tail, label="Gaussian-like tail")
plt.legend()#Simulación: muestreo de una ley de potencia
Abrí esta simulación en Explorar →
Compará las medias muestrales acumuladas de extracciones gaussianas y de Pareto.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(4)
n = 50_000

gaussian = rng.normal(loc=1.0, scale=1.0, size=n)
pareto = rng.pareto(a=1.4, size=n) + 1

gaussian_mean = np.cumsum(gaussian) / np.arange(1, n + 1)
pareto_mean = np.cumsum(pareto) / np.arange(1, n + 1)

plt.plot(gaussian_mean, label="Gaussian running mean")
plt.plot(pareto_mean, label="Pareto running mean")
plt.legend()
Lo que tendrías que ver: la media gaussiana se estabiliza. La media de Pareto sigue saltando cada vez que aparece un extremo nuevo. Más datos no hacen necesariamente que un promedio de colas pesadas se calme.
Los fractales son invariancia de escala geométrica. Las leyes de potencia son invariancia de escala estadística.
El mismo fenómeno.
Otro punto de vista.
La sexta lección:
Las leyes de potencia son la versión probabilística de la invariancia de escala. Los fractales son un camino geométrico hacia esa invariancia, no toda la historia.
Hay otra manera de ver por qué la invariancia de escala fuerza leyes de potencia. Sea:
$$Q(t)=\log P(e^t).$$
La ley de escala:
$$P(\lambda x)=\lambda^{-\alpha}P(x)$$
se convierte, con $\lambda=e^s$ y $x=e^t$, en:
$$Q(t+s)=Q(t)-\alpha s.$$
Las únicas soluciones continuas son afines:
$$Q(t)=C-\alpha t.$$
Volver a $x=e^t$ da:
$$P(x)=e^C x^{-\alpha}.$$
Así que una ley de potencia no es una curva arbitraria. Es la única forma de distribución compatible con la invariancia por traslación en el espacio logarítmico. Hacer zoom se vuelve desplazar. La autosimilitud se vuelve linealidad.
Hay una derivación más con fundamento, y es la más limpia de todas: la máxima entropía. Fijá una sola cosa de una cantidad positiva, su logaritmo medio $\mathbb{E}[\log x]$. Esa es la restricción natural cuando la cantidad abarca muchos órdenes de magnitud, donde lo que se mantiene estable es la cantidad típica de dígitos y no el valor típico. Entre todas las densidades sobre $x\ge x_{\min}$ que respetan esa restricción, la que no supone nada más es la densidad de máxima entropía: maximizar $-\int p\log p$ sujeto a la normalización y a $\mathbb{E}[\log x]$ fijo. Las condiciones de Lagrange dan
$$p(x)\propto \exp(-\beta\log x)=x^{-\beta},$$
una ley de potencia, con $\beta$ el multiplicador que impone la restricción y $\beta>1$ para que la densidad se pueda normalizar por encima de $x_{\min}$. Si en cambio fijás la media de $x$, obtenés una exponencial; si fijás la media de $x^2$ sobre toda la recta real, obtenés una gaussiana. La ley de potencia es simplemente cómo se ve el compromiso mínimo cuando la regla natural es logarítmica. Es la gemela informacional de la imagen de la renormalización: la invariancia de escala fuerza leyes de potencia geométricamente, y una restricción en escala logarítmica las fuerza por entropía.
La linealidad en el espacio logarítmico es también la razón por la que las leyes de potencia son tan seguido la sombra estadística de la renormalización. Si el sistema se ve igual después de agrupar a escala gruesa (coarse-graining), sus observables suelen volverse autofunciones de un operador de escala. El exponente $\alpha$ es el autovalor escrito en forma estadística.
Si esa frase te resulta demasiado comprimida, leela así: cuando alejar el zoom deja al sistema con la misma forma, las cantidades que medís tienen que transformarse de manera predecible bajo el zoom. La transformación predecible más simple es multiplicar por una constante. Las leyes de potencia son exactamente las funciones que hacen eso.
El ejemplo canónico de la física es el grupo de renormalización de Wilson para transiciones de fase de segundo orden. Cerca de un punto crítico, un imán, un fluido o un modelo de red pueden verse estadísticamente parecidos después de agrupar a escala gruesa. Los detalles del sistema microscópico se borran; los exponentes críticos quedan. Es el mismo tipo de universalidad que Feigenbaum encontró en la duplicación de período, ahora apareciendo en la física estadística de equilibrio.
La criticidad autoorganizada (self-organized criticality) es otro camino. En el modelo de la pila de arena de Bak, Tang y Wiesenfeld, se agregan granos despacio hasta que el sistema se organiza solo cerca de un estado crítico. Aparecen avalanchas de muchos tamaños. El punto no es que toda ley de potencia venga de una pila de arena, sino que reglas locales repetidas pueden crear estadísticas libres de escala sin que un planificador externo ajuste el sistema a mano.
La conexión preferencial es un tercer camino, y probablemente sea el que los lectores se cruzan más seguido. Si los nuevos enlaces, personas, capital o atención se conectan preferentemente a nodos que ya tienen muchos enlaces, personas, capital o atención, entonces los grandes se agrandan más rápido. Es el mecanismo de Yule-Simon, o el de “el rico se hace más rico”. Aparece en el tamaño de las ciudades, la frecuencia de las palabras, las redes de citas, la distribución de la riqueza, los enlaces de internet y el tamaño de las empresas.
La regla de juguete es simple. Si el nodo $i$ tiene tamaño $k_i$, entonces la probabilidad de que la próxima unidad se conecte a él es proporcional a $k_i$:
$$P(i)=\frac{k_i}{\sum_j k_j}.$$
Esa única regla de refuerzo puede crear una distribución de cola pesada sin recurrir a la geometría fractal ni a una pila de arena. La conexión con la escalera sigue siendo la misma: una transformación local repetida cambia la distribución, y la distribución de largo plazo se acerca a una forma fija libre de escala.
También hay una versión probabilística directa de la renormalización: el teorema central del límite.
Tomá dos copias independientes de una variable aleatoria, sumalas y reescalá:
$$X\mapsto \frac{X_1+X_2}{\sqrt{2}}.$$
Repetí esta operación. Para distribuciones con varianza finita, la gaussiana es el punto fijo atractor. Por eso las sumas de muchos efectos chicos e independientes se ven normales tan seguido.
Pero si la varianza es infinita, la gaussiana deja de ser el atractor correcto. Los puntos fijos pasan a ser las leyes estables de Lévy, muchas de las cuales tienen colas de ley de potencia. Las colas pesadas no son simplemente “gaussianas fallidas”. Pertenecen a otra cuenca de atracción en el espacio de distribuciones.
El exponente de reescalado es lo que las delata. Para mantener fija una suma de varianza finita dividís por $\sqrt{n}=n^{1/2}$; una ley estable con índice de cola $\alpha$ en cambio reescala como $n^{1/\alpha}$. Ese exponente no es nuevo. Es el mismo $n^{1/\alpha}$ que gobierna qué tan rápido crece el máximo en la próxima sección. La forma en que las sumas de colas pesadas se niegan a achicarse y la forma en que los máximos de colas pesadas se niegan a quedarse chicos son un mismo hecho con dos caras.
Esta es una de las maneras más limpias de entender Extremistán. Un mundo gaussiano y un mundo de leyes de potencia están gobernados por puntos fijos de renormalización distintos.
El puente de los fractales a las leyes de potencia es la medición.
Un fractal es invariancia de escala vista como forma. Una ley de potencia es invariancia de escala vista como conteo. Si una costa, una red de ríos, un sistema de fallas, una cascada de mercado o un sistema de ciudades tiene estructura a lo largo de muchas escalas, entonces contar “¿cuántas cosas de tamaño al menos $x$ hay?” suele producir una ley de potencia.
La conexión importante es que los dos son puntos fijos de una operación de reescalado.
Para un fractal, reescalás la imagen y la forma es estadísticamente parecida.
Para una ley de potencia, reescalás la variable y la distribución cambia solo por un factor multiplicativo:
$$P(\lambda x)=\lambda^{-\alpha}P(x).$$
Esto no es una metáfora. Es la misma forma matemática: un objeto se transforma al hacer zoom, y su estructura esencial sobrevive. La operación de zoom es la transformación; el fractal o la distribución de ley de potencia es el objeto invariante.
La geometría y la probabilidad no son misterios separados. Son dos maneras de observar la misma falta de escala característica.
#Las leyes de potencia crean Extremistán
Acá es donde entra Taleb.
En un mundo gaussiano:
- los promedios importan,
- la varianza es finita,
- los eventos grandes son lo bastante raros como para ignorarlos la mayor parte del tiempo.
En un mundo de leyes de potencia:
- los extremos dominan,
- la varianza puede no existir,
- los promedios pueden seguir siendo inestables durante muchísimo tiempo.
Para una cola de Pareto:
$$P(X>x)\sim x^{-\alpha}.$$
Esto significa: la probabilidad de que $X$ supere $x$ cae como una potencia de $x$. El símbolo $\sim$ significa “asintóticamente proporcional a”. No dice que la igualdad sea exacta en todos los tamaños. Dice que la cola se comporta así para valores grandes.
La media existe solo cuando:
$$\alpha>1.$$
La varianza existe solo cuando:
$$\alpha>2.$$
Así que si $1<\alpha\leq 2$, el promedio existe pero la varianza es infinita. Si $\alpha\leq 1$, ni siquiera existe la media. Esto no es un tecnicismo menor. Cambia lo que significa la evidencia.
En un mundo de colas livianas, más muestras estabilizan tu estimación rápido. En un mundo de colas pesadas, una sola observación nueva puede dominar toda la historia.
Un terremoto domina un siglo.
Una empresa domina un mercado.
Una ciudad domina un país.
Una idea domina una era.
La séptima lección:
Las leyes de potencia mueven la importancia del promedio al extremo.
La diferencia operativa se ve en el máximo.
Para $n$ observaciones gaussianas, el máximo crece despacio, más o menos como:
$$\sqrt{2\log n}.$$
Para $n$ observaciones de Pareto con índice de cola $\alpha$, el máximo crece como:
$$n^{1/\alpha}.$$
Esa es toda la diferencia de Extremistán. En Mediocristán, el máximo crece como la raíz cuadrada de un logaritmo. En Extremistán, crece como una potencia del tamaño de la muestra. Más observaciones no solo refinan el promedio. Abren lugar para un nuevo evento dominante.
Por eso la media muestral puede verse estable un tiempo y después saltar. No estaba convergiendo como esperaba tu intuición entrenada en gaussianas. Estaba esperando un nuevo máximo.
El puente de las leyes de potencia a Extremistán es la dominancia.
En un mundo gaussiano, a ninguna observación individual se le permite importar demasiado. El teorema central del límite es la expresión matemática de esto. Muchas contribuciones chicas e independientes se suman, y el agregado se vuelve estable. Los términos individuales desaparecen en el promedio.
En un mundo de leyes de potencia, la observación más grande puede ser toda la historia. El agregado no es una suma democrática de piezas comparables. Muchas veces es una aristocracia de extremos.
Esto cambia lo que significa entender un sistema. En Mediocristán, el caso típico es informativo. Si entendés la altura humana promedio, entendés mucho sobre la altura humana. En Extremistán, el caso típico puede ser casi irrelevante. La startup típica no explica los retornos del venture capital. El terremoto típico no explica el daño geológico. La palabra típica no explica la frecuencia del lenguaje. La ciudad típica no explica la concentración urbana.
Así que en vez de preguntar cómo se ve el caso común, preguntás:
$$\frac{\text{largest few observations}}{\text{total mass}}.$$
Si ese cociente es grande, los promedios se vuelven resúmenes de los extremos, no resúmenes de lo típico.
Esta es la versión estadística de la historia anterior de los atractores. En dinámica, el atractor organiza las trayectorias. En Extremistán, la cola organiza la muestra. El centro ya no es soberano. El borde sí.
#Extremistán rompe la ergodicidad
Ahora metamos el tiempo.
Un promedio de conjunto pregunta qué pasa a través de muchos mundos paralelos. Un promedio temporal pregunta qué le pasa a un sistema a medida que avanza en el tiempo.
No son la misma pregunta.
Un sistema ergódico es uno en el que, a grandes rasgos, mirar una trayectoria típica durante mucho tiempo te da las mismas estadísticas que mirar muchas copias del sistema en un mismo momento.
Una versión matemática limpia es esta. Supongamos que un sistema evoluciona por una transformación $T$, y que $g(x)$ es alguna cantidad que medís en el estado $x$. El promedio temporal a lo largo de una trayectoria es:
$$\frac{1}{N}\sum_{n=0}^{N-1}g(T^n x).$$
El promedio de conjunto es:
$$\int g(x),d\mu(x),$$
donde $\mu$ es la distribución de probabilidad sobre los estados.
La ergodicidad dice que, bajo las condiciones adecuadas:
$$\lim_{N\to\infty}\frac{1}{N}\sum_{n=0}^{N-1}g(T^n x)=\int g(x),d\mu(x).$$
No te preocupes por los detalles de teoría de la medida. El significado práctico es simple: un camino que dura mucho termina muestreando el espacio de manera justa.
Este es el contenido del teorema ergódico de Birkhoff. Es uno de los teoremas que vuelven matemáticamente precisa la frase “el promedio temporal es igual al promedio de conjunto”.
La no ergodicidad significa que esto falla. Un camino a lo largo del tiempo no equivale a muchas muestras paralelas.
Hay otro objeto de punto fijo cerca. En una cadena de Markov, una distribución estacionaria $\pi$ cumple:
$$\pi=\pi P,$$
donde $P$ es la matriz de transición. Así que la distribución de largo plazo es un punto fijo del operador que empuja las distribuciones un paso hacia adelante.
Para mapas caóticos deterministas, el objeto análogo es una medida invariante. En vez de preguntar adónde va un punto, preguntás cómo se mueve toda una densidad de puntos. El operador de transferencia, o de Perron-Frobenius, manda la densidad de hoy a la densidad de mañana. Una densidad invariante $\rho$ cumple:
$$\mathcal{P}\rho=\rho.$$
Para el mapa logístico con $r=4$, la densidad invariante natural es:
$$\rho(x)=\frac{1}{\pi\sqrt{x(1-x)}}.$$
Esto conecta el caos de vuelta con la ergodicidad. Un mapa caótico puede ser impredecible punto por punto y aun así tener una distribución estadística estable. La trayectoria del punto es inestable; la medida es el objeto fijo.
Supongamos que la riqueza evoluciona de manera multiplicativa:
$$W_{t+1}=W_t(1+R_t).$$
El objeto de conjunto es:
$$\mathbb{E}[W_t].$$
El objeto de crecimiento temporal es:
$$\lim_{T\to\infty}\frac{1}{T}\log\left(\frac{W_T}{W_0}\right)=\mathbb{E}[\log(1+R)].$$
El logaritmo aparece porque la multiplicación repetida se vuelve suma repetida en el espacio logarítmico.
Si el sistema tiene colas pesadas, estados de ruina o eventos raros que dominan, una sola trayectoria no muestrea todas las posibilidades de ninguna manera útil. El promedio de conjunto se vuelve una mala guía para el camino vivido.
Eso es la no ergodicidad:
$$\text{time average}\neq \text{ensemble average}.$$
Por eso a Taleb, a Peters, a Kelly y a la economía de la ergodicidad les importan tanto las colas pesadas. Una estrategia puede verse bien en valor esperado y aun así ser fatal a lo largo del tiempo.
#Simulación: conjunto versus tiempo
Abrí esta simulación en Explorar →
import numpy as np

rng = np.random.default_rng(7)
n_paths = 20_000
n_steps = 300

# Mostly small gains, rare large losses.
returns = np.where(
    rng.random((n_paths, n_steps)) < 0.01,
    -0.55,
    0.008,
)

wealth = np.cumprod(1 + returns, axis=1)
ensemble_mean = wealth.mean(axis=0)
median_path = np.median(wealth, axis=0)
time_growth = np.log(wealth[:, -1]).mean() / n_steps
Graficá la media de conjunto y el camino mediano. Se separan. Al promedio lo arrastran los ganadores. El camino típico está gobernado por la supervivencia y la capitalización multiplicativa.
Para hacer el gráfico explícito:
import matplotlib.pyplot as plt

plt.plot(ensemble_mean, label="ensemble mean")
plt.plot(median_path, label="median path")
plt.yscale("log")
plt.xlabel("time")
plt.ylabel("wealth")
plt.legend()
Lo que tendrías que ver: la media de conjunto puede subir mientras el camino típico se estanca o muere. En los sistemas multiplicativos, el camino promedio y el camino vivido son objetos matemáticos distintos.
La octava lección:
Las leyes de potencia muchas veces vuelven no ergódicos a los sistemas porque los eventos raros dominan los resultados de largo plazo.
Un ejemplo mínimo con dos resultados hace más nítida la separación entre conjunto y tiempo.
Supongamos una apuesta que multiplica la riqueza por $1.5$ con probabilidad $1/2$ y por $0.6$ con probabilidad $1/2$.
El multiplicador promedio de conjunto es:
$$\mathbb{E}[M]=\frac{1.5+0.6}{2}=1.05.$$
A través de mundos paralelos, la riqueza promedio sube un 5 por ciento por ronda. Pero la tasa de crecimiento del promedio temporal es:
$$g=\frac{1}{2}\log(1.5)+\frac{1}{2}\log(0.6)=\log\sqrt{0.9}<0.$$
Una persona que repite la apuesta se funde exponencialmente casi con seguridad, aunque el promedio de conjunto crezca. El punto fijo se movió otra vez: ahora es la tasa de crecimiento de largo plazo de un proceso multiplicativo repetido, y el logaritmo es el sistema de coordenadas que la revela.
Por eso la transformación repetida es la primitiva correcta. Una apuesta de una sola vez y una apuesta repetida son objetos matemáticos distintos. El valor esperado responde la primera bastante mal en algunos casos. Responde la segunda de manera catastrófica cuando entran la multiplicación, la ruina y las colas pesadas.
El puente de Extremistán a la no ergodicidad es el camino único.
Las leyes de potencia te dicen que los extremos dominan el conjunto. La no ergodicidad pregunta si una trayectoria llega a experimentar el conjunto en las proporciones correctas. Muchas veces no.
Este es un cambio más profundo de lo que parece al principio. La teoría de la probabilidad muchas veces arranca imaginando muchos resultados posibles uno al lado del otro. Pero la vida no es uno al lado del otro. La vida es secuencial. No podés promediar sobre versiones paralelas de vos mismo después de la ruina. Recorrés un solo camino, en orden.
Ese orden importa. Los sistemas multiplicativos recuerdan las pérdidas de forma distinta que las ganancias. Una pérdida del 50 por ciento seguida de una ganancia del 50 por ciento no da cero:
$$1.0 \times 0.5 \times 1.5 = 0.75.$$
El retorno promedio aritmético es cero, pero el camino perdió un 25 por ciento. El logaritmo lo ve porque los logaritmos convierten la multiplicación en suma:
$$\log(ab)=\log a+\log b.$$
Así que el invariante correcto para la dinámica repetida de la riqueza no es el retorno esperado. Es el crecimiento logarítmico esperado, la probabilidad de supervivencia y la estructura de los drawdowns.
Si el evento raro mata al proceso, el proceso se detiene antes de poder promediar nada. Si el evento raro crea un ganador gigante, la media de conjunto puede estar dominada por caminos que casi con seguridad no vas a vivir. El tiempo no es un mecanismo de muestreo neutral. Tiene orden, supervivencia y dependencia de la trayectoria.
Esto se conecta de vuelta con los atractores. En un sistema ergódico, una sola trayectoria larga termina explorando el espacio relevante en las proporciones correctas. En un sistema no ergódico, la trayectoria queda atrapada, arruinada, amplificada o dependiente del camino. La cuenca en la que caés importa más que el promedio de conjunto sobre todas las cuencas.
El resumen invariante de este ensayo es:
$$ P(\lambda x)=\lambda^{-\alpha}P(x) \quad\Rightarrow\quad P(x)\propto x^{-\alpha}. $$
La invariancia de escala no siempre viene de los fractales. Puede venir de la renormalización, el crecimiento multiplicativo, la conexión preferencial, la criticidad o la criticidad autoorganizada. El objeto compartido es la ausencia de una escala característica.
Una vez que esas distribuciones libres de escala entran en procesos multiplicativos repetidos, el invariante relevante no es la expectativa de conjunto:
$$ \mathbb{E}[W_t], $$
sino la tasa de crecimiento del promedio temporal:
$$ \lim_{T\to\infty}\frac{1}{T}\log\frac{W_T}{W_0}. $$
El próximo ensayo pregunta por qué la recurrencia y la autorreferencia obligan a la aritmética a entrar en la historia.
#Lecturas recomendadas
- Benoit Mandelbrot, The Fractal Geometry of Nature. La fuente clásica sobre fractales y escalamiento.
- Mark Newman, Power laws, Pareto distributions and Zipf’s law (2005). Un primer paper cuidadoso sobre distribuciones de ley de potencia.
- Aaron Clauset, Cosma Shalizi y Mark Newman, Power-law distributions in empirical data (2009). La referencia estadística de advertencia.
- Kenneth Wilson, The renormalization group and critical phenomena (conferencia Nobel de 1983). La fuente conceptual limpia sobre renormalización y exponentes críticos.
- Edwin Jaynes, Information theory and statistical mechanics (1957). El principio de máxima entropía, detrás de la derivación entrópica de las leyes de potencia.
- Ole Peters, The ergodicity problem in economics (2019). Un camino directo hacia los promedios temporales, los promedios de conjunto y la riqueza multiplicativa.
- Ole Peters y Murray Gell-Mann, Evaluating gambles using dynamics (2016). La formulación individual más nítida del argumento del promedio temporal.
- John Kelly, A new interpretation of information rate (1956). El paper original del criterio de Kelly.
- Geoffrey West, Why Cities Keep on Growing, Corporations Always Die, and Life Gets Faster (The Long Now Foundation). Una charla sobre las leyes de escala y los exponentes de ley de potencia que atraviesan la biología, las ciudades y las empresas.
De la serie Cuando las reglas se repiten: la escalera del punto fijo.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.