¿Puedo probar programas de Concrete en Lean?
La hoja de ruta original para probar programas de Concrete en Lean, actualizada ahora que parte de ese puente existe: contratos en el código fuente, obligaciones de prueba, evidencia verificada por Lean, detección de pruebas desactualizadas y una base trusted explícita.
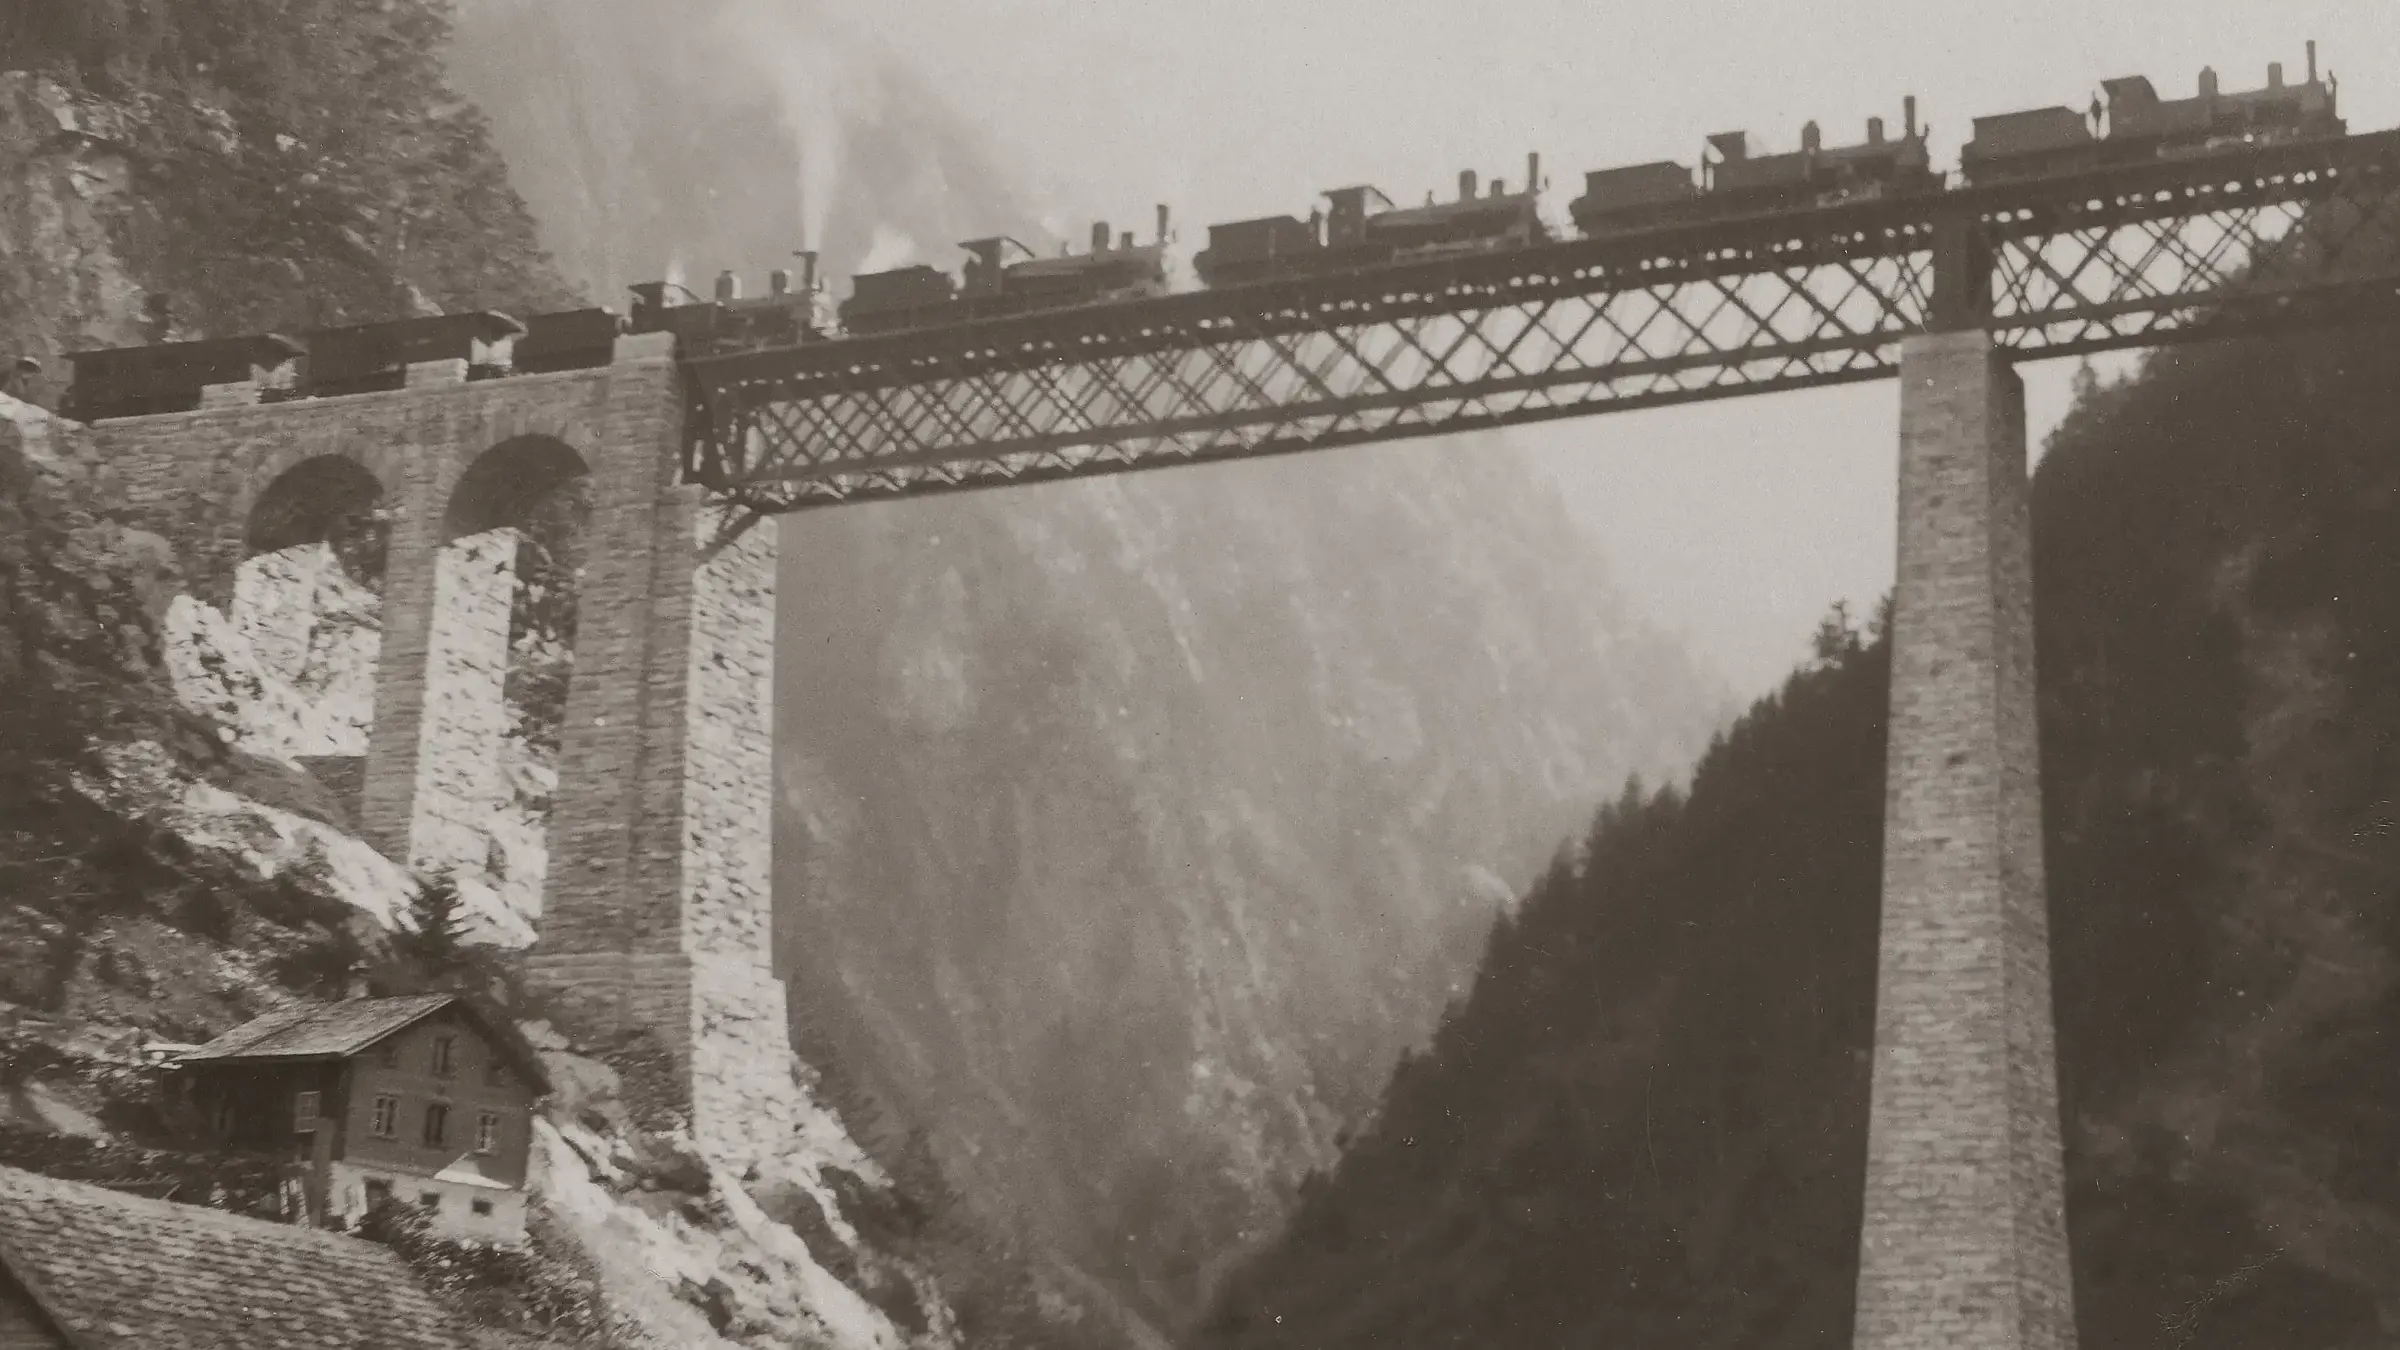
Sobre la imagen Antes de habilitar un puente ferroviario, los ingenieros estacionaban locomotoras encima y comparaban la deflexión medida con la calculada. Una prueba en Lean es ese mismo ensayo hecho sobre la especificación, y como el puente, vale tanto como la carga que elegiste ponerle. Prueba de carga del puente de Chärstelenbach cerca de Amsteg, en el Ferrocarril del Gotardo, con cinco locomotoras sobre el tramo, c. 1882. Foto: Florentin Joseph Charnaux, CC0, vía Wikimedia Commons (SBB Historic).
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Nota de la serie: esta es la entrega sobre la hoja de ruta de pruebas en la serie Concrete. Para una visión general del lenguaje, empezá por Por qué existe Concrete y la Especificación de Concrete. Para la demo más práctica de los reportes del compilador, leé Cuando el compilador es el oráculo.
Escribí la primera versión de este ensayo cuando probar programas de Concrete en Lean todavía era sobre todo un plan. La pregunta era simple y un poco arriesgada: ¿podemos tomar una función escrita en Concrete, conectarla con algo dentro del compilador y probar una propiedad real sobre ella en Lean?
Parte de esa respuesta ya existe. No para todo el lenguaje, y no para el binario final, pero sí para un subconjunto real. Concrete puede tomar un contrato en el código fuente (source contract), convertirlo en una obligación, adjuntarle una prueba verificada por Lean o el resultado de un procedimiento de decisión, y avisarte cuando esa evidencia ya no coincide con el código. Lo importante no es que cada afirmación se ponga en verde. Es que la herramienta se niega a mezclar “probado”, “asumido”, “trusted” y “todavía no hecho”.
#Por qué creo que hay una oportunidad
El código de sistemas verificado es caro. Verificar el microkernel seL4 llevó unos 20 años-persona: alrededor de 200.000 líneas de prueba en Isabelle para unas 10.000 líneas de C. Fiat Cryptography genera primitivas verificadas que se usan en navegadores reales. Mathlib formalizó una cantidad enorme de matemática en Lean. Del lado de las pruebas está todo bien. El problema son los lenguajes. Nunca se diseñaron para ser objeto de pruebas, así que la mayor parte del esfuerzo se va en tender un puente entre dos mundos que no tienen nada que ver.
Ese costo de tender el puente es lo que quiero atacar. Con VST escribís C, una herramienta aparte lo parsea a Coq, y rezás para que el modelo de C de esa herramienta coincida con lo que tu compilador realmente hace. Verus se queda en Rust pero tiene que modelar el código unsafe, el Drop implícito, las coerciones de Deref y todo lo demás que Rust no fue diseñado para hacer verificable. F* y Dafny arrancan desde la verificación e intentan extraer código de sistemas, pero terminás metido en un asistente de pruebas. ATS intentó ser las dos cosas, pero nunca prendió.
Siempre termina igual: le atornillás verificación a un lenguaje que te pelea, o extraés código de sistemas de un lenguaje que no fue hecho para eso. Creo que Concrete podría estar en una posición distinta por una decisión que tomé al principio: escribir el compilador en Lean 4.
#Lo que el compilador ya me da
El compilador de Concrete está escrito en Lean 4. No lo hice porque quisiera probar cosas sobre programas. Lo hice porque Lean es un buen lenguaje. Pero eso creó una oportunidad estructural que al principio no terminé de apreciar.
Después del parsing y la elaboración, todo programa de Concrete se convierte en Core IR, una representación intermedia chica, explícita y completamente tipada, definida como tipos inductivos de Lean:
inductive CExpr where
  | intLit (val : Int) (ty : Ty)
  | boolLit (val : Bool)
  | binOp (op : BinOp) (lhs rhs : CExpr) (ty : Ty)
  | call (fn : String) (typeArgs : List Ty) (args : List CExpr) (ty : Ty)
  | match_ (scrutinee : CExpr) (arms : List CMatchArm) (ty : Ty)
  | borrow (inner : CExpr) (ty : Ty)
  | borrowMut (inner : CExpr) (ty : Ty)
  | deref (inner : CExpr) (ty : Ty)
  -- ... ~40 constructors total across CExpr, CStmt, CMatchArm
Son datos nativos de Lean. No un objeto ajeno importado por FFI. No un AST serializado que otra herramienta tiene que parsear. Los mismos tipos que el compilador manipula durante la elaboración, el type checking y el lowering son los tipos sobre los que podría escribir pruebas. No hay traducción entre dos herramientas separadas, aunque sigue habiendo fronteras internas (la elaboración, la conexión de Core con la matemática, el lowering) donde el significado podría desviarse. Esas fronteras viven dentro de una sola base de código y no repartidas entre dos ecosistemas, y eso importa.
Para cuando el código llega a Core, todo el azúcar sintáctico de superficie desapareció. Las llamadas a métodos se vuelven llamadas a funciones comunes. ? se vuelve un match-and-return explícito. -> se vuelve una desreferencia seguida de un acceso a campo. Los borrows, los moves y los destroys son operaciones explícitas.
El pipeline del compilador tiene fronteras firmes:
Parse → Resolve → Check → Elaborate → CoreCheck → Mono → Lower → SSA → EmitCore es la autoridad semántica. Todo lo que está antes es comodidad de superficie; todo lo que está después es lowering hacia código de máquina. Cuando empecé a pensar dónde iría una frontera de prueba, Core era la respuesta obvia. Ya estaba ahí.
#La idea original
Esto es lo que quiero hacer. Tomar una función de Concrete, por ejemplo una que invierte una lista:
fn reverse<T>(xs: List<T>) -> List<T> {
    let mut acc: List<T> = List::Nil
    for x in xs {
        acc = List::Cons(x, acc)
    }
    return acc
}
El compilador ya elabora esto en un valor CExpr en Lean. Quiero conectar ese CExpr con la biblioteca de listas que Lean ya tiene y probar algo sobre él, por ejemplo que preserva la longitud.
Cuando escribí esto, pensaba que necesitaba tres piezas que todavía no existían.
Pieza 1: una semántica de evaluación formal para la representación de pruebas. Una definición en Lean que diga qué significan las expresiones extraídas:
-- Sketch, not real code yet
inductive Eval : Env → CExpr → Value → Prop where
  | intLit : Eval env (.intLit n ty) (.int n)
  | binOp : Eval env lhs (Value.int a) →
            Eval env rhs (Value.int b) →
            Eval env (.binOp .add lhs rhs ty) (.int (a + b))
  -- ...
Pieza 2: una conexión entre el código extraído y la matemática de Lean. Tengo que mostrar que “este término extraído, cuando se evalúa” significa lo mismo que “esta función de Lean sobre listas de Lean”. Esta es la parte más difícil, porque estás conectando código que corre con la matemática que realmente te importa.
Pieza 3: la prueba en sí. Una vez que existen las dos primeras piezas, puedo enunciar y probar:
theorem reverse_length (xs : List α) :
    length (concreteFn_reverse xs) = length xs := by
  -- proof using Lean's standard list lemmas
  -- concreteFn_reverse is the Lean-level interpretation
  -- of the Concrete function's Core representation
Esa forma básica sobrevivió, pero la implementación se volvió más honesta. La frontera de prueba no es “ahora todo el compilador es un teorema”. Es una representación de prueba extraída, un teorema vinculado al código fuente, una huella (fingerprint) que ata el teorema al cuerpo actual de la función, y una clase de evidencia que dice exactamente qué se probó y qué sigue siendo trusted.
#Por qué creo que el diseño de Concrete hace esto viable
Escribir el compilador en Lean no alcanza por sí solo. Si Concrete tuviera la misma superficie de features que Rust o C++, el Core IR sería enorme y formalizarlo sería igual de doloroso. La razón por la que creo que esto puede funcionar de verdad es que diseñé Concrete para que sea chico, y varias decisiones de diseño que tomé por otros motivos terminan ayudando acá.
En Rust, razonar sobre ownership exige modelar Drop: destructores implícitos que corren al salir del scope, flujo de control invisible que el programador nunca escribió. En Concrete, los valores con dueño tienen que consumirse exactamente una vez y la limpieza (cleanup) es explícita con destroy y defer. Cuando formalizás Core, lo que ves es lo que se ejecuta.
Las capabilities (capacidades) hacen visibles los efectos en el sistema de tipos. Si una función no tiene anotaciones de capabilities, es pura; el compilador lo hace cumplir. with(File) significa I/O de archivos. Puedo recortar mecánicamente el fragmento puro de una base de código y razonar sobre él sin arrastrar el sistema operativo a la prueba.
Las fronteras de confianza (trust boundaries) funcionan también como fronteras de prueba. El código safe lo verifica el compilador. El código trusted esconde una implementación a nivel de punteros detrás de una API segura. Unsafe cubre llamadas a código externo y acceso crudo al sistema. El lenguaje ya marca dónde está cada uno, así que no tengo que averiguar por dónde entra la confianza.
Nada de sobrecarga de operadores, nada de conversiones implícitas, nada de closures con capturas ocultas, nada de excepciones, nada de trait objects, nada de coerciones de Deref. Originalmente los dejé afuera porque creo que hacen el código más difícil de leer y auditar. Resulta que también hacen más difícil la formalización. No tenerlos mantiene chica la superficie de prueba.
#Cómo comparo esto con otros proyectos
Nadie obtiene esto gratis. Verus tiene el ecosistema de Rust pero tiene que modelar un lenguaje que pelea contra la verificación a cada paso. Fiat Cryptography genera código verificado que ningún humano escribió. RefinedC encara todo C, y se nota.
Lo que yo quiero es otra cosa: escribir código real de bajo nivel en Concrete, con ownership explícito, que compile a ejecutables nativos, y después probar propiedades sobre ese código en Lean usando las bibliotecas que Lean ya tiene. Si el puente funciona, el código que probás sería el código que distribuís, no un modelo que se traduce. Y no necesitarías un ecosistema de verificación hecho a medida, porque Lean ya tiene uno.
Concrete no tiene el ecosistema de Rust ni la base instalada de C. Estoy apostando a que un lenguaje chico y explícito puede abaratar lo suficiente la parte de las pruebas como para que valga la pena igual.
#Qué cambió desde la hoja de ruta
Así están las cosas hoy.
Lo que existe ahora es la primera versión funcional del puente que imaginaba. Una función de Concrete puede llevar un contrato. El compilador puede convertir ese contrato, o una preocupación de seguridad en tiempo de ejecución como el límite de un array, en una obligación. Una prueba se puede vincular de vuelta con el código fuente. Una huella ata esa prueba al cuerpo actual. Si el cuerpo cambia, la prueba deja de estar vigente en lugar de seguir siendo trusted en silencio.
Los ejemplos importan porque muestran a la vez la forma de la promesa y su límite. constant_time_tag prueba que el valor es correcto, pero no pretende probar el timing a nivel de máquina. hmac_sha256 tiene una historia de refinamiento más profunda. Las obligaciones de límites, división y overflow se pueden descargar con omega o bv_decide. Los ejemplos negativos son igual de importantes: los supuestos siguen siendo supuestos, los nombres de prueba falsos los atrapa concrete prove --check, las pruebas desactualizadas (stale) quedan marcadas como desactualizadas, y los contratos vacuos no pueden disfrazarse de pruebas reales.
Lo que todavía no existe es igual de importante. No hay una prueba formal de todo el checker. No hay un camino verificado desde Core, pasando por SSA y LLVM, hasta el binario final. No hay una historia de verificación del programa completo. El modelo de prueba es más limpio que la máquina que termina corriendo el código, y esa brecha tiene que seguir siendo visible. Concrete hoy prueba afirmaciones reales seleccionadas, pero no prueba que el programa entero sea correcto de punta a punta.
#Dónde espero problemas
Las funciones puras sobre tipos de datos algebraicos son el objetivo de prueba más fácil: aritmética, transformaciones estructurales, parsers sobre entradas acotadas. Las primeras pruebas deberían vivir acá.
FFI, Unsafe y el código trusted quedan todos fuera de la frontera de prueba. Las funciones externas son cajas negras. El código trusted y Unsafe hace cosas que el sistema de tipos no puede seguir del todo. Modelás sus contratos como axiomas y no pretendés otra cosa. Lo prefiero así: la prueba te dice exactamente dónde estás confiando en algo que no verificaste, en lugar de hacer de cuenta que todo está cubierto.
El código con heap mutable es donde las cosas vuelven a ponerse caras. La lógica de separación (separation logic) lo puede modelar. Prefiero ganarme el derecho a preocuparme por eso más adelante.
La concurrencia va última. Las pruebas reales de concurrencia necesitan modelos explícitos de scheduling, orden de memoria y sincronización, y no quiero formalizar nada de eso antes de que los casos más simples funcionen bien. Por esta razón Concrete deja la concurrencia para fases posteriores del lenguaje.
Hay otro problema que todavía no mencioné: incluso cuando una representación de prueba tiene una semántica de evaluación limpia, esa semántica puede igual divergir de lo que hacen en realidad los pasos de lowering del compilador. Pero esta es una sola frontera dentro de una sola base de código, no dos herramientas separadas que tienen que ponerse de acuerdo sobre qué significa C o Rust. Cerrar esa brecha, probar que el lowering preserva la semántica, sigue siendo un objetivo de prueba bien definido para más adelante.
#Lo que viene
El próximo paso ya no es “una prueba de una función real”. Eso ya pasó. El próximo paso es escala y honestidad: hacer crecer el subconjunto probable, mantener separadas las clases de evidencia, hacer que escribir pruebas sea menos doloroso, ajustar la conexión de solidez (soundness) entre los términos de prueba extraídos y el pipeline del compilador, y mantener la base de cómputo trusted lo suficientemente visible para que nadie confunda una prueba local con una garantía universal.
De la serie Concrete.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.