Cuando el compilador es el oráculo
Corrí un loop al estilo autoresearch sobre un programa en Concrete. El compilador le dijo a un agente dónde se podían mejorar la autoridad, la asignación de memoria y la superficie de prueba, y le confirmó cuándo esas propiedades cambiaban. Sin profiler, sin ruido de benchmarks. Tu compilador puede responder preguntas en vez de decir pasa/no pasa.
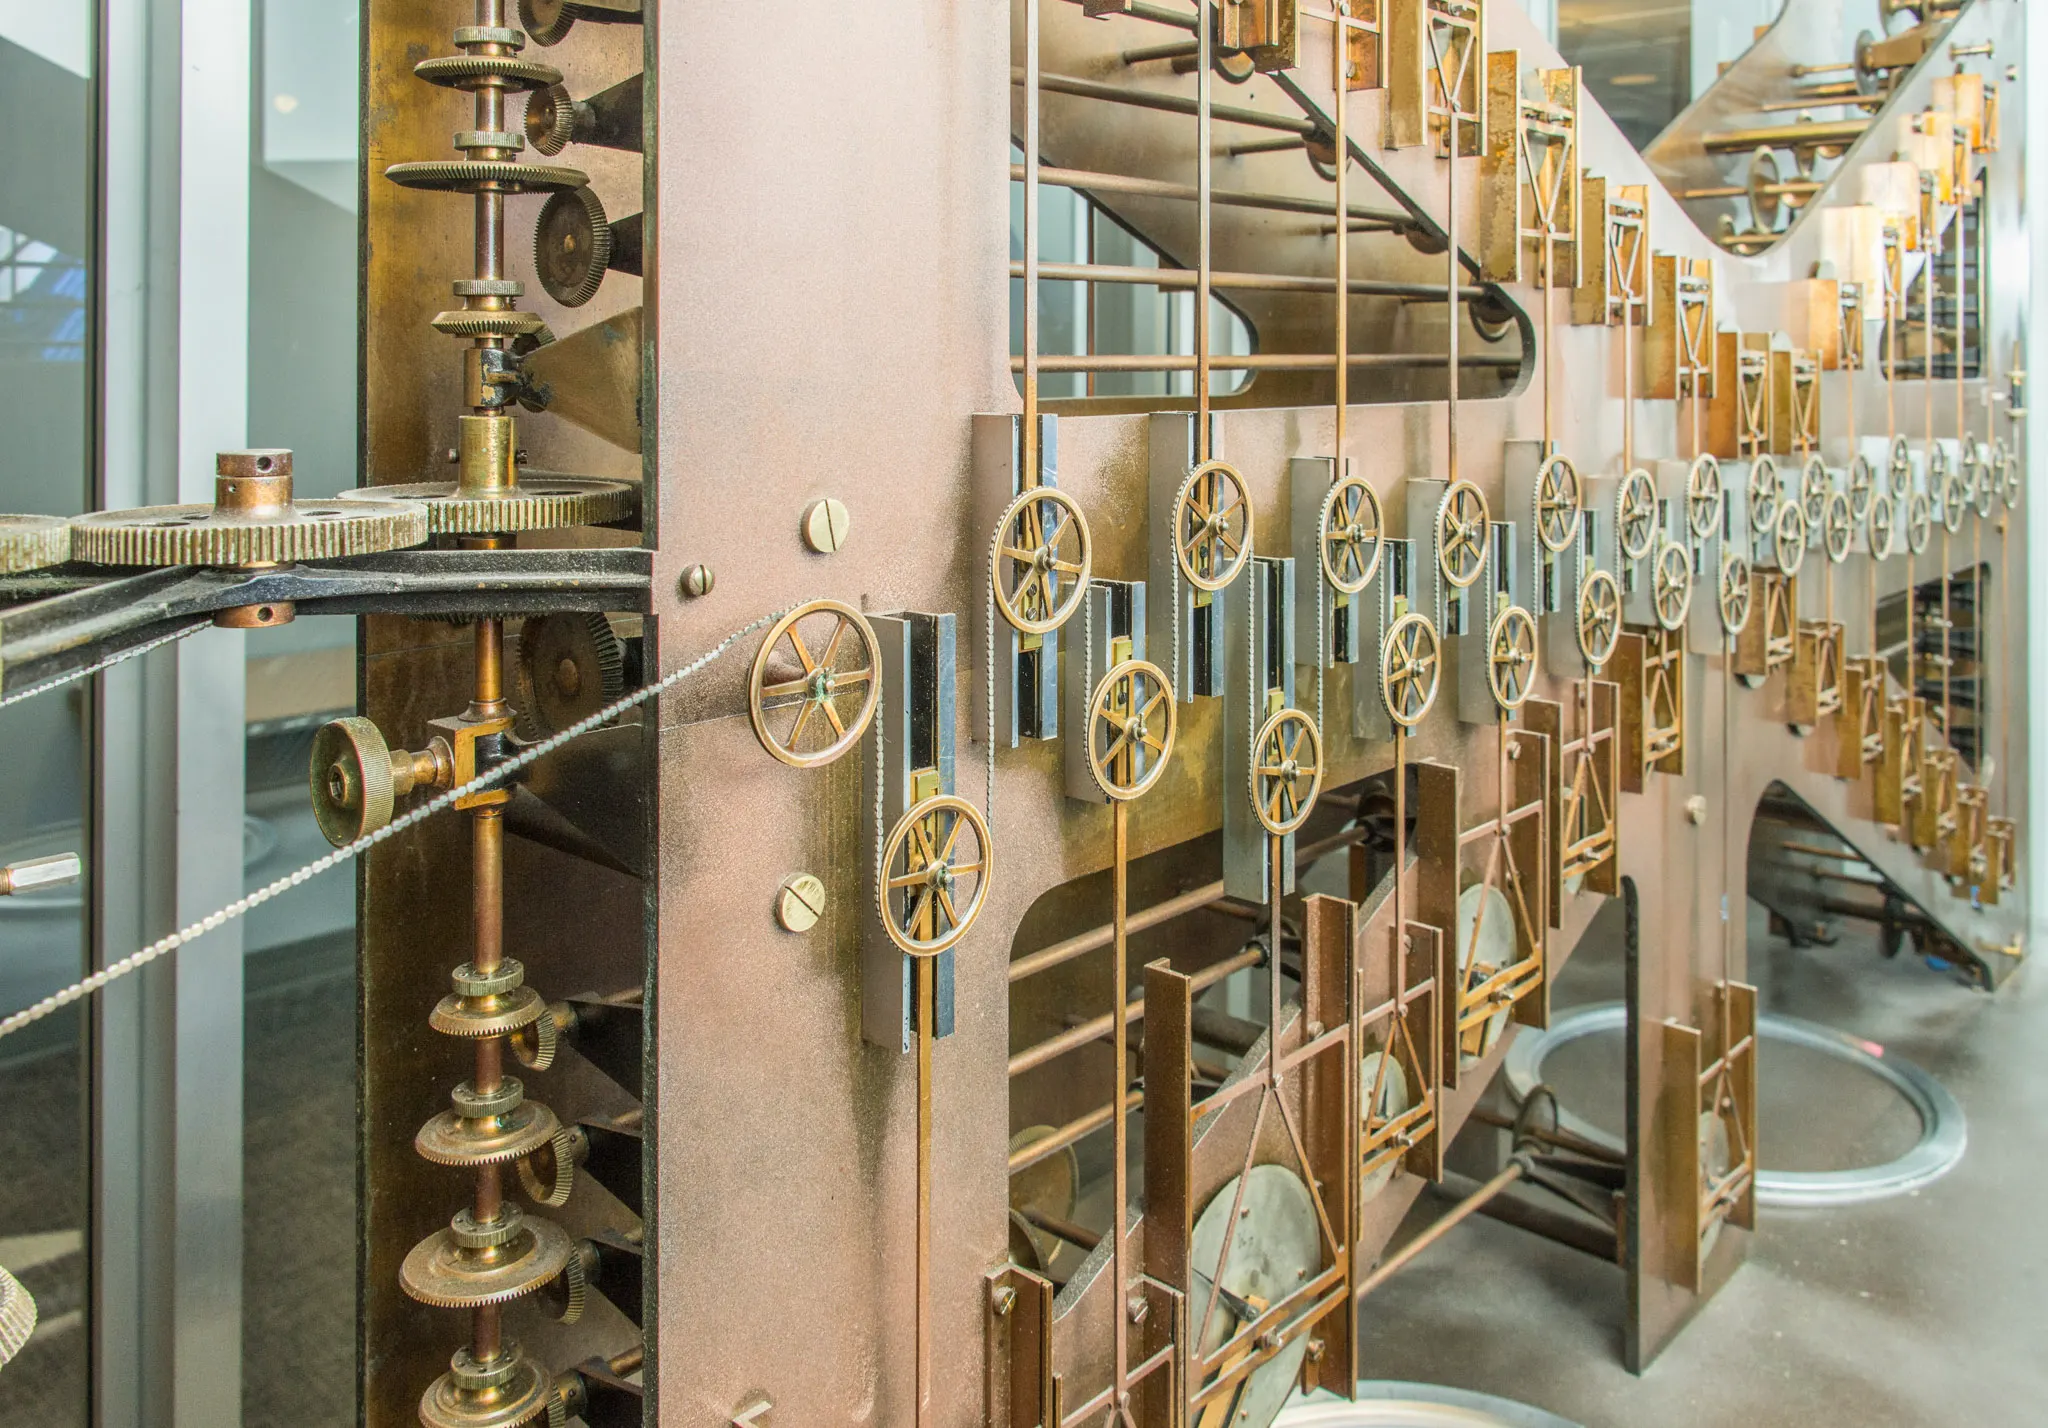
Sobre la imagen Esta máquina de bronce respondía una pregunta con exactitud: girabas la manivela y te daba la altura y la hora de cada marea de un año. Un compilador puede ser un oráculo de la misma manera, una máquina determinística a la que un agente le puede consultar y obtener siempre la misma respuesta. Tide Predicting Machine No. 2, “Old Brass Brains”, construida por el U.S. Coast and Geodetic Survey y usada para predecir mareas desde la década de 1910 hasta 1965, hoy conservada por la NOAA en Silver Spring, Maryland. Foto: Steven Fine, 2016, CC0, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Nota de la serie: esta es la puerta de entrada más práctica a la serie sobre Concrete. Si primero querés el manifiesto más corto, leé Por qué existe Concrete. Si querés la referencia del lenguaje que está detrás de este artículo, usá la especificación de Concrete.
Hace un tiempo que vengo construyendo Concrete. Esta semana pasó algo que no tenía planeado, y puede terminar importando más que las cosas que me propuse construir a propósito.
Dejé que un agente de IA mejorara un programa en Concrete usando como feedback solamente los reportes del compilador. Sin profiler. Sin benchmarks. El agente leía lo que el compilador sabía del programa, probaba refactorizaciones, verificaba si las respuestas del compilador mejoraban, y se quedaba con el cambio o lo revertía. Funcionó mejor de lo que esperaba. El compilador había dejado el espacio de búsqueda lo suficientemente limpio como para que el agente no tuviera que andar a ciegas entre la niebla de los benchmarks.
Eso apunta a por qué Concrete es útil en primer lugar. Un lenguaje que hace explícitas la autoridad, la asignación de memoria (allocation), las fronteras de confianza (trust boundaries) y la superficie de prueba es más fácil de auditar, más fácil de optimizar y más fácil de automatizar. No tenés que reconstruir la verdad a partir de trazas de profiler, documentación desactualizada e intuición de los revisores. El compilador te puede decir qué es cierto sobre el programa, y eso cambia cómo construís software de sistemas. Para explicar por qué, tengo que empezar por qué es Concrete y qué lo hace distinto.
#Qué es Concrete
Concrete es un lenguaje de sistemas. Compila a código nativo a través de LLVM, tiene layout de memoria explícito, ownership manual, FFI a C y no tiene garbage collector. Está en el mismo espacio que Rust y Zig. Pero hace una serie de apuestas de diseño que esos lenguajes no hacen, y esas apuestas son las que hicieron posible el experimento de esta semana.
La gramática es LL(1). Todo el lenguaje se parsea con un token de lookahead. Sin construcciones ambiguas, sin parsing dependiente del contexto. Elegí esta restricción a propósito. Significa que cada programa tiene un solo parseo, que todas las herramientas ven la misma estructura y que la superficie sintáctica es chica. Te podés meter la gramática entera en la cabeza.
El ownership es lineal, no afín. En Rust, el ownership es afín: los valores se pueden usar como mucho una vez, pero también te los podés olvidar y el compilador va a insertar una llamada a Drop por detrás. En Concrete, los valores con dueño tienen que consumirse una vez. Si te olvidás de limpiar un recurso, el programa no compila. La limpieza (cleanup) es explícita, con destroy y defer. Es más estricto que Rust y más molesto de escribir, pero significa que el compilador puede razonar por completo sobre los lifetimes de los recursos. No se ejecuta ningún código de limpieza invisible a tus espaldas.
Las capabilities (capacidades) reemplazan el modelo de autoridad ambiente. Esta es la grande. En la mayoría de los lenguajes de sistemas, una función puede hacer cualquier cosa que el proceso tenga permitido hacer. Una función sin anotaciones especiales puede abrir archivos, abrir conexiones de red, asignar memoria sin límite y llamar a C. Te enterás de lo que hace una función leyendo su implementación, o confiando en su documentación.
En Concrete, cada función declara qué tiene permitido hacer:
fn sha256(data: &Bytes) with(Alloc) -> String { ... }
fn serve(port: u16) with(Network, Alloc, Console) -> Int { ... }
fn allow_command(cmd: Command, policy: Policy) -> Decision { ... }
sha256 puede asignar memoria pero no puede tocar el sistema de archivos ni la red. El compilador lo hace cumplir desde el sistema de tipos. serve puede usar la red, asignar memoria y escribir en la consola, pero no puede leer archivos. allow_command no tiene ninguna anotación de capability. Es pura. Una función solo puede llamar a funciones cuyas capabilities sean un subconjunto de las suyas.
El vocabulario concreto de capabilities incluye File, Network, Clock, Env, Random, Process, Console, Alloc y Unsafe, con Std y alias definidos por el usuario que se expanden a esos nombres concretos. Si una función no declara una, no puede alcanzar transitivamente ninguna función que la use. Esto lo hace cumplir el sistema de tipos, no una convención.
La confianza se divide en tres. Rust tiene una sola palabra clave para todo lo que el compilador no puede verificar: unsafe. En Concrete, eso se divide en tres mecanismos distintos:
- Capabilities (
with(File, Network)): efectos semánticos visibles para quien llama. “Esta función hace I/O.” En la firma de la función. trusted: contención de trucos a nivel de punteros detrás de una API segura. Permite aritmética de punteros, desreferencia cruda y asignación cruda. NO permite FFI, NO suprime capabilities, NO relaja la linealidad.with(Unsafe): autoridad para cruzar fronteras foráneas. FFI, transmute. Se exige incluso dentro de códigotrusted.
Cuando ves trusted fn load_policy(path: &String) with(File, Alloc), sabés que: hace trabajo con punteros internamente, lee archivos y asigna memoria, y no puede tocar la red. En Rust verías unsafe y tendrías que leer el cuerpo para enterarte de cualquiera de esas cosas.
El compilador está escrito en Lean 4. Elegí Lean porque es un buen lenguaje, y eso creó una oportunidad estructural: cada programa en Concrete se convierte en datos de Lean durante la compilación. Esos datos pueden alimentar herramientas de prueba sin pasar por un parser y un modelo separados. Lo que esperaba que pasara empezó a pasar: podés escribir contratos en el código fuente (source contracts), convertirlos en obligaciones de prueba, adjuntar evidencia verificada por Lean y ver cuándo esa evidencia queda desactualizada (stale). Esto todavía no es verificación de punta a punta del binario. Es un puente que funciona entre código de sistemas común y afirmaciones verificadas por máquina sobre ese código.
Nada de comportamiento oculto. Nada de destructores implícitos al salir de un scope. Nada de unwinding de excepciones. Nada de sobrecarga de operadores. Nada de closures con captura oculta. Nada de trait objects. Nada de coerciones Deref. Nada de sistema de macros. El código que leés es el código que se ejecuta. Esto hace que el lenguaje sea menos cómodo que Rust en muchos sentidos, y creo que es la concesión (trade-off) correcta para el dominio al que apunta Concrete: firmware, fronteras de seguridad, políticas criptográficas y componentes críticos para la seguridad.
Rust es excelente para hacer cumplir propiedades de seguridad. Concrete es mejor para convertir al compilador en un tablero de instrumentos en vez de una luz de “check engine”.
Esa es la afirmación práctica detrás del lenguaje. Si estás construyendo firmware, infraestructura sensible en seguridad, software criptográfico o cualquier otra cosa donde el comportamiento oculto sale caro, Concrete te da un compilador que puede responder directamente preguntas de más alto nivel: qué funciones pueden asignar memoria, qué módulos ganaron autoridad, qué código es lo suficientemente puro como para probarlo, qué fronteras de confianza se movieron. En la mayoría de los lenguajes, esas respuestas las armás juntando pedazos de code review, profiling, documentación y herramientas de análisis estático que coinciden solo en parte. En Concrete, salen de la semántica misma del lenguaje.
#El compilador como oráculo
Todas estas decisiones de diseño producen la misma consecuencia estructural: el compilador sabe muchísimo sobre lo que hace cada función de tu programa, y lo sabe por el sistema de tipos, no por heurísticas.
La mayoría de los compiladores tiran este conocimiento a la basura después de producir un binario. Concrete lo conserva y lo expone. La superficie exacta de reportes fue creciendo, pero los modos importantes incluyen:
--report eligibility: qué funciones son lo suficientemente puras como para probarlas, y qué compuertas de prueba no pasan--report proof-status: qué afirmaciones están probadas, desactualizadas, faltantes, bloqueadas, no elegibles o trusted--report proof-bundle: un paquete de evidencia en JSON con el estado de prueba, supuestos, entradas del registro y hechos de dependencias--report contracts,--report vcsy--report obligation-ledger: contratos en el código fuente, condiciones de verificación generadas y estado de las obligaciones--report audity--report traceability: clases de evidencia, fronteras trusted y hechos que van del código fuente al backend--report authority: para cada capability, qué funciones la requieren y a través de qué cadena de llamadas transitiva--report alloc: dónde ocurren la asignación, la limpieza y los defer--report unsafe: fronteras de confianza, funciones extern, cruces unsafe--report caps: conjuntos de capabilities por función--report layout: tamaños de structs, alineación, offsets de campos--report interface: superficie de la API pública--report mono: código genérico monomorfizado
Son hechos estructurados que salen del mismo análisis semántico que hace el type checking del código. Mismo código, mismo reporte, mismo resultado. Determinístico.
El reporte de elegibilidad para prueba de nuestro parser de JSON se veía así:
=== Proof Eligibility Report ===

module Types:
  ✓ mk_null
  ✓ mk_bool
  ✓ mk_number
  ✓ mk_string
  ✓ mk_array
  ✓ mk_object
  ✓ mk_error
  ✓ is_error

module StringPool:
  ✗ store  (requires capabilities: Alloc)

module Lex:
  ✓ is_ws
  ✓ is_digit
  ✓ skip_ws
  ✓ match_keyword

module Parser:
  ✓ err
  ✗ parse_string  (requires capabilities: Alloc)
  ✓ parse_number
  ✗ parse_value  (requires capabilities: Alloc)
  ✗ parse_array  (requires capabilities: Alloc)
  ✗ parse_object  (requires capabilities: Alloc)
  ✗ parse_kv  (requires capabilities: Alloc)

Totals: 27 functions, 14 eligible for ProofCore, 13 excluded
Cada función recibe un veredicto y una razón. El reporte de autoridad muestra las cadenas de llamadas transitivas:
capability Alloc (13 functions):
  pub store  <- store -> vec_push
      parse_string  <- parse_string -> store
  pub parse_value  <- parse_value -> parse_string
      parse_array  <- parse_array -> vec_push
      parse_object  <- parse_object -> vec_push
      parse_kv  <- parse_kv -> parse_string
parse_value necesita Alloc porque llama a parse_string, que llama a store, que llama a vec_push. El compilador te dice el camino completo. Un revisor humano lee esto y sabe qué dependencia cortar. Un agente lee esto y tiene un objetivo.
#El experimento
Le apunté un agente de IA al parser de JSON de Concrete. 719 líneas, descenso recursivo, maneja la especificación completa de JSON menos los floats y los escapes unicode. Código real que ya fue puesto a prueba. Las únicas herramientas del agente eran los reportes del compilador y la posibilidad de editar código y correr el programa.
Punto de partida: 14/27 funciones elegibles para prueba (51,9%).
La pregunta: ¿puede el agente, guiado solamente por reportes estructurados del compilador, mejorar este programa paso a paso?
#Ronda 1: extraer lógica pura
El agente leyó el reporte de pruebas y notó que varias funciones excluidas tenían lógica de decisión pura enterrada adentro.
parse_string maneja secuencias de escape. El mapeo de \n al código de carácter 10, de \" a 34, de \\ a 92, y así, es lógica de decisión pura. No asigna memoria. No hace I/O. Pero estaba inlineada dentro de una función que asigna memoria, así que el compilador no podía verla como un objetivo de prueba separado.
El agente la extrajo a su propia función:
pub fn map_escape(esc: i32) -> i32 {
    if esc == 34 { return 34; }   // \"
    if esc == 92 { return 92; }   // \\
    if esc == 47 { return 47; }   // \/
    if esc == 110 { return 10; }  // \n
    if esc == 116 { return 9; }   // \t
    if esc == 114 { return 13; }  // \r
    if esc == 98 { return 8; }    // \b
    if esc == 102 { return 12; }  // \f
    return 0 - 1;
}
El mismo patrón para la clasificación de caracteres en parse_value (“¿este carácter es el comienzo de un string, un número, un array o un objeto?”), la comparación de valores en el harness de tests y la validación de contenido sobrante al final en parse_json.
El loop después de cada extracción era simple:
- Correr los reportes de elegibilidad y de estado de prueba. ¿Subió la cantidad de funciones elegibles para prueba?
- Correr el programa. ¿Sigue pasando?
- ¿Sí a las dos? Quedarse con el cambio.
Después de esta ronda: 19/32 elegibles para prueba (59,4%). Cinco funciones puras nuevas, todas extraídas de código con efectos sin cambiar el comportamiento.
El agente no necesitó entender qué hace el parser de JSON. No necesitó saber qué es JSON. Leyó un reporte estructurado, identificó funciones excluidas por una razón específica, encontró lógica pura mezclada con lógica con efectos dentro de esas funciones y las separó. El reporte era la guía. El compilador confirmó el resultado.
#Ronda 2: eliminar asignaciones innecesarias
Después el agente miró --report alloc.
parse_value es el núcleo recursivo del parser. Cada valor JSON pasa por ahí. Y cada llamada estaba asignando en el heap tres strings para chequear palabras clave:
let kw_true: String = "true";
defer drop_string(kw_true);
if match_keyword(s, p, &kw_true) {
    return ParseResult { val: mk_bool(1), pos: p + 4 };
}

let kw_false: String = "false";
defer drop_string(kw_false);
// ...same for "null"
Tres pares malloc/free por llamada a parse_value, para comparar un puñado de caracteres. En JSON anidado, parse_value es recursiva. Un objeto como {"a": {"b": {"c": true}}} la llama cuatro veces, y produce doce asignaciones en el heap innecesarias para un solo documento chico. En un archivo JSON grande con miles de valores, son miles de ciclos malloc/free desperdiciados.
El arreglo era obvio una vez que el reporte lo señaló: matchear palabras clave comparando caracteres directamente, sin necesidad de asignar en el heap:
pub fn match_true(s: &String, pos: i32) -> bool {
    let slen: i32 = string_length(s) as i32;
    if pos + 4 > slen { return false; }
    return string_char_at(s, pos as Int) as i32 == 116       // t
        && string_char_at(s, (pos + 1) as Int) as i32 == 114 // r
        && string_char_at(s, (pos + 2) as Int) as i32 == 117 // u
        && string_char_at(s, (pos + 3) as Int) as i32 == 101;// e
}
Después de este cambio, parse_value desapareció del reporte de asignaciones.
Resultado final: 22/35 elegibles para prueba (62,9%), y parse_value ya no asigna memoria para chequear palabras clave.
Ese fue el momento en que esto dejó de parecer un truco de salón.
#Hacer menos es hacer más
Las dos mejoras salieron de la misma refactorización. Extraer lógica pura y eliminar asignaciones innecesarias fueron el mismo movimiento.
Los matchers de palabras clave sin asignación de memoria también son funciones puras. Aparecen en los dos reportes: desaparecen del reporte de asignaciones y se suman al reporte de pruebas. Mejor arquitectura y mejor performance, confirmadas por dos reportes distintos del compilador, a partir de un solo cambio estructural.
En la mayoría de los codebases, la optimización de performance y la calidad del código parecen preocupaciones separadas. Optimizás velocidad en una pasada, refactorizás para que quede claro en otra, y a veces chocan. La versión más rápida es más difícil de leer, la versión más limpia es más lenta. El compilador hizo visible algo que siempre fue cierto pero difícil de ver: la versión más simple de una función, la que hace solo lo que necesita hacer, sin asignaciones incidentales y sin mezclar responsabilidades, es al mismo tiempo la más rápida, la más auditable y la más fácil de probar.
Esto se desprende de cómo funcionan los reportes de Concrete. Una función que hace menos necesita menos capabilities. Menos capabilities significa más probabilidad de ser pura. Pura significa elegible para prueba. Sin asignaciones incidentales significa más rápida. Son la misma propiedad, la simplicidad, medida desde ángulos distintos. Los reportes la hacen visible.
Un agente que optimiza cualquiera de estos ejes tiende a mejorar los otros. Esa es una propiedad útil para un loop automatizado. El espacio de búsqueda no es adversarial. No estás cambiando elegibilidad para prueba por performance ni auditabilidad por velocidad. Empujás en una dirección y obtenés mejoras en todos los frentes.
#Por qué esto no funciona en otros lenguajes
En Rust, encontrar asignaciones innecesarias significa hacer profiling. Corrés benchmarks, levantás un profiler de heap, te quedás mirando flamegraphs, tratás de descifrar qué asignaciones son incidentales y cuáles esenciales, refactorizás, volvés a hacer profiling y rezás para que los números hayan mejorado. El compilador no te dice nada sobre los patrones de asignación. Dice pasa o no pasa.
Un agente de IA que hiciera esto en Rust tendría que generar código de benchmarks, correr benchmarks (ruidosos, dependen de la carga del sistema), parsear la salida del profiler (específica de cada herramienta, muchas veces visual), adivinar qué asignaciones son innecesarias, refactorizar, volver a correr los benchmarks y rezar para que el ruido no tape la señal.
En Concrete, el agente leyó --report alloc, vio tres puntos de limpieza en parse_value, leyó --report authority para entender la cadena de llamadas, reemplazó las asignaciones con comparaciones directas de caracteres y confirmó con --report alloc que parse_value había desaparecido del reporte. Sin profiler. Sin ruido de benchmarks. Señal determinística.
El compilador de Rust no modela estas propiedades de la misma manera. Rust no trata la asignación de memoria como una propiedad semántica de primera clase. No tiene sistema de capabilities. No distingue entre “esta función asigna memoria porque lo necesita” y “esta función asigna memoria por un patrón de conveniencia”. La información no está ahí para que el compilador la reporte.
Esta es una cuestión de diseño del lenguaje. No se le puede agregar esto a un lenguaje existente a posteriori. El seguimiento tiene que estar en el sistema de tipos y en las firmas de las funciones. Si with(Alloc) no está en el lenguaje, el compilador no puede calcular la cadena de autoridad transitiva para la asignación de memoria. Si las capabilities no están en las firmas de las funciones, el compilador no puede determinar qué funciones son puras. Los reportes existen porque el lenguaje se diseñó para hacerlos posibles.
#El problema de la señal de feedback
Andrej Karpathy viene hablando de “autoresearch”: loops automatizados en los que un agente prueba cambios y usa alguna señal para decidir si se queda con ellos. El cuello de botella siempre es la función de fitness (fitness function).
Los números de los benchmarks son ruidosos. Una mejora del 2% puede ser error de medición. Una regresión del 5% puede ser carga del sistema. Las suites de tests son binarias: pasa o no pasa, sin gradiente. Las herramientas de análisis estático producen warnings que pueden importar o no. Ninguna de estas cosas le da a un agente una señal limpia contra la cual optimizar. La mayor parte del tiempo estás navegando según el clima.
Los reportes del compilador son determinísticos. “¿Está parse_value en el reporte de asignaciones?” tiene una sola respuesta. “¿Cuántas funciones son elegibles para prueba?” es un número que no cambia entre corridas. “La cadena de autoridad transitiva para esta capability” es un hecho estructurado que el agente puede parsear y sobre el que puede razonar. Son propiedades exactas de la estructura semántica del programa.
Esto convierte la optimización de programas en un problema de búsqueda con una función de fitness confiable. Eso es lo que lo vuelve tratable para agentes automatizados.
#Las líneas de investigación, y por qué todas se convierten en funciones de fitness
El experimento usó tres reportes. Pero venimos desarrollando líneas de investigación para Concrete que agregan ejes nuevos cada una:
Presupuestos de autoridad. Hoy las capabilities son hechos reales por función. Los presupuestos de autoridad extienden esa idea a módulos y paquetes. Imaginate que dependés de una biblioteca para parsear JSON. Declarás:
#[authority(Alloc)]
import json_parser;
Eso es un contrato: json_parser solo puede usar Alloc. Si el próximo release del mantenedor agrega una llamada de logging, aunque esté enterrada tres capas más abajo en una función auxiliar, tu build se rompe. La dependencia violó su presupuesto de autoridad. No necesitaste leer el changelog ni auditar el código fuente. El compilador verificó el conjunto transitivo de capabilities, que ya calcula, y encontró que excedía el presupuesto.
Esta es la línea de la cadena de suministro (supply chain): hacer que la deriva de autoridad falle cerrada en vez de depender de un changelog o de una auditoría manual. En Rust o en Go, una dependencia puede agregar acceso a la red, lecturas del sistema de archivos o consultas a variables de entorno sin que te enteres, salvo que audites el código o lo agarres en una revisión. En Concrete, los hechos de capabilities subyacentes ya existen; la capa de presupuestos es la compuerta de política que convertiría un conjunto de autoridad ampliado en una falla en tiempo de compilación. Para un agente: reestructurar el código hasta que el conjunto de capabilities de un módulo entre en su presupuesto declarado.
Presupuestos de asignación. Hoy with(Alloc) es binario. La propuesta clasifica las funciones como NoAlloc, Bounded (asigna memoria pero con una cota demostrable) o Unbounded. El compilador recorre el grafo de llamadas para clasificar. En código crítico para la seguridad de dispositivos médicos, aviónica o control industrial, muchas veces necesitás probar que una función no puede asignar memoria sin límite. Hoy eso es una auditoría manual. Con presupuestos de asignación, lo clasifica el compilador. Para un agente: llevar funciones de Unbounded a Bounded y a NoAlloc, con el compilador confirmando cada paso.
Seguimiento del costo de ejecución. Hacer las preguntas que de verdad le importan a un revisor: ¿esta función tiene loops?, ¿el loop está acotado?, ¿hay recursión?, ¿qué tan profunda puede ser la cadena de llamadas estática? Concrete hace que esas preguntas sean más tratables porque no hay dispatch dinámico, ni closures con captura oculta, ni asignaciones ocultas, y el CFG en SSA es limpio. Los callbacks explícitos siguen existiendo, pero la función, el contexto y las capabilities son todos visibles. Para funciones acotadas, se pueden calcular cantidades abstractas de instrucciones. Combinado con los presupuestos de asignación, “esta función corre en tiempo acotado con asignación acotada” pasa a ser el tipo de frase que le podés llevar a un certificador de seguridad. Para un agente: identificar loops no acotados y tratar de acotarlos, con el compilador verificando que la clasificación cambió.
Diff semántico y deriva de confianza. Hoy, hacer code review significa leer diffs del código fuente. Ves que alguien cambió 200 líneas en cuatro archivos. Tratás de descifrar si cambió algo importante del comportamiento del programa. Se te puede pasar que una función auxiliar ahora alcanza transitivamente la red, o que una función que antes era pura empezó a asignar memoria.
El diff semántico reemplaza esto con una comparación estructurada de los reportes del compilador entre dos versiones. La salida se vería más o menos así:
authority changes:
  + process_request now requires Network (via log_to_server)
  - validate_input no longer requires File

proof surface:
  - parse_header dropped from ProofCore (now requires Alloc)

trust boundaries:
  + new trusted function: fast_copy
La salida no es “las líneas que cambiaron” sino “las propiedades de confianza que cambiaron”. Un revisor lee esto y sabe qué mirar con lupa. Una compuerta de CI lee esto y bloquea un PR que agrega autoridad Network a un módulo que antes no tenía ninguna, porque se violó una política semántica. Para un agente: marcar regresiones de confianza y tratar de arreglarlas antes de que lleguen a code review.
Arquitectura de pruebas como complemento. El compilador produce artefactos semánticos estables y reportes de evidencia (Core, ProofCore, estado de prueba, paquetes de pruebas). Las herramientas de prueba, incluyendo Lean, procedimientos de decisión del kernel y solvers externos opcionales, consumen esos hechos en vez de estar fusionadas con la compilación común. Que falle una prueba no significa automáticamente que falle la compilación, salvo que un perfil o una política digan que sí. Podés publicar código que compila e ir ampliando la cobertura de pruebas con el tiempo. ProofCore es el subconjunto puro: funciones sin capabilities, que no son trusted, sin llamadas extern. El experimento de autoresearch, extraer lógica pura para hacer crecer ProofCore, es el flujo de trabajo que esta arquitectura habilita.
Cada una de estas cosas se diseñó para consumo humano. Cada una también produce una función de fitness contra la cual un agente puede optimizar. Si el compilador puede afirmar un hecho con la claridad suficiente para que un humano actúe en base a él, es lo suficientemente claro para que también actúe un agente.
#La auditabilidad y la optimizabilidad son lo mismo
Diseñé el sistema de reportes para auditores humanos que necesitan entender qué hace un programa sin leer cada línea. Quería que un revisor de seguridad pudiera preguntar “¿qué autoridad tiene este módulo?” y obtener una respuesta del compilador, no de documentación que podría estar desactualizada. Construí los reportes para auditoría. No esperaba que se convirtieran en una interfaz para optimizar.
La auditabilidad y la optimización por máquinas son la misma propiedad vista desde dos ángulos. Las propiedades que hacen auditable a un programa (capabilities explícitas, fronteras de confianza visibles, asignación de memoria rastreable) son las mismas propiedades que le dan a un agente una función de fitness confiable. Hacer que el lenguaje sea honesto sobre lo que hace el código, en beneficio de los revisores humanos, lo volvió optimizable por máquinas como efecto secundario.
Un programa auditable es uno en el que el compilador puede afirmar hechos sobre su comportamiento sin ejecutar el código. Un programa optimizable es uno en el que el compilador puede confirmar que un cambio mejoró alguna propiedad sin correr benchmarks. Son casi el mismo requisito. Si el compilador puede decir “esta función necesita Network por esta cadena de llamadas”, un humano lo puede auditar y un agente puede tratar de eliminarlo.
Yo estaba pensando en un humano que revisa una herramienta de actualización de firmware y quiere saber “¿esta función puede acceder a la red?”. Que la misma respuesta le sirva a un optimizador automatizado dice algo sobre lo que deberían hacer los compiladores.
#La apuesta
El parser de JSON fue un solo programa. El intérprete de MAL de Concrete tiene 60 funciones, con 24 excluidas de ProofCore. El mismo loop debería funcionar ahí, y en cualquier programa sobre el que el compilador pueda reportar. La técnica se generaliza porque los reportes se generalizan.
La visión es un compilador que participe en el loop de desarrollo como algo más que un guardián de la puerta. La mayoría de los compiladores dicen pasa o no pasa. Con reportes estructurados, el compilador dice qué es cierto sobre tu programa. Con presupuestos de autoridad, dice qué prometiste que iba a ser cierto, y dónde la realidad se aparta. Con diff semántico, dice qué cambió en las propiedades de confianza de tu programa desde la última versión. Cada capa les da más con qué trabajar tanto a humanos como a agentes, y las capas se apoyan unas en otras.
El compilador se convierte en un oráculo: una fuente de conocimiento estructurado sobre el comportamiento del programa. El agente se convierte en un optimizador que prueba miles de refactorizaciones y se queda con las que mueven esas respuestas en la dirección correcta. El programador fija los objetivos, elige qué propiedades importan y qué presupuestos hacer cumplir, y revisa los resultados. La recompensa es concreta, no una elegancia abstracta: auditorías más ajustadas, fronteras de seguridad más claras, menos adivinanza con la performance y un loop de desarrollo en el que humanos y máquinas se guían por el mismo mapa.
Un lenguaje que el compilador puede explicar, y que las máquinas pueden mejorar, porque se diseñó para ser honesto sobre lo que hace el código.
De la serie Concrete.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.