Diseñar un lenguaje de programación para la era de la IA
Edgar Luque tiene razón en que la IA crea una nueva barrera para los lenguajes de programación. Se equivoca en que la barrera sea universal. Los lenguajes diseñados para la generación y la verificación por máquinas invierten el problema por completo.
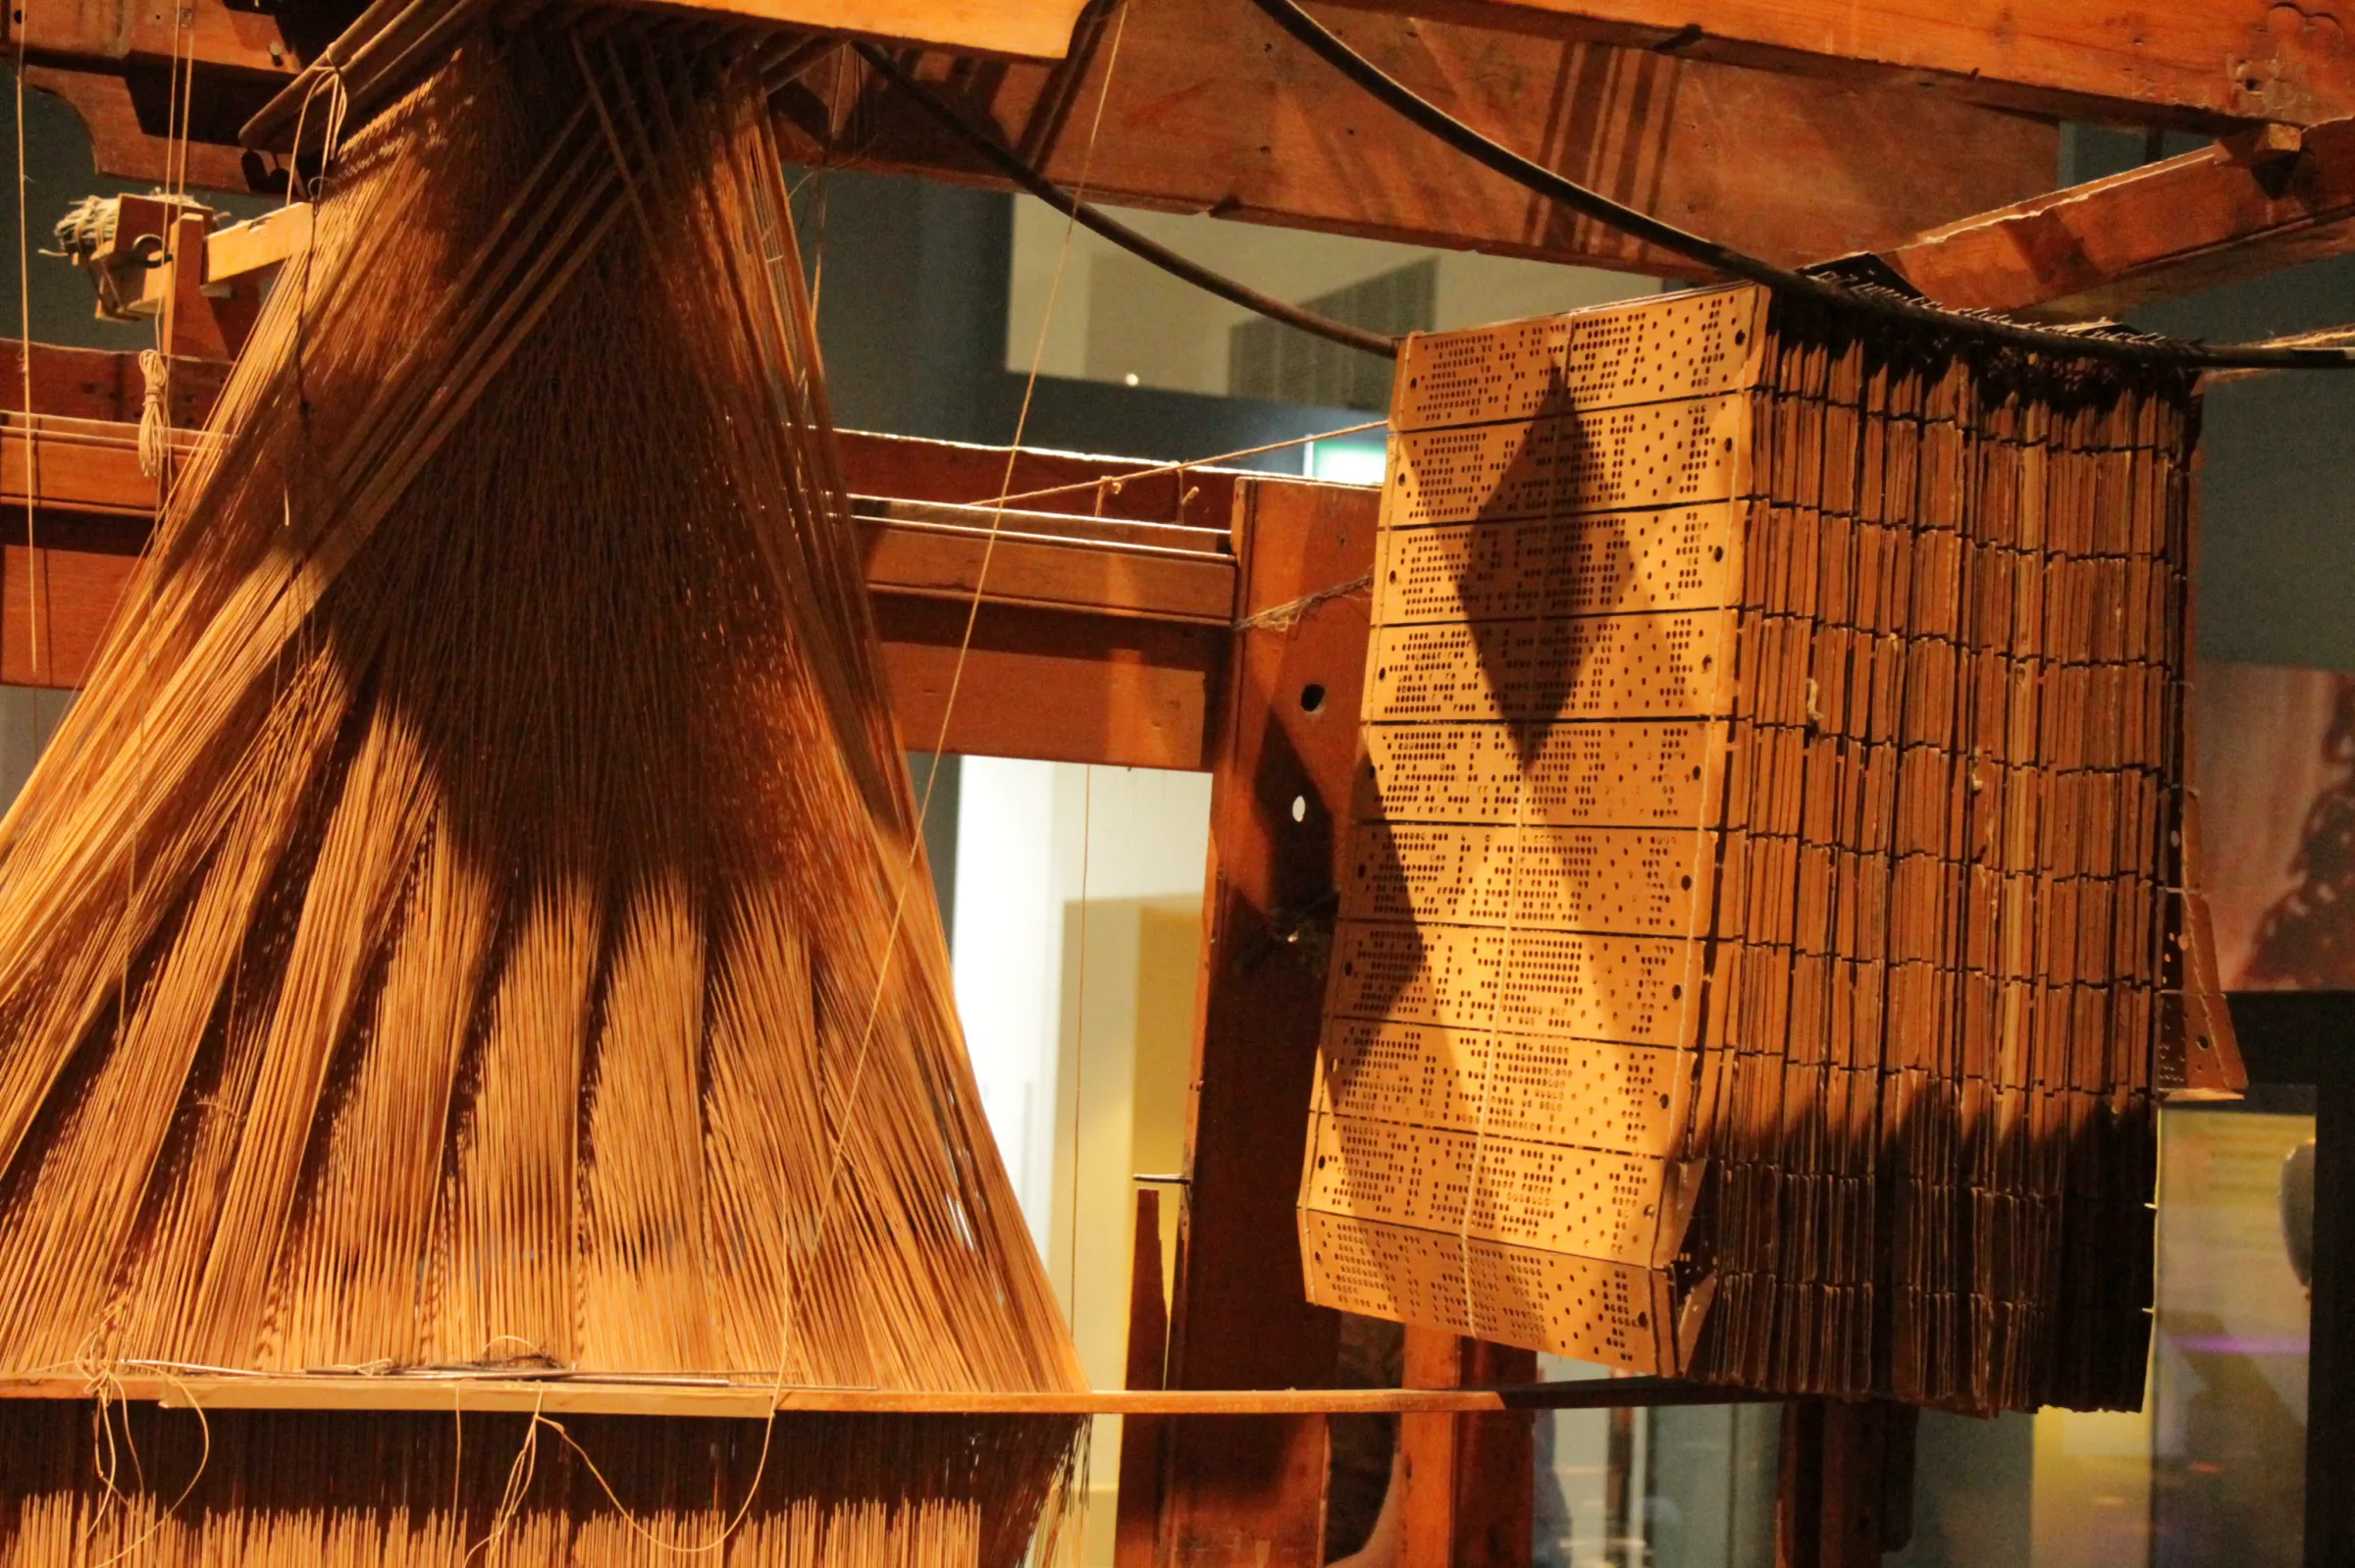
Sobre la imagen Las tarjetas Jacquard eran un lenguaje escrito para que lo leyera una máquina, y el tejido verificaba cada tarjeta contra el patrón mientras corría. Un lenguaje diseñado para la generación y la verificación por máquinas parte de la misma premisa. Un telar Jacquard con su cadena de tarjetas perforadas de patrones, National Museum of Scotland, Edimburgo, 2019. Foto: Stephencdickson, CC BY-SA 4.0, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Nota de la serie: este artículo da por sentado el marco básico de Concrete y se hace una pregunta más acotada sobre la adopción de lenguajes en la era de la IA. Para la base de la serie, leé Por qué existe Concrete. Para la comparación principal con Rust, leé El debate sobre efectos en Rust y el argumento de Concrete a favor de un lenguaje más chico.
Edgar Luque escribió hace poco sobre cómo la IA crea una nueva barrera de adopción para los lenguajes de programación. Su argumento es que los asistentes de código con IA necesitan datos de entrenamiento, que los datos de entrenamiento solo existen para los lenguajes populares, y que entonces los lenguajes nuevos tienen mal soporte de IA, lo que impide su adopción, lo que a su vez impide que se acumulen datos de entrenamiento. Un ciclo que se refuerza solo y deja atornillado lo que ya domina.
Si estás construyendo un lenguaje nuevo de propósito general que compite con Python, Go o Rust más o menos en los mismos términos, el análisis de Luque es demoledor. Lo que lo hace peor que las barreras de adopción anteriores es que no podés salir de esto a fuerza de esfuerzo comunitario. Los pipelines de entrenamiento de IA son de un puñado de empresas, y esas empresas siempre van a priorizar los lenguajes donde ya existe más data.
Pero hay un punto ciego en el argumento.
#Dónde creo que Luque se equivoca
Luque supone que los lenguajes son consumidores pasivos del soporte de IA. ¿Pero qué pasa si un lenguaje está diseñado para que las máquinas puedan razonar sobre él mejor de lo que razonan sobre los lenguajes establecidos, porque es lo bastante simple y explícito como para que un LLM pueda trabajar en buena medida a partir de la especificación?
Los lenguajes establecidos cargan cantidades enormes de conocimiento tácito: modismos, convenciones, rodeos y reglas no escritas que viven solo en la práctica colectiva de millones de desarrolladores. Pensá en el for/else de Python y en el hecho de que la mayoría de los desarrolladores con experiencia lo evitan por completo, o en las convenciones de manejo de errores de Go que no están en ningún lado de la especificación del lenguaje, o en la diferencia sutil en Rust entre cuándo conviene usar unwrap y cuándo conviene propagar con ?. Un LLM necesita un corpus enorme justamente porque necesita absorber todo este conocimiento no escrito a pura exposición. Como escribí en Legibility Kills What It Measures, Michael Polanyi llamó a esto la dimensión tácita: “sabemos más de lo que podemos decir”. Cuanto más grande es la dimensión tácita de un lenguaje, más datos de entrenamiento necesitás antes de que una IA pueda moverse en él.
Un lenguaje que elimina suficiente conocimiento tácito cambia el ciclo. Cuando más de lo que importa ya está en la gramática, en los tipos y en las anotaciones de capabilities (capacidades), la especificación carga con mucho más del peso. Concrete está diseñado alrededor de este principio.
#Qué hace distinto Concrete
Cada decisión de diseño apunta en la misma dirección: minimizar la ambigüedad, maximizar lo que una herramienta puede deducir con solo leer el código.
Gramática LL(1). Todo el lenguaje se parsea con un token de lookahead. Nada de construcciones ambiguas, nada de reglas de parseo que dependen del contexto. La superficie sintáctica es genuinamente chica.
Flujo de control explícito. Lo que leés es lo que se ejecuta. Nada de destructores implícitos al salir del scope, nada de excepciones desenrollando la pila por caminos invisibles, nada de sobrecarga de operadores cambiando en silencio lo que hace +.
Capabilities explícitas. Si una función lee un archivo, asigna memoria o toca la red, la firma lo dice: with(File), with(Network), with(Alloc). No necesitás rastrear el grafo de llamadas para saber qué podría hacer una función.
Tipos lineales. Los valores con dueño se tienen que consumir exactamente una vez. El compilador rechaza el código que se olvida de limpiar un recurso o que usa uno después de haberlo movido. Este es el tipo de bug que a los LLMs les cuesta especialmente detectar, porque requiere seguir el estado a lo largo de todo el cuerpo de una función.
Una sola forma de hacer las cosas. Nada de closures y lambdas con capturas ocultas, nada de excepciones y tipos de resultado superpuestos, nada de cinco estilos distintos de iteración. Concrete viene incorporando callbacks explícitos, pero son deliberadamente simples: la función, el contexto y las capabilities están a la vista. Menos superficie significa menos oportunidades de elegir el enfoque equivocado.
Rust es el lenguaje existente más cercano a esta lista, y justamente por eso es la comparación correcta. Pero Rust todavía carga una capa tácita grande alrededor del lenguaje núcleo: destructores implícitos vía Drop que corren al salir del scope, ningún sistema de capabilities, sobrecarga de operadores a través de traits, reglas de elisión de lifetimes, coerciones de Deref, APIs cargadas de macros y convenciones del ecosistema alrededor de async, el manejo de errores y los patrones de traits. Rust redujo el conocimiento tácito comparado con C++, pero una cantidad considerable todavía vive en la práctica y no en la especificación. Concrete empuja más lejos en la misma dirección.
Ninguna de estas features se diseñó para la IA. Las diseñé porque creo que dan un lenguaje mejor para los humanos. Hacen que el comportamiento sea más fácil de ver, las APIs más fáciles de revisar y los bugs más fáciles de atrapar antes de ejecutar. Esas mismas propiedades también hacen que a una máquina le resulte más fácil generar el lenguaje correctamente.
#Por qué esto cambia el problema de la IA
Cuando un LLM genera Python, se apoya mucho en patrones absorbidos de millones de archivos. No le queda otra, porque ninguna especificación captura cómo escriben Python realmente los desarrolladores con experiencia. Un lenguaje cuya gramática entra en unas pocas páginas y cuyo sistema de tipos y capabilities codifica la mayoría de las reglas cambia la ecuación económica. Podés pegar la especificación entera del lenguaje en una ventana de contexto. El modelo no necesita haber visto un millón de programas de Concrete para saber qué es legal; puede leer las reglas y aplicarlas.
Eso importa más ahora de lo que habría importado hace tres años. Las ventanas de contexto son lo bastante largas como para contener una especificación completa del lenguaje junto al código que se está generando. El uso de herramientas le permite al modelo llamar al compilador en medio de la generación y leer los errores. Los flujos de reparación iterativa son estándar. Todas estas tendencias ayudan a cualquier lenguaje, pero ayudan desproporcionadamente a un lenguaje chico y explícito, porque la especificación entra en el contexto y los errores del compilador son lo bastante precisos como para conducir de verdad el ciclo de corrección.
El cuello de botella pasa de “cuánto código existe en este lenguaje” a “cuánto del lenguaje se puede recuperar a partir de la especificación y del compilador”. Los lenguajes nuevos van a perder si la competencia es el tamaño bruto del corpus. Todavía pueden competir si la competencia es si un modelo puede generar código válido a partir de reglas explícitas.
#Los errores tienen que ser legibles
En Python o JavaScript, muchos programas incorrectos igual pasan la generación y llegan a ejecutarse. El LLM genera una función que se olvida de cerrar un file handle, o que se traga una excepción, o que muta estado compartido de una forma que solo se rompe con concurrencia. El bug aparece después, muchas veces lejos del momento en que se escribió el código.
En Concrete, el compilador lo atrapa. ¿Te olvidaste de consumir un valor lineal? Error de compilación. ¿Llamaste a una función que hace I/O sin la capability correcta? Error de compilación. ¿Usaste un valor después de haberlo movido? Error de compilación. Los mensajes de error le dicen al LLM exactamente qué tiene que arreglar.
La pregunta útil es si el ciclo de generar, verificar y corregir converge rápido. Los primeros intentos importan menos que la velocidad de reparación. Los errores precisos del compilador ayudan. Las fallas silenciosas en tiempo de ejecución, no.
Concrete va más lejos. Está escrito en Lean 4, y el camino hacia las pruebas ahora es real y no solo una aspiración. Podés poner un contrato al lado de una función, convertir ese contrato en obligaciones y adjuntarle evidencia al resultado. A veces esa evidencia es un teorema de Lean. A veces es un procedimiento de decisión. A veces es solo una suposición o una prueba sin terminar, y el reporte lo dice. Eso no es una prueba de todo el compilador, y no es verificación del binario de punta a punta. Es el comienzo útil de una toolchain respaldada por pruebas. A medida que crece el volumen de código generado por máquinas, los tests y la revisión humana van a quedar cada vez más atrás. Si querés garantías fuertes de corrección a esa escala, la verificación formal es el final del camino.
#Qué se sigue de esto
Luque sugiere que los lenguajes nuevos pueden sobrevivir replegándose a nichos donde la IA importa menos. La posición de Concrete es la opuesta: apuntar a un mundo donde la IA importa más, donde la mayor parte del código lo generan máquinas, y construir el lenguaje para que funcione con esa realidad en lugar de esconderse de ella.
La barrera de adopción de la IA es real. Para la mayoría de los lenguajes nuevos, hace la adopción más difícil de una forma que no pueden arreglar fácilmente. Mi opinión es que los lenguajes diseñados para la generación y la verificación por máquinas pueden competir en un eje completamente distinto. Ese es el argumento que hago a favor de Concrete.
De la serie Concrete.
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo.