La guía de Fede sobre sistemas de tipos: de generics a tipos dependientes
Una guía práctica de sistemas de tipos, desde los generics de todos los días hasta los tipos dependientes que prueban corrección, con ejemplos en Rust, Scala e Idris
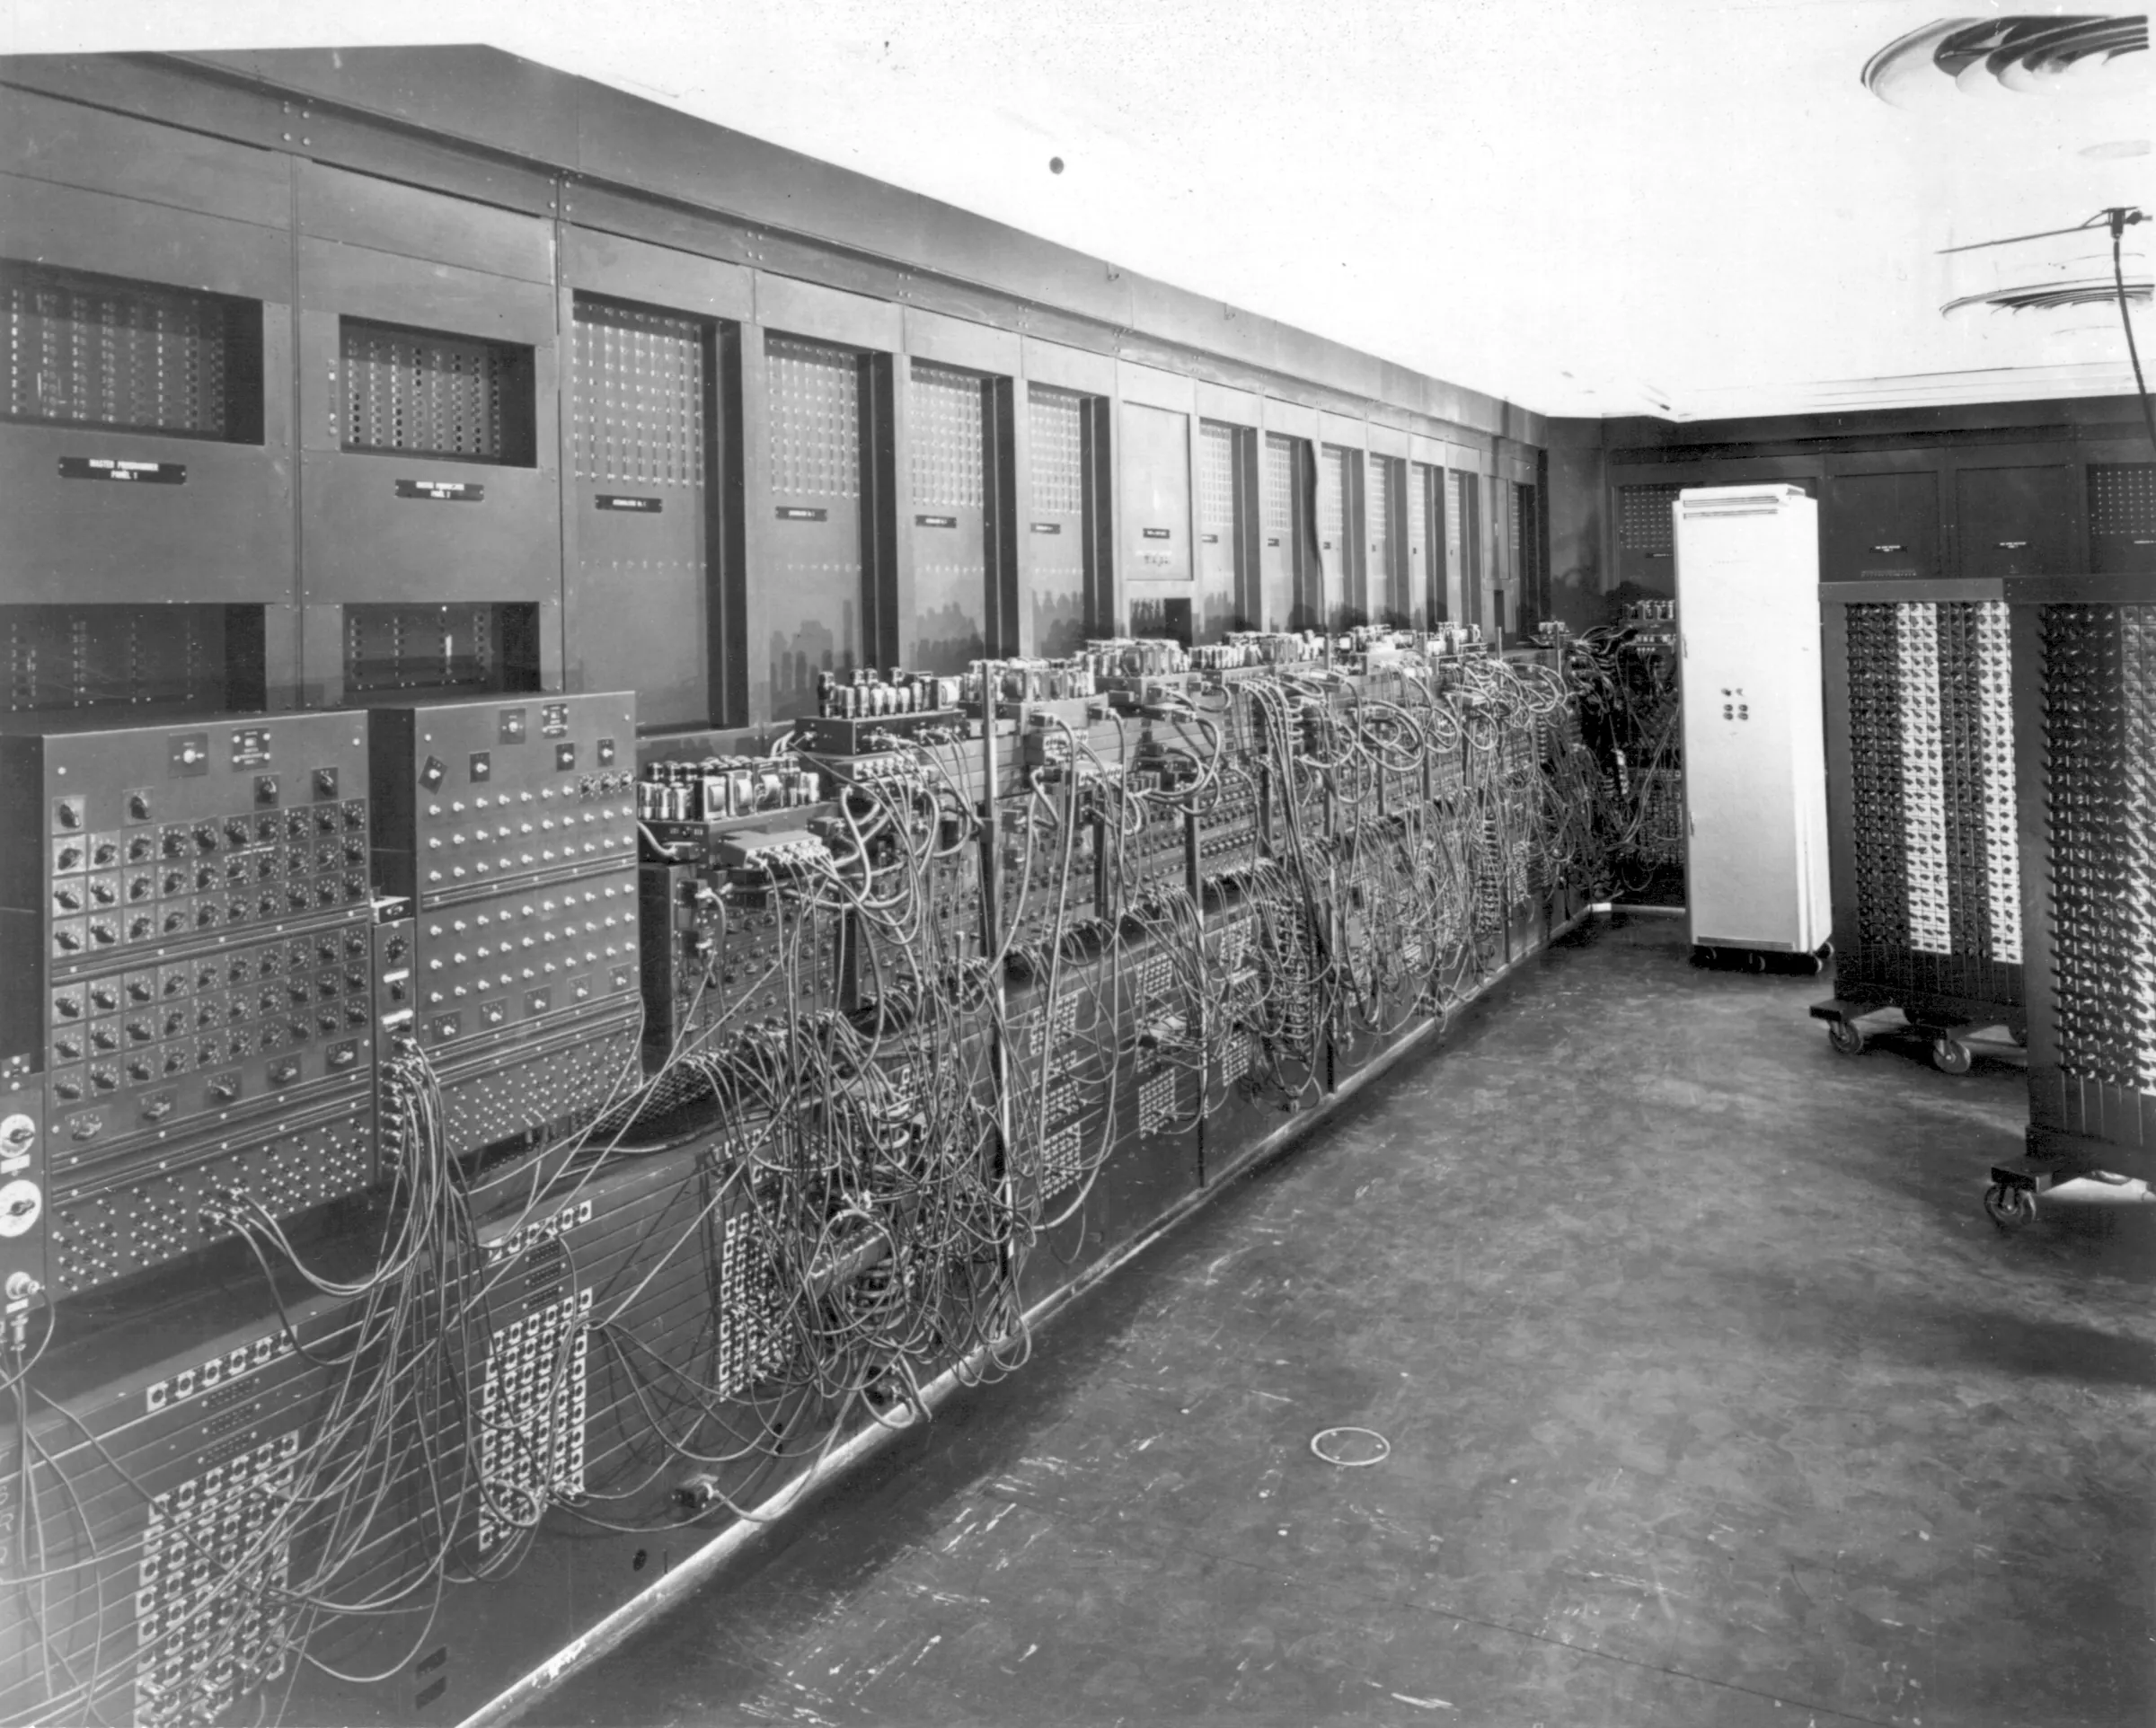
Sobre la imagen La ENIAC se programaba con cables y llaves, y nada verificaba que un cable significara lo que su autor quería. Los sistemas de tipos son el largo proyecto de hacer que la máquina lo verifique. La ENIAC tal como estaba instalada en el Ballistic Research Laboratory, Aberdeen, Maryland. Foto del Ejército de los EE. UU., dominio público.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Cada error de tipos que alguna vez te hizo renegar fue un bug atrapado antes de llegar a producción. Los sistemas de tipos rechazan disparates en tiempo de compilación para que no los descubras a las 3 de la mañana. Pero varían muchísimo en lo que pueden expresar y en las garantías que dan.
Si no aprendés otra cosa, aprendé esto: ADTs + pattern matching + generics. Estos tres conceptos van a mejorar tu código en cualquier lenguaje y se aprenden en días.
Los conceptos acá avanzan desde los generics (código reutilizable), pasando por los traits (comportamiento compartido), hasta los tipos lineales (seguridad de recursos) y los tipos dependientes (probar corrección). Cada paso te compra más garantías en tiempo de compilación a cambio de más trabajo para dejar contento al type checker.
#Estructura
Los conceptos están organizados en niveles:
| Nivel | Qué hay acá | Te conviene saberlo si… |
|---|---|---|
| 1: Fundamentos | Generics, ADTs, pattern matching | Escribís código |
| 2: Avanzado de uso común | Traits, GADTs, tipado sensible al flujo, existenciales | Diseñás bibliotecas |
| 3: Complejidad seria | HKT, tipos lineales/de ownership, efectos | Querés meterte a fondo en FP o en programación de sistemas |
| 4: Nivel de investigación | Tipos dependientes, session types | Trabajás en lenguajes de programación o verificación |
| 5: Frontera | HoTT, QTT, modalidades graduadas | Hacés investigación |
No hace falta leer en orden. Saltá a lo que te interese. Pero los conceptos se apoyan unos en otros: si los GADTs te confunden, asegurate primero de entender los ADTs.
#Nivel 1: Fundamentos
Todos los lenguajes modernos con tipado estático los soportan. Si usás un lenguaje tipado, ya los estás usando.
#Polimorfismo paramétrico (generics)
Escribís una función para obtener el primer elemento de una lista de enteros. Después la necesitás para strings. Después para tipos propios. Terminás con first_int, first_string, first_user, código duplicado que solo difiere en los tipos.
La alternativa, usar un tipo universal como Object o any, tira por la borda toda la seguridad de tipos. Volvés a rezar para no pasar la cosa equivocada.
Abstraé sobre el tipo mismo. Escribí la función una vez con un parámetro de tipo, y funciona para cualquier tipo. La propiedad crucial es la parametricidad (parametricity): la función tiene que comportarse igual sin importar qué tipo le enchufes. No puede inspeccionar el tipo ni comportarse distinto para enteros que para strings.
Esa restricción es exactamente lo que hace poderosos a los generics. Cuando una función es paramétrica en T, lo único que puede hacer es mover valores T de un lado a otro. No puede crear Ts nuevos de la nada, no puede compararlos, no puede imprimirlos. Esto significa que las funciones genéricas vienen con “teoremas gratis”: garantías sobre su comportamiento que se siguen puramente de su firma de tipos.
Por ejemplo, una función con firma fn mystery<T>(x: T) -> T solo puede devolver x. No hay ninguna otra cosa que pueda devolver. La firma de tipos por sí sola prueba la implementación. En lenguajes donde los valores se pueden copiar libremente (como Haskell), pair :: a -> (a, a) tiene que devolver (x, x). La restricción de parametricidad elimina cualquier otra posibilidad. (En Rust, la semántica de move agrega un matiz: fn pair<T>(x: T) -> (T, T) no compila sin T: Clone, porque x se puede usar una sola vez.)
Lo que esto te da:
- Escribís una vez, usás con cualquier tipo
- Nada de código duplicado
- El compilador verifica cada uso con tipos concretos
- Garantías de parametricidad: una función
fn id<T>(x: T) -> Tsolo puede devolverx
Te aviso: la sintaxis se pone fea. Tarde o temprano vas a escribir fn process<T: Read + Write + Clone + Send + 'static> y vas a cuestionar tus decisiones de vida. Es el precio de la expresividad. Igual es mejor que duplicar código.
// Rust: One function works for any type T
fn first<T>(slice: &[T]) -> Option<&T> {
    slice.first()
}

first(&[1, 2, 3]);              // Option<&i32>
first(&["a", "b"]);             // Option<&&str>
first(&[User::new("Ada")]);     // Option<&User>

// The implementation is identical for all types
// Parametricity: we can't inspect T, so we can only shuffle values around
// What can this function possibly do?
fn mystery<T>(x: T) -> T {
// We can't:
// - Print x (we don't know it implements Display)
// - Compare x (we don't know it implements Eq)
// - Clone x (we don't know it implements Clone)
// We can ONLY return x
x
}#Tipos de datos algebraicos
Estás modelando un usuario que puede ser anónimo o estar logueado. En un lenguaje OOP típico, podrías escribir:
class User {
    String name;       // null if anonymous
    boolean isLoggedIn;
}
Tony Hoare llama a las referencias nulas su “error de mil millones de dólares”, pero el problema va más allá de null. Este tipo permite cuatro estados: anónimo sin nombre, anónimo con nombre (!), logueado con nombre, logueado sin nombre (!). Dos de estos son un disparate, pero tu tipo los permite. Cada función tiene que chequear y manejar estados imposibles.
Los tipos deberían describir exactamente los estados válidos. Necesitamos dos herramientas:
- Tipos suma (sum types: enums, uniones etiquetadas): “esto O aquello”, un valor es una de varias variantes
- Tipos producto (product types: structs, records): “esto Y aquello”, un valor contiene todos los campos
Combinados, son los tipos de datos algebraicos (ADTs, por algebraic data types). Lo de “algebraico” viene de cómo calculás los valores posibles: los productos multiplican (un struct con 2 bools = 2 × 2 = 4 estados), las sumas suman (un enum con 3 variantes = 3 estados).
Mirá el álgebra en acción. Considerá:
booltiene 2 valores:true,false(bool, bool)tiene 2 × 2 = 4 valores:(true, true),(true, false),(false, true),(false, false)enum Either { Left(bool), Right(bool) }tiene 2 + 2 = 4 valores:Left(true),Left(false),Right(true),Right(false)
El poder está en combinarlos. Modelás tu dominio con exactamente los estados que tienen sentido. Si un usuario es anónimo (sin datos) o está logueado (con nombre y email), escribís eso directamente. El sistema de tipos después garantiza que no puedas acceder al nombre de un usuario anónimo, porque ese campo no existe en esa variante.
- Hacé que los estados ilegales sean irrepresentables: si tu tipo no puede contener datos inválidos, no podés tener bugs por datos inválidos
- Nada de chequeos de null para casos “imposibles”
- Modelos de dominio que se documentan solos
- Pattern matching exhaustivo (lo vemos a continuación)
// Rust: This type CANNOT represent an invalid state
enum User {
    Anonymous,
    LoggedIn { name: String, email: String },
}

// There is no way to construct:
// - "Logged in with no name" (LoggedIn requires name)
// - "Anonymous with a name" (Anonymous has no fields)

fn greet(user: &User) -> String {
    match user {
        User::Anonymous => "Hello, guest".to_string(),
        User::LoggedIn { name, .. } => format!("Hello, {}", name),
    }
}
// Model a payment result: each variant has exactly the data it needs
enum PaymentResult {
Success { transaction_id: String, amount: f64 },
Declined { reason: String },
NetworkError { retry_after_seconds: u32 },
}
// No nulls. No "reason" field that's only valid sometimes.
// Each variant is self-contained.// The classic: Option replaces null
enum Option<T> {
None,
Some(T),
}
// Result replaces exceptions
enum Result<T, E> {
Ok(T),
Err(E),
}
// These are ADTs! Sum types with generic parameters.Si venís de OOP, los ADTs te obligan a repensar cómo modelás datos. En lugar de jerarquías de clases con métodos, definís estructuras de datos y funciones que hacen pattern matching sobre ellas. Están disponibles en Rust, Haskell, OCaml, F#, Scala, Swift y Kotlin.
#Pattern matching
Dado un tipo de datos algebraico, necesitás ramificar según sus variantes y extraer datos. Con OOP usarías chequeos de instanceof o el patrón visitor, ambos verbosos y propensos a errores. Peor: cuando agregás una variante nueva, el compilador no te avisa de todos los lugares que hay que actualizar.
El pattern matching es la contraparte natural de los ADTs. Si los constructores arman tipos suma, el pattern matching los desarma. Son las dos caras de la misma moneda.
El compilador conoce todas las variantes posibles de tu tipo suma. Cuando escribís un match, verifica que las hayas cubierto todas. ¿Te olvidaste un caso? Error de compilación. ¿Agregaste una variante nueva a tu enum? Cada match de tu codebase que no la maneje pasa a ser un error de compilación. Esto es el chequeo de exhaustividad (exhaustiveness checking).
La comparación con if-else o switch es instructiva. En la mayoría de los lenguajes, switch no te avisa de los casos que faltan. El pattern matching sí. Y a diferencia del patrón visitor (la respuesta de OOP a este problema), el pattern matching es conciso y no requiere clases de boilerplate.
- Chequeo de exhaustividad: te olvidás un caso, tenés un error de compilación
- Refactors seguros: agregás una variante, el compilador te muestra todo lo que hay que actualizar
- Desestructuración incorporada: extraés campos mientras hacés el match
- Más limpio que cadenas de if-else o el patrón visitor
// Rust: Compiler ensures all cases handled
enum Message {
    Quit,
    Move { x: i32, y: i32 },
    Write(String),
    ChangeColor(u8, u8, u8),
}

fn process(msg: Message) -> String {
    match msg {
        Message::Quit => "Goodbye".to_string(),
        Message::Move { x, y } => format!("Moving to ({}, {})", x, y),
        Message::Write(text) => format!("Writing: {}", text),
        Message::ChangeColor(r, g, b) => format!("Color: #{:02x}{:02x}{:02x}", r, g, b),
    }
}

// If you forget a case:
// error[E0004]: non-exhaustive patterns: `Message::ChangeColor(_, _, _)` not covered
// Guards add conditions
fn describe(n: i32) -> &'static str {
match n {
0 => "zero",
n if n < 0 => "negative",
n if n % 2 == 0 => "positive even",
_ => "positive odd",
}
}
// Nested patterns
fn first_two<T: Clone>(items: &[T]) -> Option<(T, T)> {
match items {
[a, b, ..] => Some((a.clone(), b.clone())),
_ => None,
}
}El pattern matching ya está en C# 8+, Python 3.10+ y la mayoría de los lenguajes funcionales. Una vez que lo usás, no volvés atrás.
#Subtipado
Tenés una función que loguea cualquier respuesta HTTP. También definiste los tipos JsonResponse y XmlResponse con campos extra. Sin alguna forma de expresar “un JsonResponse es un HttpResponse”, necesitarías funciones de logueo separadas para cada uno, o resignar la seguridad de tipos.
Si el tipo B tiene todo lo que tiene el tipo A (y posiblemente más), podés usar un B en cualquier lugar donde se espera un A. Esto es subtipado (subtyping): JsonResponse <: HttpResponse significa que JsonResponse es un subtipo de HttpResponse.
Pensalo como un contrato. Un HttpResponse promete ciertas capacidades: tiene un código de estado y un body. Un JsonResponse cumple ese contrato y agrega más: también tiene un objeto parseado y un content type. En cualquier lugar donde el código espera “algo con status y body”, un JsonResponse funciona bien. Los campos extra se ignoran pero no causan problemas.
Este es el principio de sustitución de Liskov codificado en el sistema de tipos: si JsonResponse <: HttpResponse, entonces cualquier propiedad que valga para HttpResponse debería valer para JsonResponse.
#Nominal vs. estructural: dos filosofías
Esta es una clasificación fundamental de los sistemas de tipos, no solo un detalle del subtipado:
| Aspecto | Nominal | Estructural |
|---|---|---|
| Igualdad de tipos | Basada en el nombre declarado | Basada en la forma/estructura |
| Subtipado | Requiere declaración explícita | Implícito si la estructura coincide |
| Filosofía | “Cómo se llama” | “Qué puede hacer” |
| Abstracción | Fronteras fuertes | Composición flexible |
| Refactor | Renombrar rompe la compatibilidad | Cambiar la estructura rompe la compatibilidad |
El tipado nominal requiere declaraciones explícitas. Aunque dos tipos tengan campos idénticos, son tipos distintos salvo que estén relacionados por una declaración:
// Java: nominal typing
class Meters { double value; }
class Feet { double value; }

// These are DIFFERENT types despite identical structure
Meters m = new Meters();
Feet f = m;  // ERROR: incompatible types
Al tipado estructural solo le importa la forma. Si tiene los campos y métodos correctos, encaja:
// TypeScript: structural typing
interface Point { x: number; y: number; }

// Any object with x and y is a Point
const p: Point = { x: 1, y: 2 };           // OK
const q: Point = { x: 1, y: 2, z: 3 };     // OK (extra field allowed)

class Coordinate { x: number; y: number; }
const r: Point = new Coordinate();          // OK (same structure)
El enfoque de Go es interesante: nominal para los tipos definidos, pero las interfaces son estructurales. Un tipo implementa una interfaz si tiene los métodos correctos, sin necesidad de declararlo.
// Go: structural interfaces
type Reader interface {
    Read(p []byte) (n int, err error)
}

// MyFile implements Reader without declaring it
type MyFile struct { ... }
func (f MyFile) Read(p []byte) (int, error) { ... }

// Works: MyFile has the right method
func process(r Reader) { ... }
process(MyFile{})  // OK
// TypeScript: Structural subtyping
interface HttpResponse {
status: number;
body: string;
}
interface JsonResponse {
status: number;
body: string;
contentType: "application/json";
parsed: object;
}
function logResponse(res: HttpResponse): void {
console.log(`${res.status}: ${res.body}`);
}
const jsonRes: JsonResponse = {
status: 200,
body: '{"ok": true}',
contentType: "application/json",
parsed: { ok: true }
};
logResponse(jsonRes); // OK! JsonResponse has everything HttpResponse needsLa contra: el subtipado complica la inferencia de tipos e introduce preguntas de varianza. Si JsonResponse <: HttpResponse, ¿es List<JsonResponse> un subtipo de List<HttpResponse>? Depende de si la lista es de solo lectura (covariante), de solo escritura (contravariante) o mutable (invariante). Mirá Varianza para los detalles. Rust esquiva esto usando traits en lugar de subtipado para el polimorfismo.
#Nivel 2: Avanzado de uso común
Estas características aparecen en lenguajes modernos de producción, pero requieren más sofisticación para usarlas bien. Son esenciales para autores de bibliotecas y para escribir código muy genérico.
#Traits / typeclasses
Querés ordenar una lista. Ordenar requiere comparar. ¿Cómo sabe la función genérica de ordenamiento comparar tu tipo propio User?
Enfoques sin traits:
- Herencia:
User extends Comparable, pero ¿qué pasa si User viene de una biblioteca que no controlás? - Pasar un comparador cada vez: verboso, fácil de olvidar
- Duck typing: sin seguridad en tiempo de compilación, explota en runtime si falta el método
Separá la interfaz del tipo. Definí Ord (orden), Eq (igualdad), Display (impresión) como interfaces independientes llamadas traits (Rust) o typeclasses (Haskell). Después declarás que User las implementa. En algunos lenguajes podés hacer esto también para tipos externos; Rust es más restrictivo por las reglas de huérfanos (orphan rules).
Esto avanza bastante sobre el “expression problem”: ¿cómo agregás tanto tipos nuevos como operaciones nuevas sin modificar el código existente? Con herencia OOP, agregar tipos nuevos es fácil (una subclase nueva), pero agregar operaciones nuevas es difícil (hay que modificar cada clase). Con traits, podés agregar operaciones nuevas (un trait nuevo) e implementarlas para tipos existentes. En la práctica, las reglas de coherencia y las restricciones de huérfanos limitan hasta dónde llega esto, pero cubre muchos casos reales.
Cuando se usa con dispatch estático, la implementación se resuelve en tiempo de compilación. Cuando llamás a user.cmp(&other), el compilador sabe exactamente qué función de comparación usar porque conoce el tipo concreto. No hay búsqueda en la vtable. Esto se llama monomorfización (monomorphization): el compilador genera código especializado para cada tipo que usás. (Si en cambio usás trait objects o dispatch dinámico, pagás una búsqueda en la vtable en runtime, pero ganás flexibilidad.)
En Rust, la regla de “coherencia” evita el caos: puede haber como mucho una implementación de un trait para un tipo dado. No podés tener dos formas distintas de comparar Users. Esto significa que siempre podés predecir qué implementación se va a usar. Las typeclasses de Haskell tienen una expectativa similar pero la hacen cumplir de otra manera, y algunos lenguajes son más permisivos.
- Polimorfismo ad hoc: comportamiento distinto para tipos distintos, resuelto en tiempo de compilación
- Implementación retroactiva: agregás interfaces a tipos que no son tuyos
- Coherencia: como mucho una implementación por tipo (sin ambigüedad)
- Trait bounds: exigís capacidades, no herencia
// Rust: Define a trait
trait Summary {
    fn summarize(&self) -> String;
}

// Implement for your type
struct Article {
    title: String,
    author: String,
    content: String,
}

impl Summary for Article {
    fn summarize(&self) -> String {
        format!("{} by {}", self.title, self.author)
    }
}

// Implement for another local type
struct Number(i32);

impl Summary for Number {
    fn summarize(&self) -> String {
        format!("The number {}", self.0)
    }
}

// Use as a bound: T must implement Summary
fn notify<T: Summary>(item: &T) {
    println!("Breaking news! {}", item.summarize());
}

// Or with impl Trait syntax
fn notify_short(item: &impl Summary) {
    println!("Breaking news! {}", item.summarize());
}
// Standard library traits
use std::fmt::Display;
use std::cmp::Ord;
// Multiple bounds
fn print_sorted<T: Display + Ord>(mut items: Vec<T>) {
items.sort();
for item in items {
println!("{}", item);
}
}
// Default implementations
trait Greet {
fn name(&self) -> &str;
fn greet(&self) -> String {
format!("Hello, {}!", self.name()) // default impl
}
}Las reglas de huérfanos de Rust restringen dónde podés implementar traits para evitar implementaciones en conflicto. A veces es frustrante, pero mantiene la coherencia.
#Tipos asociados
Estás definiendo un trait Iterator. Cada iterador produce ítems de algún tipo. Con generics comunes, escribirías Iterator<Item>. Pero esto hace que Iterator<i32> e Iterator<String> sean traits distintos, y un tipo podría implementar los dos, generando ambigüedad sobre cuál aplica.
Lo que querés: que el tipo del ítem esté determinado por el tipo que implementa, no elegido por el usuario.
Algunos parámetros de tipo son salidas (determinados por la implementación), no entradas (elegidos por quien llama). Los tipos asociados (associated types) expresan esto: “cuando implementes este trait, tenés que especificar qué es Item”.
La distinción importa. Con un parámetro de tipo común como Iterator<T>, estás diciendo “este es un iterador que podría funcionar con cualquier T”. Pero los iteradores no funcionan así. Un VecIterator siempre produce el tipo que contiene el Vec. El tipo lo determina el iterador, no lo elige el usuario.
Pensalo como una función a nivel de tipos. Dado un tipo que implementa Iterator, podés preguntar “¿qué produce?” y obtener el tipo asociado Item. El iterador de Vec<i32> tiene Item = i32. El .iter() de HashMap<K, V> produce Item = (&K, &V). El tipo que implementa determina el tipo asociado.
- APIs más limpias: un trait, no una familia de traits
- Funciones a nivel de tipos: el tipo que implementa determina el tipo asociado
- Mejores mensajes de error: “Item not found” en lugar de “Iterator not satisfied”
// Rust: The standard Iterator trait
trait Iterator {
    type Item;  // Associated type: implementor decides

    fn next(&mut self) -> Option<Self::Item>;
}

// Implementing: specify what Item is
struct Counter {
    count: u32,
    max: u32,
}

impl Iterator for Counter {
    type Item = u32;  // Counter produces u32s

    fn next(&mut self) -> Option<u32> {
        if self.count < self.max {
            self.count += 1;
            Some(self.count)
        } else {
            None
        }
    }
}

// Using: the Item type is known from the iterator type
fn sum_all<I: Iterator<Item = i32>>(iter: I) -> i32 {
    iter.fold(0, |acc, x| acc + x)
}
// Without associated types (what you'd have to write)
trait BadIterator<Item> {
fn next(&mut self) -> Option<Item>;
}
// Problem: impl BadIterator<i32> and impl BadIterator<String>
// are different traits! A type could implement both!Los tipos asociados son menos flexibles que los parámetros de tipo cuando necesitás que el mismo tipo implemente un trait de varias maneras. Pero para la mayoría de los casos, hacen las APIs más limpias.
#Tipado sensible al flujo
Chequeás si un valor es null antes de usarlo. Vos sabés que no es null adentro del bloque if. Pero ¿lo sabe el sistema de tipos?
// Java: limited type narrowing
Object x = maybeNull();
if (x != null) {
    // Java lets you call x.toString() here without complaint.
    // But the type is still Object. The compiler doesn't narrow it
    // to a more specific non-null type you can branch on further.
    // Compare this to TypeScript, where the type actually changes.
    x.toString();
}
El tipado sensible al flujo (flow-sensitive typing, también llamado occurrence typing o type narrowing) refina los tipos según el flujo de control. Después de un chequeo de tipo, el sistema de tipos estrecha el tipo de la variable en las ramas donde el chequeo dio verdadero.
La información de tipos cambia a medida que avanzás por el código. El tipo de x no queda fijo en su declaración. Evoluciona según lo que el programa fue aprendiendo. Después de if (x !== null), el tipo de x en la rama then es más estrecho que al principio.
Esto tiende un puente entre las filosofías del tipado estático y el dinámico. Los lenguajes dinámicos siempre conocen el tipo en runtime. Los lenguajes estáticos tradicionalmente fijan los tipos en la declaración. El tipado sensible al flujo permite que los tipos estáticos se beneficien de los chequeos en runtime sin perder las garantías estáticas.
// TypeScript: flow-sensitive typing
function process(value: string | number | null) {
    // Here: value is string | number | null

    if (value === null) {
        return;  // value is null in this branch
    }
    // Here: value is string | number (null eliminated)

    if (typeof value === "string") {
        // Here: value is string
        console.log(value.toUpperCase());  // OK: string method
    } else {
        // Here: value is number
        console.log(value.toFixed(2));     // OK: number method
    }
}

// Works with user-defined type guards too
interface Success { data: object; }
interface Failure { error: string; code: number; }

function isSuccess(result: Success | Failure): result is Success {
    return (result as Success).data !== undefined;
}

function handle(result: Success | Failure) {
    if (isSuccess(result)) {
        console.log(result.data);   // TypeScript knows result is Success
    } else {
        console.error(result.error); // TypeScript knows result is Failure
    }
}
// Kotlin: smart casts
fun process(x: Any) {
if (x is String) {
// x is automatically cast to String here
println(x.length) // No explicit cast needed
}
// Works with null checks too
val name: String? = getName()
if (name != null) {
// name is String here, not String?
println(name.length)
}
}- Elimina casts redundantes: el compilador registra lo que ya chequeaste
- Detecta ramas imposibles: si una rama nunca se puede ejecutar, el compilador avisa
- Manejo natural de null: los chequeos de null estrechan los tipos automáticamente
- Type guards: funciones definidas por el usuario pueden estrechar tipos
El tipado sensible al flujo complica el sistema de tipos. El tipo de una variable depende de dónde estás en el código, no solo de su declaración. Esto hace más complejo el chequeo de tipos y puede llevar a comportamientos sorprendentes cuando las variables se reasignan o se capturan en closures.
Disponible en TypeScript, Kotlin, Ceylon, Flow (JavaScript), Rust (con pattern matching), Swift y, cada vez más, en otros lenguajes modernos.
#Tipos intersección y unión
Tenés un valor que podría ser de uno entre varios tipos. O un valor que tiene que satisfacer varias interfaces al mismo tiempo. Los generics y el subtipado comunes no expresan estas relaciones de forma limpia.
// How do you type a function that accepts string OR number?
// How do you require an object to be BOTH Serializable AND Comparable?
Los tipos unión (A | B) representan “esto O aquello”. Un valor de tipo A | B es un A o un B. Tenés que manejar las dos posibilidades antes de usar operaciones específicas de cada tipo.
Los tipos intersección (A & B) representan “esto Y aquello”. Un valor de tipo A & B tiene todas las propiedades de A y de B. Satisface las dos interfaces al mismo tiempo.
Se corresponden con el O lógico (unión) y el Y lógico (intersección).
// TypeScript: Union types
type StringOrNumber = string | number;

function process(value: StringOrNumber) {
    // Must narrow before using type-specific operations
    if (typeof value === "string") {
        console.log(value.toUpperCase());  // OK: string method
    } else {
        console.log(value.toFixed(2));     // OK: number method
    }
}

// Discriminated unions: tagged sum types
type Result<T, E> =
    | { kind: "ok"; value: T }
    | { kind: "error"; error: E };

function handle<T, E>(result: Result<T, E>) {
    switch (result.kind) {
        case "ok": return result.value;      // TypeScript knows value exists
        case "error": throw result.error;    // TypeScript knows error exists
    }
}
// TypeScript: Intersection types
interface Named { name: string; }
interface Aged { age: number; }
type Person = Named & Aged; // Must have both name AND age
const person: Person = {
name: "Ada",
age: 36
};
// Intersection for mixin-style composition
interface Loggable { log(): void; }
interface Serializable { serialize(): string; }
type LoggableAndSerializable = Loggable & Serializable;
function process(obj: LoggableAndSerializable) {
obj.log(); // OK: has Loggable
obj.serialize(); // OK: has Serializable
}// Scala 3: Union and intersection types
def process(value: String | Int): String = value match
case s: String => s.toUpperCase
case i: Int => i.toString
// Intersection: must satisfy both traits
trait Runnable { def run(): Unit }
trait Stoppable { def stop(): Unit }
def manage(service: Runnable & Stoppable): Unit =
service.run()
service.stop()- Tipado preciso para datos heterogéneos: JSON, configs, APIs con respuestas variantes
- Composición de mixins: combinás interfaces sin jerarquías de herencia
- Uniones discriminadas: pattern matching con seguridad de tipos sobre variantes etiquetadas
- Relaciones de subtipado:
Aes subtipo deA | B;A & Bes subtipo deA
#Tipos intersección en la teoría de tipos
En la teoría de tipos formal, los tipos intersección tienen un significado más profundo. La disciplina de tipos intersección (intersection type discipline) puede tipar más programas que los tipos simples: algunos programas que no se pueden tipar en System F pasan a ser tipables con intersecciones. Esto es porque las intersecciones permiten darle a un término varios tipos al mismo tiempo.
// The identity function can have type:
λx.x : Int → Int           // for integers
λx.x : String → String     // for strings
λx.x : (Int → Int) ∧ (String → String)  // BOTH at once with intersection
Esto habilita tipados principales (principal typings) para algunos sistemas y se usa en análisis de programas y evaluación parcial.
TypeScript (de forma extensa), Scala 3, Flow, Ceylon, Pike, CDuce y lenguajes de investigación. Java tiene tipos intersección limitados en los generics (<T extends A & B>). Haskell logra efectos similares mediante typeclasses.
#Tipos de datos algebraicos generalizados (GADTs)
Estás construyendo un lenguaje de expresiones con seguridad de tipos. Tenés Add(expr, expr) y Equal(expr, expr). Add debería devolver un entero; Equal debería devolver un booleano. Pero con ADTs comunes, el tipo Expr no tiene forma de registrar qué tipo de valor produce cada expresión.
Tu función eval o bien:
- Devuelve
Objecty requiere downcasting (inseguro) - Devuelve un tipo suma como
Value::Int | Value::Booly requiere chequeos (verboso)
Dejá que cada constructor especifique su propio tipo de retorno, más preciso. Add construye un Expr<Int>; Equal construye un Expr<Bool>. El parámetro de tipo registra a qué evalúa la expresión.
Con ADTs comunes, todos los constructores devuelven el mismo tipo. Some(x) y None devuelven los dos Option<T> para el mismo T. Pero con GADTs, constructores distintos pueden devolver instanciaciones de tipo distintas. LitInt(5) devuelve Expr<Int>. LitBool(true) devuelve Expr<Bool>. Lo de “generalizados” se refiere a esta flexibilidad.
El pattern matching muestra la ganancia. Si hacés match sobre un Expr<Int> y ves un LitInt, el compilador sabe que el parámetro de tipo es Int. Puede usar ese conocimiento para chequear los tipos de la rama correctamente. Podés devolver un Int directamente, no un tipo envuelto. Este flujo de información desde los patrones hacia el chequeo de tipos es lo que hace posibles los evaluadores con seguridad de tipos.
El costo: la inferencia de tipos se rompe. El compilador no siempre puede deducir qué tipo debería tener una expresión, porque depende de qué constructor se usó. Necesitás anotaciones de tipo explícitas en los lugares donde hacés match sobre GADTs.
- Intérpretes y DSLs con seguridad de tipos: el tipo registra el tipo del resultado de la expresión
- Elimina patrones imposibles: si hacés match sobre
Expr<Int>, sabés que no esLitBool - Tipos más precisos: la información fluye desde los patrones hacia el type checker
Rust no soporta GADTs directamente. Scala 3 tiene una sintaxis limpia:
// Scala 3: GADT syntax
enum Expr[A]:
  case LitInt(value: Int) extends Expr[Int]
  case LitBool(value: Boolean) extends Expr[Boolean]
  case Add(left: Expr[Int], right: Expr[Int]) extends Expr[Int]
  case Equal(left: Expr[Int], right: Expr[Int]) extends Expr[Boolean]
  case If[T](cond: Expr[Boolean], thenBr: Expr[T], elseBr: Expr[T]) extends Expr[T]

// Type-safe eval: return type matches expression type
def eval[A](expr: Expr[A]): A = expr match
  case Expr.LitInt(n) => n           // here A = Int, return Int ✓
  case Expr.LitBool(b) => b          // here A = Boolean, return Boolean ✓
  case Expr.Add(l, r) => eval(l) + eval(r)
  case Expr.Equal(l, r) => eval(l) == eval(r)
  case Expr.If(c, t, e) => if eval(c) then eval(t) else eval(e)

// This WON'T compile:
// Expr.Add(Expr.LitBool(true), Expr.LitInt(1))
// Error: expected Expr[Int], got Expr[Boolean]

// Usage
val expr: Expr[Int] = Expr.Add(Expr.LitInt(1), Expr.LitInt(2))
val result: Int = eval(expr)  // Type-safe: result is Int, not Object
Los GADTs están disponibles en Haskell, OCaml y Scala 3. TypeScript tiene un soporte limitado mediante type guards.
#Tipos existenciales
Querés una colección de cosas que comparten un trait, pero son de tipos concretos distintos: un Vec<???> que contenga enteros, strings y structs propios. Pero Vec<T> requiere un T específico.
Escondé el tipo concreto detrás de una interfaz. Un tipo existencial dice: “existe algún tipo T que implementa este trait, pero no te voy a decir cuál”. Solo podés usar operaciones del trait, nada específico del tipo.
La dualidad con los generics:
- Generics (universales): quien llama elige el tipo, “para todo tipo T, esto funciona”
- Existenciales: quien es llamado elige el tipo, “existe algún tipo T, pero no sabés cuál”
¿Por qué sirve esto? Pensá en un sistema de plugins. Cada plugin es de un tipo distinto, pero todos implementan Plugin. Querés un Vec<Plugin> que contenga todos tus plugins. Solo con generics, necesitarías Vec<SomeSpecificPlugin>. Con existenciales, obtenés Vec<Box<dyn Plugin>>: una colección de “cosas que son de algún tipo que implementa Plugin”. Los tipos concretos quedan ocultos (cuantificados existencialmente), pero igual podés llamar a los métodos de Plugin sobre ellos.
- Colecciones heterogéneas: mezclás tipos distintos con interfaces compartidas
- Ocultamiento de información: quien llama no puede depender del tipo concreto
- Dispatch dinámico: la implementación se elige en runtime
// Rust: dyn Trait is an existential type
use std::fmt::Display;

fn make_displayables() -> Vec<Box<dyn Display>> {
    vec![
        Box::new(42),
        Box::new("hello"),
        Box::new(3.14),
    ]
}

fn print_all(items: Vec<Box<dyn Display>>) {
    for item in items {
        println!("{}", item);  // Can only call Display methods
    }
}

// You don't know the concrete types, but you can display them all
// impl Trait in return position is also existential
fn make_iterator() -> impl Iterator<Item = i32> {
// Caller doesn't know this is specifically a Range
// They only know it's "some iterator of i32"
0..10
}
// Useful for hiding complex iterator adapter chains
fn complex_iter() -> impl Iterator<Item = i32> {
(0..100)
.filter(|x| x % 2 == 0)
.map(|x| x * x)
.take(10)
}El costo: dyn Trait tiene overhead en runtime (búsqueda en la vtable) y no podés recuperar el tipo concreto. Usá generics cuando conocés el tipo estáticamente.
#Polimorfismo de rango N
Normalmente, quien llama a una función genérica elige el parámetro de tipo. Pero a veces querés que elija quien es llamado. Pensá en una función que aplica una transformación a los dos elementos de un par, pero los elementos son de tipos distintos.
// This doesn't work in Rust
fn apply_to_both<T>(f: impl Fn(T) -> T, pair: (i32, String)) -> (i32, String) {
    (f(pair.0), f(pair.1))  // Error! T can't be both i32 and String
}
En el polimorfismo de rango 1 (los generics normales), el forall está afuera: quien llama elige un único T para toda la función. En rango 2 o más, el forall aparece adentro de los tipos de los argumentos: “el argumento tiene que ser una función que funcione para cualquier tipo”.
El “rango” se refiere a qué tan profundo se puede anidar el forall:
- Rango 0: sin polimorfismo. $int \to int$.
- Rango 1: $\forall$ arriba de todo. $\forall T.; T \to T$. Quien llama elige $T$.
- Rango 2: $\forall$ en posición de argumento. $(\forall T.; T \to T) \to int$. El argumento tiene que ser polimórfico.
- Rango N: anidamiento arbitrario.
¿Para qué querrías esto? Pensá en el truco de la mónada ST en Haskell. runST tiene tipo $(\forall s.; ST; s; a) \to a$. La variable de tipo $s$ está cuantificada universalmente adentro del argumento. Esto significa que runST elige $s$, no quien llama. Como $s$ la elige runST y sale de alcance enseguida, ninguna referencia etiquetada con $s$ puede escaparse. Así es como Haskell provee mutación in situ segura: el sistema de tipos garantiza que las referencias mutables no se pueden filtrar fuera de runST.
El costo es severo: la inferencia de tipos se vuelve indecidible a partir de rango 3 (la inferencia de rango 2 es decidible pero ya es poco práctica para la mayoría de los casos). Tenés que anotar todo. La mayoría de los lenguajes evitan esta complejidad.
- Tipos más precisos: “tiene que funcionar para todos los tipos” es un requisito fuerte
- Encapsulamiento: la mónada ST usa tipos de rango 2 para asegurar que las referencias no se escapen
- Habilita patrones imposibles con rango 1
Rust no puede expresar tipos de rango N completos directamente, aunque los higher-ranked trait bounds (for<'a>) te dan una forma limitada de rango 2 sobre lifetimes. OCaml puede ir más lejos:
let id : 'a -> 'a = fun x -> x
type poly_fn = { f : 'a. 'a -> 'a }
let apply_to_both (p : poly_fn) (x, y) = (p.f x, p.f y)
let result = apply_to_both { f = id } (42, "hello")
-- Haskell: cleaner Rank-2 syntax with RankNTypes extension
{-# LANGUAGE RankNTypes #-}

-- runST : (forall s. ST s a) -> a

-- The 's' type variable is chosen by runST, not the caller.
-- This makes it impossible to return an STRef outside runST,
-- because the 's' won't match anything outside.
Los tipos de rango N son raros fuera de Haskell. La mayoría de los lenguajes no los soportan, y en general podés arreglártelas sin ellos.
#Nivel 3: Complejidad seria
Estas características requieren una inversión de aprendizaje importante, pero te permiten escribir abstracciones imposibles en sistemas de tipos más simples. Son comunes en los lenguajes de programación funcional y aparecen cada vez más en lenguajes de uso masivo.
#Higher-kinded types (HKT)
Vec, Option, Result: son todos “contenedores” sobre los que podés mapear una función. Escribís map para Vec. Después para Option. Después para Result. Las implementaciones se ven estructuralmente idénticas:
fn map_vec<A, B>(items: Vec<A>, f: impl Fn(A) -> B) -> Vec<B>
fn map_option<A, B>(item: Option<A>, f: impl Fn(A) -> B) -> Option<B>
fn map_result<A, B, E>(item: Result<A, E>, f: impl Fn(A) -> B) -> Result<B, E>
¿No podemos abstraer sobre el contenedor en sí?
Los tipos tienen kinds, así como los valores tienen tipos:
Int         : Type                    -- a plain type
Vec         : Type -> Type            -- takes a type, returns a type
Result      : Type -> Type -> Type    -- takes two types, returns a type
Int es un tipo completo. Pero Vec por sí solo no es un tipo. No podés tener una variable de tipo Vec. Necesitás Vec<i32> o Vec<String>. Vec es un constructor de tipos: le das un tipo y te devuelve un tipo.
Los HKT te permiten abstraer sobre constructores de tipos como Vec y Option, en lugar de solo sobre tipos como Int. Podés definir Functor como un trait para cualquier constructor de tipos, y después implementarlo una vez para cada contenedor.
Los patrones Functor, Applicative y Monad de la programación funcional requieren todos HKT. Describen propiedades de contenedores, no de tipos específicos. “Functor” significa “podés mapear sobre este contenedor”. Eso aplica a Vec, Option, Result, Future, IO e infinitos otros constructores de tipos. Sin HKT, escribirías map_vec, map_option, map_result por separado. Con HKT, escribís un solo map que funciona para cualquier Functor.
- Functor, Monad, Applicative: patrones abstractos sobre cualquier contenedor
- Escribís el código una vez: funciona para
Option,Result,Vec,Future,IO, … - La base de las abstracciones de la programación funcional
La inferencia de tipos se vuelve bastante más difícil. Combinada con características como el polimorfismo impredicativo, puede volverse indecidible. Los lenguajes con HKT suelen requerir anotaciones explícitas. Rust evita deliberadamente los HKT completos (y usa GATs como alternativa para algunos casos).
Rust no tiene HKT. Scala 3 sí:
// Scala 3: F[_] is a type constructor (kind: Type -> Type)
trait Functor[F[_]]:
  def map[A, B](fa: F[A])(f: A => B): F[B]

// Implement for List
given Functor[List] with
  def map[A, B](fa: List[A])(f: A => B): List[B] = fa.map(f)

// Implement for Option
given Functor[Option] with
  def map[A, B](fa: Option[A])(f: A => B): Option[B] = fa.map(f)

// Now we can write generic code over ANY functor
def double[F[_]: Functor](fa: F[Int]): F[Int] =
  summon[Functor[F]].map(fa)(_ * 2)

double(List(1, 2, 3))              // List(2, 4, 6)
double(Option(5))                  // Some(10)
double(Option.empty[Int])          // None

// Monad builds on Functor
trait Monad[M[_]] extends Functor[M]:
  def pure[A](a: A): M[A]
  def flatMap[A, B](ma: M[A])(f: A => M[B]): M[B]

  // map can be derived from flatMap
  def map[A, B](fa: M[A])(f: A => B): M[B] =
    flatMap(fa)(a => pure(f(a)))
Los HKT son estándar en Haskell, Scala y PureScript. Rust evita los HKT completos pero agregó GATs (Generic Associated Types) como alternativa parcial. Si tu lenguaje no soporta HKT, no te pelees con eso. Tres funciones parecidas están bien si son cortas.
#Tipos lineales y afines
Los recursos hay que administrarlos: archivos cerrados, memoria liberada, locks liberados. ¿Te olvidás de cerrar un archivo? Leak. ¿Lo cerrás dos veces? Crash. ¿Lo usás después de cerrarlo? Comportamiento indefinido.
Yo no entendí por qué importaban los tipos afines hasta que pasé tres días debuggeando un double-free en un codebase de C++. El ownership era “obvio” para quien lo había escrito seis meses antes. Rust habría rechazado el código al instante.
Los garbage collectors manejan la memoria pero no los archivos, los sockets ni los locks. La gestión manual es propensa a errores. Microsoft reporta que el 70% de sus vulnerabilidades de seguridad son problemas de seguridad de memoria, y el use-after-free sigue siendo uno de los principales vectores de explotación. ¿Puede el sistema de tipos registrar el uso de los recursos?
La mayoría de los sistemas de tipos solo registran qué es un valor. Los tipos lineales también registran cuántas veces se usa. Esta es la familia subestructural (substructural), que se llama así porque restringe las reglas estructurales de la lógica (debilitamiento, contracción, intercambio):
| Tipo | Regla | Regla estructural restringida | Caso de uso |
|---|---|---|---|
| Irrestricto | Cualquier cantidad de veces | Ninguna | Valores normales |
| Afín | Como mucho una vez | Contracción (sin duplicación) | Ownership de Rust, se puede descartar sin usar |
| Lineal | Exactamente una vez | Contracción + debilitamiento | Hay que manejarlo, no te lo podés olvidar |
| Relevante | Al menos una vez | Debilitamiento (sin descarte) | Hay que usarlo, se puede duplicar |
| Ordenado | Exactamente una vez, en orden | Contracción + debilitamiento + intercambio | Disciplinas de pila |
Los tipos ordenados son los más restrictivos: los valores se tienen que usar exactamente una vez y en orden LIFO. Modelan recursos basados en pilas donde no podés reordenar operaciones.
Rust usa tipos afines: los valores se usan como mucho una vez (se mueven), pero podés descartarlos sin usarlos. Los tipos lineales de verdad requieren usar los valores exactamente una vez. No te podés olvidar de manejar algo.
“Usar” incluye transferir el ownership. Cuando pasás un String a una función que lo recibe por valor, “usaste” el String. Ya no está en tu scope. No lo podés volver a usar. El borrow checker registra el ownership e impide el uso después de un move.
El borrowing (préstamo: &T y &mut T) es la forma en que Rust se escapa de la restricción de “usar una vez” cuando hace falta. Un préstamo no consume el valor; presta el acceso temporalmente. El dueño original conserva el ownership y puede usar el valor cuando termina el préstamo. El borrow checker garantiza que los préstamos no vivan más que el dueño.
- Seguridad de memoria sin GC: sin overhead en runtime, sin pausas
- Seguridad de recursos: no te podés olvidar de cerrar archivos
- Previene use-after-free: el sistema de tipos lo rechaza
- Sin data races: el ownership impide el estado mutable compartido
// Rust: Affine types (values used at most once)
fn consume(s: String) {
    println!("{}", s);
}   // s dropped here

fn main() {
    let s = String::from("hello");
    consume(s);        // s moved into consume
    // println!("{}", s);  // ERROR: borrow of moved value: `s`
}

// File handles: RAII through ownership
use std::fs::File;
use std::io::Read;

fn read_file() -> std::io::Result<String> {
    let mut file = File::open("data.txt")?;
    let mut contents = String::new();
    file.read_to_string(&mut contents)?;
    Ok(contents)
}   // file automatically closed here (Drop trait)

// Can't use file after it's moved/dropped
// Can't forget to close (happens automatically)
// Can't close twice (Drop runs exactly once)
// Borrowing: temporarily use without consuming
fn print_length(s: &String) { // borrows s
println!("Length: {}", s.len());
} // borrow ends, s still valid
fn main() {
let s = String::from("hello");
print_length(&s); // lend s
print_length(&s); // can lend again
println!("{}", s); // s still valid
}
// Mutable borrows: exclusive access
fn append_world(s: &mut String) {
s.push_str(" world");
}
fn main() {
let mut s = String::from("hello");
append_world(&mut s);
// Only ONE mutable borrow at a time (prevents data races)
}El borrow checker requiere práctica. Algunos patrones (grafos, listas doblemente enlazadas) se pelean con él. Pero una vez que internalizás la forma de pensar en ownership, la mayor parte del código simplemente funciona.
#La familia más amplia: ownership, regiones y capacidades
Los tipos lineales/afines son parte de una familia más amplia de sistemas de tipos que registran recursos:
| Sistema | Qué registra | Ejemplo |
|---|---|---|
| Lineal/afín | Cantidad de usos (exactamente/como mucho una vez) | Semántica de move |
| Ownership | Quién es dueño de un valor | El modelo de ownership de Rust |
| Región/lifetime | Cuánto tiempo es válida una referencia | Lifetimes de Rust ('a) |
| Capacidad | Qué permisos otorga un valor | Lenguajes de object-capability |
Los tipos de ownership hacen explícito al dueño en el tipo. Rust combina ownership con tipos afines: el dueño es responsable de la limpieza, y el ownership se puede transferir exactamente una vez. Esto es más que registrar el uso; es registrar la responsabilidad.
Los tipos de región (o tipos de lifetime) registran el alcance en el que una referencia es válida. Las anotaciones de lifetime de Rust (&'a T) son tipos de región: prueban que las referencias no viven más que los datos a los que apuntan.
// Rust: lifetimes are region types
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
    if x.len() > y.len() { x } else { y }
}

// The 'a says: the returned reference is valid as long as
// BOTH input references are valid. The compiler checks this.
Los tipos de capacidad (capability types) codifican permisos, no solo estructura. Un ReadCapability<File> te deja leer, mientras que un WriteCapability<File> te deja escribir. El sistema de tipos garantiza que solo puedas hacer las operaciones para las que tenés capacidades. Es la seguridad de object-capability expresada en tipos.
Estas ideas nacieron en la investigación (inferencia de regiones en MLKit, el cálculo de capacidades, el C seguro de Cyclone) pero llegaron al uso masivo a través de Rust. Lenguajes como Vale y Austral exploran distintos puntos de este espacio de diseño.
#Sistemas de efectos
¿Esta función hace I/O? ¿Tira excepciones? ¿Modifica estado global? En la mayoría de los lenguajes, no lo podés saber por la firma. Una función que parece pura podría leer de la red, romper tu programa o modificar una variable global.
// What does this do? You have to read the implementation.
String process(String input)
Registrá en el tipo qué efectos puede realizar una función. Las funciones puras no tienen efectos. readFile tiene un efecto IO. throw tiene un efecto Exception. Una función String -> Int sin efectos solo puede computar sobre su entrada. Una función String -> IO Int podría leer archivos, ir a la red o lanzar misiles.
Los efectos se propagan: si llamás a readFile adentro de tu función, tu función ahora también tiene IO. El compilador lo registra automáticamente.
Algunos sistemas también proveen effect handlers (manejadores de efectos): interceptan un efecto y proveen un comportamiento a medida. En lugar de hacer I/O, podrías loguear qué I/O se haría. En lugar de tirar una excepción, podrías juntar los errores. Es como la inyección de dependencias, pero para efectos. Escribís código usando efectos abstractos, y después los “manejás” de forma distinta en los tests y en producción.
- Efectos visibles en las firmas: ves de un vistazo qué puede hacer una función
- La pureza se puede probar: las funciones sin efectos son puras garantizado
- Polimorfismo de efectos: genérico sobre qué efectos se usan
- Effect handlers: flujo de control programable, efectos algebraicos
// Koka: Effects are part of the type

// Pure function: no effects
fun pureAdd(x: int, y: int): int
  x + y

// Function with IO and exception effects
fun readConfig(path: string): <io, exn> string
  val contents = read-text-file(path)   // io effect
  if contents.is-empty then
    throw("Config file is empty")        // exn effect
  contents

// Effect polymorphism: map preserves whatever effects f has
fun map(xs: list<a>, f: (a) -> e b): e list<b>
  match xs
    Nil -> Nil
    Cons(x, rest) -> Cons(f(x), map(rest, f))

// If f is pure, map is pure
// If f has io effect, map has io effect
// Effect handlers: provide custom interpretations of effects
effect ask<a>
ctl ask(): a
fun program(): ask<int> int
val x = ask()
val y = ask()
x + y
// Handle by providing values
fun main(): io ()
// Handle 'ask' by returning 10 each time
with handler
ctl ask() resume(10)
val result = program() // 20
println(result.show)Los sistemas de efectos están en Koka, Eff, Frank y Unison. Haskell usa mónadas como alternativa. La mayoría de los lenguajes de uso masivo no los tienen, así que podés usar disciplina en su lugar: funciones puras en el núcleo, efectos en los bordes.
#Tipos refinados
Tu función divide dos números. El divisor no puede ser cero. Agregás un chequeo en runtime:
fn divide(x: i32, y: i32) -> i32 {
    if y == 0 { panic!("division by zero"); }
    x / y
}
Pero quien llama podría saber que y no es cero porque viene del largo de una lista no vacía. Estás chequeando sin necesidad. ¿Y si te olvidás del chequeo en algún lado?
Asociá predicados lógicos a los tipos. En lugar de Int, escribí ${x : Int \mid x > 0}$. Un tipo refinado (refinement type) es un tipo base más un predicado que los valores tienen que cumplir.
Este es un punto justo entre los tipos comunes y los tipos dependientes completos. Los tipos comunes distinguen “entero” de “string”, pero no pueden distinguir “entero positivo” de “entero negativo”. Los tipos dependientes pueden expresar casi cualquier cosa, pero requieren pruebas. Los tipos refinados te dejan expresar propiedades comunes (no nulo, positivo, dentro de los límites) y usar solvers automáticos para verificarlas.
El compilador usa un SMT solver (Satisfiability Modulo Theories) para verificar los predicados en tiempo de compilación. Los SMT solvers son demostradores automáticos de teoremas que pueden manejar aritmética, vectores de bits, arrays y más. Cuando escribís divide(x, y) donde y tiene que ser positivo, el solver chequea si y > 0 se puede probar a partir del contexto. Si y vino del largo de una lista, y las listas no son vacías, el solver lo puede probar automáticamente.
La división por cero pasa a ser un error de tipos, atrapado antes de ejecutar. Los buffer overflows también. Los índices de array fuera de rango. El overflow de enteros. Todo esto pasa a ser chequeos en tiempo de compilación cuando agregás los refinamientos correctos.
- Probás propiedades en tiempo de compilación: distinto de cero, positivo, dentro de los límites
- Eliminás chequeos en runtime: cuando el compilador puede probar que es seguro
- Atrapás errores antes: el bug lo encuentra el type checker, no producción
- Verificación liviana: más que tipos, menos que pruebas completas
// F*: Refinement types with dependent types

// Natural numbers: ints >= 0
type nat = x:int{x >= 0}

// Positive numbers: ints > 0
type pos = x:int{x > 0}

// Division requires positive divisor (not just non-zero!)
val divide : int -> pos -> int
let divide x y = x / y

// This compiles: 5 is provably positive
let result = divide 10 5

// This FAILS at compile time:
// let bad = divide 10 0
// Error: expected pos, got int literal 0

// This also fails without more info:
// let risky (y: int) = divide 10 y
// Error: can't prove y > 0
// Vectors with length in the type (simple dependent types)
val head : #a:Type -> l:list a{length l > 0} -> a
let head #a l = List.hd l
// This compiles:
let first = head [1; 2; 3]
// This fails:
// let bad = head []
// Error: can't prove length [] > 0
// Safe indexing: index must be less than length
val nth : #a:Type -> l:list a -> i:nat{i < length l} -> a
// The refinement i < length l guarantees bounds safetyEl SMT solver puede fallar o agotar el tiempo con predicados complejos. Cuando funciona, parece magia. Cuando no, estás debuggeando por qué el solver no puede probar algo que vos sabés que es cierto. F*, Dafny, Liquid Haskell y Ada/SPARK usan todos este enfoque.
#Cuando los tipos refinados no alcanzan
Los tipos refinados funcionan bien para predicados sobre valores: ${x : Int \mid x > 0}$, chequeos de límites, no nulidad, restricciones aritméticas. Los SMT solvers manejan esto automáticamente. Pero se chocan con paredes.
La primera pared es el cómputo a nivel de tipos. Querés que printf "%d + %d = %d" tenga tipo Int -> Int -> Int -> String. El string de formato determina el tipo. Esto no es un predicado sobre un valor. Es computar un tipo a partir de un valor. Los tipos refinados no pueden expresar esto.
La segunda pared es el estado. Los session types necesitan tipos que cambien según las operaciones que hiciste. Los tipos refinados restringen valores, pero no pueden expresar “después de llamar a open(), el handle está en el estado Open”. Para eso necesitás tipos dependientes o tipos lineales.
La tercera pared es la inducción. Los SMT solvers son procedimientos de decisión para teorías específicas: aritmética lineal, vectores de bits, arrays. No hacen inducción. Los tipos refinados pueden decir “esta lista tiene largo > 0”, pero les cuesta “este vector tiene largo n + m”. Podés escribir ${v : Vec \mid len(v) = len(a) + len(b)}$, y para casos simples los SMT solvers lo pueden verificar. Pero probarlo a lo largo de llamadas recursivas, mostrando que cada paso preserva el invariante, requiere una inducción que el solver no puede hacer.
F* está en el límite. Tiene tanto tipos refinados (respaldados por SMT) como tipos dependientes completos (respaldados por pruebas). Empezás con refinamientos y escalás a pruebas manuales cuando el solver falla. Es un modelo mental razonable: los tipos refinados son tipos dependientes donde un demostrador automático se encarga de los casos fáciles. Si un SMT solver puede verificar tu propiedad en unos segundos, los tipos refinados funcionan. Si necesitás computar tipos, registrar estado o hacer inducción, cruzaste al territorio de los tipos dependientes.
#Nivel 4: Nivel de investigación
Estos conceptos se encuentran principalmente en lenguajes de investigación y asistentes de pruebas. Dan las garantías más fuertes, pero requieren bastante experiencia. Entenderlos ayuda aunque nunca los uses directamente.
#Tipos dependientes
Querés una función que concatene dos vectores. El resultado debería tener largo n + m. Con tipos comunes, podés expresar “devuelve un vector”, pero no “devuelve un vector cuyo largo es la suma de los de las entradas”.
// Regular types: can't express the length relationship
fn append<T>(a: Vec<T>, b: Vec<T>) -> Vec<T>
Los tipos refinados ayudan con los predicados, pero ¿y si los tipos pudieran computar?
Los tipos pueden depender de valores. Vector<3, Int> (un vector de 3 enteros) es un tipo distinto de Vector<5, Int>. No son el mismo tipo con el largo chequeado en runtime. Son tipos distintos. Una función que espera un vector de 3 elementos no va a aceptar un vector de 5 elementos, igual que una función que espera un String no va a aceptar un Int.
Los tipos de funciones pueden expresar relaciones entre entradas y salidas:
append : Vector<n, a> -> Vector<m, a> -> Vector<n + m, a>El tipo de retorno se computa a partir de los tipos de entrada. Si concatenás un vector de 3 elementos con uno de 5, obtenés un vector de 8 elementos. El n + m se evalúa a nivel de tipos. Los tipos y los términos viven en el mismo mundo.
Esta es la correspondencia de Curry-Howard con toda su fuerza. Los tipos son proposiciones. Los programas son pruebas. Vector<n, a> es una proposición: “existe un vector de n elementos de tipo a”. Construir un vector así prueba la proposición. Un tipo de función Vector<n, a> -> Vector<n, a> es una implicación: “si me das una prueba de un vector de n, te devuelvo una prueba de un vector de n”.
La ganancia: una multiplicación de matrices cuyas dimensiones se chequean en tiempo de compilación. $Matrix\langle n, m \rangle \times Matrix\langle m, p \rangle \to Matrix\langle n, p \rangle$. Si las dimensiones no coinciden, el código no compila.
- El chequeo de tipos requiere evaluación: indecidible en general
- Se requiere chequeo de terminación: las funciones que no terminan rompen el chequeo de tipos
- Probar es distinto de programar: tenés que pensar por qué el código es correcto, no solo que funciona
- Pruebas verbosas: a veces hay más código de prueba que código real
-- Idris 2: Dependent types

-- Vector indexed by its length
data Vect : Nat -> Type -> Type where
    Nil  : Vect 0 a
    (::) : a -> Vect n a -> Vect (S n) a

-- head: ONLY works on non-empty vectors
-- Not a runtime check. The TYPE prevents calling on empty.
head : Vect (S n) a -> a
head (x :: xs) = x

-- No case for Nil needed! Vect (S n) can't be Nil.
-- The S n pattern means "at least 1"

-- append: the type PROVES lengths add
append : Vect n a -> Vect m a -> Vect (n + m) a
append Nil       ys = ys
append (x :: xs) ys = x :: append xs ys

-- Type-safe matrix multiplication
Matrix : Nat -> Nat -> Type -> Type
Matrix rows cols a = Vect rows (Vect cols a)

-- Dimensions must match, checked at COMPILE TIME
matMul : Num a => Matrix n m a -> Matrix m p a -> Matrix n p a

-- This won't compile:
-- matMul (2x3 matrix) (5x2 matrix)
-- Error: expected Matrix 3 p, got Matrix 5 2
-- Type-safe printf!
-- The format string determines the function's type
printf : (fmt : String) -> PrintfType fmt
-- printf "%s is %d years old"
-- has type: String -> Int -> String
-- printf "%d + %d = %d"
-- has type: Int -> Int -> Int -> String
-- Wrong number/type of arguments = compile errorLos tipos dependientes están en Idris 2, Agda, Coq, Lean 4 y F*. Para la mayoría del código de aplicación, son demasiado. Los tipos refinados o los tipos fantasma muchas veces alcanzan.
#Tipado de comunicación y protocolos
La concurrencia introduce problemas que van más allá del código secuencial. Las funciones tienen tipos, pero ¿qué pasa con las interacciones? Los sistemas de tipos para la comunicación garantizan que los componentes distribuidos se pongan de acuerdo en los protocolos, evitando deadlocks y mensajes que no coinciden en tiempo de compilación.
#Por qué la concurrencia necesita tipos más allá de las funciones
En el código secuencial, un tipo de función A -> B te dice todo: das un A, obtenés un B. Pero los sistemas concurrentes tienen:
- Restricciones de orden: hay que mandar el request antes de recibir la respuesta
- Estados de protocolo: lo que podés hacer depende de lo que pasó antes
- Múltiples partes: el cliente, el servidor y quizás otros tienen que ponerse de acuerdo
- Modos de falla: deadlock, livelock, tipos de mensaje que no coinciden
Los tipos de funciones comunes no pueden expresar “después de mandar X, tenés que recibir Y antes de mandar Z”. Las violaciones de protocolo compilan sin problema pero fallan en runtime.
#Session types
Los session types (tipos de sesión) codifican protocolos de comunicación en los tipos de los canales. El tipo del canal cambia a medida que lo usás, registrando el estado del protocolo.
Los sistemas distribuidos se comunican por canales. El cliente manda un Request, el servidor responde con un Response. Pero ¿qué pasa si el cliente manda dos requests sin esperar? ¿O espera una respuesta que nunca llega? Las violaciones de protocolo causan deadlocks o fallas silenciosas, que se descubren recién en producción.
Los session types arreglan esto convirtiendo los canales en máquinas de estados tipadas. Empezás con !Request.?Response.End. Después de mandar un request, tenés ?Response.End. Después de recibir la respuesta, tenés End. Cada operación transforma el tipo. Usar la operación equivocada es un error de tipos.
Concepto clave: la dualidad. La vista del cliente es el dual de la vista del servidor: los envíos pasan a ser recepciones y viceversa. Si el cliente tiene !Request.?Response.End, el servidor tiene ?Request.!Response.End. Los tipos son simétricos. Esto asegura que los dos lados estén de acuerdo en el protocolo, verificado en tiempo de compilación. Los programas bien tipados no pueden caer en deadlock.
// Session types: Types encode protocols

// Notation:
// !T  = send value of type T
// ?T  = receive value of type T
// .   = sequencing
// End = session finished

// Client's protocol view
type BuyerProtocol =
    !String.       // send book title
    ?Price.        // receive price
    !Bool.         // send accept/reject
    End

// Server's view: the DUAL (swap ! and ?)
type SellerProtocol =
    ?String.       // receive title
    !Price.        // send price
    ?Bool.         // receive decision
    End

// Implementation (pseudocode)
buyer(channel: BuyerProtocol) {
    send(channel, "Types and Programming Languages");
    // channel now has type ?Price.!Bool.End

    let price = receive(channel);
    // channel now has type !Bool.End

    send(channel, price < 100);
    // channel now has type End

    close(channel);
}

// Multiparty session: Three-way protocol
global protocol Purchase(Buyer, Seller, Shipper) {
    item(String) from Buyer to Seller;
    price(Int) from Seller to Buyer;

    choice at Buyer {
        accept:
            payment(Int) from Buyer to Seller;
            address(String) from Buyer to Shipper;
            delivery(Date) from Shipper to Buyer;
        reject:
            cancel() from Buyer to Seller;
            cancel() from Buyer to Shipper;
    }
}
Los session types están mayormente en la investigación: Links, Scribble y varias implementaciones académicas. Pocos sistemas en producción los usan directamente, pero las ideas influyen en el diseño de APIs.
#Tipado de mensajes de actores
Los sistemas de actores (Erlang, Akka, Orleans) usan pasaje de mensajes en lugar de memoria compartida. Cada actor tiene un buzón y procesa los mensajes de forma secuencial. Pero ¿qué mensajes puede recibir un actor?
Sin tipado, cualquier mensaje se puede mandar a cualquier actor. Los errores de tipeo en los nombres de los mensajes, los tipos de payload equivocados o las violaciones de protocolo aparecen recién en runtime.
Los actores tipados restringen qué mensajes puede recibir un actor:
// Akka Typed: Actor's message type is explicit
object Counter {
  sealed trait Command
  case class Increment(replyTo: ActorRef[Int]) extends Command
  case class GetValue(replyTo: ActorRef[Int]) extends Command
}

// The actor can ONLY receive Counter.Command messages
def counter(value: Int): Behavior[Counter.Command] =
  Behaviors.receive { (context, message) =>
    message match {
      case Increment(replyTo) =>
        replyTo ! (value + 1)
        counter(value + 1)
      case GetValue(replyTo) =>
        replyTo ! value
        Behaviors.same
    }
  }

// Sending wrong message type = compile error
// counterRef ! "hello"  // ERROR: String is not Counter.Command
%% Erlang: Dialyzer can check message types via specs
-spec loop(state()) -> no_return().
loop(State) ->
receive
{increment, From} ->
From ! {ok, State + 1},
loop(State + 1);
{get, From} ->
From ! {ok, State},
loop(State)
end.#Comparando enfoques
| Enfoque | Qué se tipa | Garantías | Ejemplos |
|---|---|---|---|
| Canales sin tipos | Nada | Ninguna | Sockets crudos, la mayoría de los lenguajes |
| Mensajes tipados | Tipos de payload de los mensajes | Sin payloads equivocados | Canales de Go, mpsc de Rust |
| Tipos de comportamiento de actores | Qué acepta el actor | Sin mensajes inválidos | Akka Typed, Pony |
| Session types | Máquina de estados del protocolo | Sin violaciones de protocolo | Links, investigación |
| Sesiones multiparte | Protocolos de N partes | Seguridad del protocolo global | Scribble, investigación |
#Adopción en la práctica
Los traits Send y Sync de Rust son una forma liviana de tipado de concurrencia: marcan qué tipos pueden cruzar de forma segura los límites entre threads. Esto no es tipado de protocolos, pero previene data races en tiempo de compilación.
Los canales tipados de Go (chan int, chan Message) aseguran que los tipos de payload coincidan, pero no registran el estado del protocolo.
Los session types completos siguen siendo mayormente académicos, pero las ideas se están filtrando a la práctica. Las uniones discriminadas de TypeScript con matching exhaustivo aproximan los estados de protocolo. El patrón typestate de Rust usa el sistema de tipos para imponer secuencias válidas de operaciones.
#Teoría cuantitativa de tipos (QTT)
Los tipos lineales registran el uso (usar exactamente una vez). Los tipos dependientes necesitan inspeccionar valores a nivel de tipos. ¡Pero inspeccionar un valor para tipar no debería contar como “usarlo” en runtime!
-- We want the length n to be:
-- - Available at compile time (for type checking)
-- - Erased at runtime (zero cost)
data Vect : Nat -> Type -> Type
¿Cómo combinás de forma limpia los tipos lineales/afines con los tipos dependientes?
Anotá cada variable con una cantidad tomada de un semianillo:
- 0: solo en tiempo de compilación (se borra en runtime)
- 1: exactamente una vez (lineal)
- ω: sin límite
El problema clave que esto resuelve: en los tipos dependientes, el chequeo de tipos podría usar un valor para determinar un tipo, pero ese “uso” no debería contar en runtime. El largo n en Vect n a se usa a nivel de tipos para asegurar que los vectores tengan el tamaño correcto. Pero en runtime, no querés andar pasando n de un lado a otro. Debería borrarse.
Con QTT, escribís (0 n : Nat) para decir “n existe para el chequeo de tipos pero no tiene ninguna representación en runtime”. La cantidad 0 significa “se usa cero veces en runtime”. El type checker la usa. El código compilado no la incluye.
Esto también maneja limpiamente los recursos lineales. Un file handle tiene cantidad 1: lo usás exactamente una vez. Un entero normal tiene cantidad ω: lo usás todas las veces que quieras. Las cantidades forman un semianillo, lo que hace que se compongan correctamente cuando combinás funciones.
-- Idris 2 uses QTT natively

-- The 'n' has quantity 0: erased at runtime!
data Vect : (0 n : Nat) -> Type -> Type where
    Nil  : Vect 0 a
    (::) : a -> Vect n a -> Vect (S n) a

-- n is available for type checking but has zero runtime cost

-- Linear function: use x exactly once
dup : (1 x : a) -> (a, a)  -- ERROR: can't use x twice!

-- Valid linear function
consume : (1 x : File) -> IO ()

-- Unrestricted
normal : (x : Int) -> Int
normal x = x + x  -- Fine, x is unrestricted (quantity ω)

-- Mixing: erased type, linear value
id : (0 a : Type) -> (1 x : a) -> a
id _ x = x
-- a exists only at compile time
-- x is used exactly once at runtime
Idris 2 usa QTT. Granule es un lenguaje de investigación que explora los tipos graduados de forma más general.
#Teoría de tipos cúbica
La Teoría Homotópica de Tipos (HoTT) introdujo ideas revolucionarias: los tipos como espacios, la igualdad como caminos. El axioma de univalencia dice que los tipos equivalentes son iguales. Pero era solo un axioma que no computaba. Preguntar “¿estas dos pruebas de igualdad son la misma?” no obtenía respuesta.
Hacé que la igualdad sea computacional. En la teoría de tipos estándar, podés probar que dos cosas son iguales, pero no siempre podés computar con esa igualdad. La univalencia (los tipos equivalentes son iguales) era un axioma: podías afirmarla, pero no se reducía a nada. Preguntar “¿esta prueba de igualdad es la misma que aquella?” podía no dar respuesta.
La teoría de tipos cúbica arregla esto tomándose la homotopía en serio. Una prueba de igualdad a = b es literalmente un camino de a a b. Formalmente, es una función desde el tipo intervalo I (que representa [0,1]) hacia el tipo, donde la función manda 0 a a y 1 a b. Podés recorrer el camino. Lo podés invertir (simetría). Podés concatenar caminos (transitividad).
Esta intuición geométrica hace que la igualdad sea computacional. La univalencia pasa a ser un teorema: dada una equivalencia entre tipos, podés construir un camino entre ellos. Y, crucialmente, transportar valores a lo largo de ese camino efectivamente aplica la equivalencia. Todo se reduce. Todo computa. También obtenés gratis la extensionalidad funcional (las funciones son iguales si coinciden en todas las entradas) y los tipos inductivos superiores (cocientes, círculos, esferas como tipos).
-- Cubical Agda

{-# OPTIONS --cubical #-}

open import Cubical.Core.Everything

-- I is the interval type: points from 0 to 1
-- A path from a to b is a function I → A
-- where i0 ↦ a and i1 ↦ b

-- Reflexivity: constant path
refl : ∀ {A : Type} {a : A} → a ≡ a
refl {a = a} = λ i → a  -- For all points, return a

-- Symmetry: reverse the path
sym : ∀ {A : Type} {a b : A} → a ≡ b → b ≡ a
sym p = λ i → p (~ i)   -- ~ negates interval points

-- Function extensionality: just works!
-- If f x ≡ g x for all x, then f ≡ g
funExt : ∀ {A B : Type} {f g : A → B}
       → (∀ x → f x ≡ g x)
       → f ≡ g
funExt p = λ i x → p x i

-- Univalence: equivalences give paths between types
ua : ∀ {A B : Type} → A ≃ B → A ≡ B

-- And this COMPUTES: transporting along ua
-- actually applies the equivalence!
Cubical Agda, redtt, cooltt y Arend implementan la teoría de tipos cúbica. Salvo que estés investigando en teoría de tipos o formalizando matemática, no te va a hacer falta.
#Tipos de lógica de separación
Estás escribiendo código con punteros. ¿Cómo sabés que dos punteros no son alias uno del otro? ¿Que modificar *x no va a afectar a *y? En C, no lo sabés. Es comportamiento indefinido esperando a pasar.
void swap(int *x, int *y) {
    int tmp = *x;
    *x = *y;
    *y = tmp;
}
// If x == y this becomes a no-op.
// The deeper problem is that aliasing makes pointer-manipulating code
// much harder to reason about in general.
Razoná sobre el ownership de regiones del heap. El operador clave es la conjunción separadora (separating conjunction, *): P * Q significa “P vale para alguna región del heap, Q vale para una región separada”. Si probás que sos dueño de regiones separadas, no pueden ser alias.
La lógica clásica tiene la conjunción (∧): “P y Q son verdaderas las dos”. La lógica de separación agrega una conjunción nueva (*): “P vale para una parte de la memoria, Q vale para una parte distinta de la memoria, y esas partes no se superponen”. Esta es la pieza que faltaba para razonar sobre punteros.
Cuando escribís {x ↦ 5 * y ↦ 10}, estás afirmando: x apunta a 5, y apunta a 10, y x e y son posiciones distintas. La conjunción separadora hace explícito que no hay aliasing. Sin ella, modificar *x podría afectar a *y. Con ella, sabés que son independientes.
La regla del marco (frame rule) hace que las pruebas sean modulares. Si probás {P} code {Q} (ejecutar el código en el estado P da el estado Q), entonces {P * R} code {Q * R} para cualquier R. Lo que sea que describa R queda fuera del marco, sin que el código lo toque. Podés razonar sobre cada pedazo de memoria de forma independiente.
El borrow checker de Rust encarna estas ideas. Los préstamos mutables son ownership exclusivo de una región de memoria. La garantía de que no podés tener dos &mut a la misma posición es la conjunción separadora en acción. La lógica de separación concurrente extiende esto para razonar sobre concurrencia con memoria compartida.
// Separation logic specifications (pseudocode)

// Points-to assertion: x points to value v
x ↦ v

// Separating conjunction: DISJOINT ownership
// x ↦ a * y ↦ b means x and y are different locations
{x ↦ a * y ↦ b}    // precondition: x points to a, y points to b, SEPARATELY
swap(x, y)
{x ↦ b * y ↦ a}    // postcondition: values swapped

// The * GUARANTEES x ≠ y
// Without separation: aliasing can invalidate the proof obligation

// Frame rule: what you don't touch, stays the same
// If: {P} code {Q}
// Then: {P * R} code {Q * R}
// R is "framed out", untouched by code

// Linked list segment from head to tail
lseg(head, tail) =
    (head = tail ∧ emp)                            // empty segment
  ∨ (∃v, next. head ↦ (v, next) * lseg(next, tail)) // node + rest
// Rust's borrow checker encodes similar ideas
fn swap(x: &mut i32, y: &mut i32) {
// Rust GUARANTEES x and y don't alias
// Can't have two &mut to the same location!
let tmp = *x;
*x = *y;
*y = tmp;
}
// This won't compile:
// let mut n = 5;
// swap(&mut n, &mut n); // Error: can't borrow n mutably twiceLas ideas de la lógica de separación te llegan de forma implícita a través del borrow checker de Rust. Para pruebas explícitas, herramientas como Iris (Coq), Viper y VeriFast te permiten verificar código que manipula punteros.
#Sized types
Los sistemas de tipos dependientes necesitan saber que todas las funciones terminan. Si no, el chequeo de tipos podría quedar en un loop infinito. Normalmente exigen recursión estructural: los argumentos tienen que achicarse en un sentido sintáctico.
Pero esto rechaza programas válidos:
merge : Stream → Stream → Stream
merge (x:xs) (y:ys) = x : y : merge xs ys
¡Ni xs ni ys es estructuralmente más chico que los dos argumentos originales!
Registrá los tamaños de forma abstracta en los tipos. Un Stream<i> tiene “tamaño” i. Las operaciones podrían no ser sintácticamente más chicas, pero sí semánticamente más chicas en tamaño. El type checker registra los tamaños de forma simbólica.
El problema es el chequeo de terminación. Los type checkers dependientes tienen que asegurar que todas las funciones terminen; si no, el chequeo de tipos podría quedar en un loop infinito. La recursión estructural simple (“el argumento se achica”) funciona para muchos casos pero rechaza programas válidos.
Pensá en mezclar dos streams. En cada paso, tomás un elemento de cada stream. Ningún stream es “estructuralmente más chico” que las dos entradas. Pero semánticamente estás avanzando: estás consumiendo los dos streams. Los sized types (tipos con tamaño) capturan esto. Cada stream tiene un tamaño abstracto. Después de tomar un elemento, el stream que queda tiene un tamaño menor. El type checker ve que los tamaños decrecen y acepta la función.
Para datos coinductivos (estructuras infinitas como los streams), necesitás chequeo de productividad (productivity checking): tenés que producir salida en tiempo finito. Los sized types también manejan esto. El tamaño del stream de salida depende de los tamaños de entrada de una forma que garantiza que siempre avances.
{-# OPTIONS --sized-types #-}

open import Size

-- Stream indexed by size
data Stream (i : Size) (A : Set) : Set where
  _∷_ : A → Thunk (Stream i) A → Stream (↑ i) A

-- ↑ i means "larger than i"
-- Thunk delays evaluation (coinduction)

-- take: consume part of a sized stream
take : ∀ {i A} → Nat → Stream i A → List A
take zero    _        = []
take (suc n) (x ∷ xs) = x ∷ take n (force xs)

-- map preserves size
map : ∀ {i A B} → (A → B) → Stream i A → Stream i B
map f (x ∷ xs) = f x ∷ λ where .force → map f (force xs)

-- merge: interleave two streams
-- Both streams get "used", sizes track this correctly
zipWith : ∀ {i A B C} → (A → B → C) → Stream i A → Stream i B → Stream i C
zipWith f (x ∷ xs) (y ∷ ys) =
  f x y ∷ λ where .force → zipWith f (force xs) (force ys)

-- Without sized types, the termination checker might reject these
-- because it can't see that streams are being consumed productively
Agda soporta sized types. Son útiles cuando el chequeo de terminación es demasiado estricto, en particular para definiciones coinductivas.
#Pure Type Systems
Hay muchos cálculos lambda tipados: el simplemente tipado, System F, System Fω, el Cálculo de Construcciones, la teoría de tipos de Martin-Löf. Cada uno tiene sus propias reglas sobre qué puede depender de qué. ¿Hay un marco unificado?
Los Pure Type Systems (PTS, sistemas de tipos puros) proveen un único marco parametrizado que abarca la mayoría de los cálculos lambda tipados. Un PTS se define con tres conjuntos:
- Sorts ($\mathcal{S}$): los “tipos de los tipos”. Normalmente $$ (el tipo de los tipos ordinarios) y $\square$ (el tipo del propio $$)
- Axiomas ($\mathcal{A}$): qué sorts tienen qué sorts como tipo (por ejemplo, $* : \square$)
- Reglas ($\mathcal{R}$): ternas $(s_1, s_2, s_3)$ que especifican que las funciones de $s_1$ a $s_2$ viven en $s_3$
Variando estos parámetros, recuperás distintos sistemas de tipos:
| Sistema | Reglas | Qué expresa |
|---|---|---|
| Cálculo $\lambda$ simplemente tipado | $(*, *, *)$ | Términos que dependen de términos |
| System F | $(*, *, *), (\square, *, *)$ | Tipos que dependen de tipos (polimorfismo) |
| System F$\omega$ | $(*, *, *), (\square, *, *), (\square, \square, \square)$ | Higher-kinded types |
| $\lambda P$ (LF) | $(*, *, ), (, \square, \square)$ | Tipos que dependen de términos (tipos dependientes) |
| Cálculo de Construcciones | Las cuatro combinaciones de reglas | Tipos dependientes completos + polimorfismo |
El cubo lambda (Lambda Cube) visualiza esto: tres ejes que representan la abstracción de término a término, de tipo a tipo y de término a tipo. Cada vértice es un sistema de tipos distinto.
                    λC (CoC)
                   /|
                  / |
                 /  |
               λPω  λP2
               /|   /|
              / |  / |
             /  | /  |
           λω   λP   System F
            |   |   /
            |   |  /
            |   | /
λ→ (Simply Typed)#Por qué importa
Los PTS proveen:
- Teoría unificada: entender todos estos sistemas como instancias de un mismo marco
- Resultados metateóricos: probar propiedades (normalización, preservación de tipos) una vez y aplicarlas en todos lados
- Guía de diseño: cuando diseñás un sistema de tipos, estás eligiendo un punto en este espacio
- Reutilización de implementaciones: los type checkers se pueden parametrizar con la especificación del PTS
El Cálculo de Construcciones (el vértice superior) es la base de Coq. La teoría de tipos de Martin-Löf (relacionada pero distinta) está debajo de Agda. Entender los PTS aclara qué son los tipos dependientes: la capacidad de formar tipos que dependen de términos, puesta en pie de igualdad con las otras formas de abstracción.
#Conexión con la práctica
Cuando escribís Vector<n, T> en un lenguaje con tipos dependientes, estás usando una dependencia de término a tipo: el tipo Vector depende del término n. Ese es el eje λP del cubo lambda. Cuando escribís forall T. T -> T, estás usando polimorfismo de tipo a término: el vértice de System F.
Los lenguajes modernos con tipos dependientes viven cerca del vértice del CoC, con varios agregados (universos, tipos inductivos, efectos) que van más allá del marco PTS puro pero que igual se entienden a través de él.
#Lecturas adicionales
- “Lambda Calculi with Types”, de Henk Barendregt (la referencia definitiva)
- “Type Theory and Formal Proof”, de Rob Nederpelt y Herman Geuvers
#Nivel 5: Investigación de frontera
Estos conceptos están en la frontera de la investigación. Todavía no llegaron a los lenguajes de uso masivo, pero influyen en los diseños futuros. Un repaso breve para que esté completo:
| Concepto | Qué explora | Por qué importa |
|---|---|---|
| Tipos modales graduados | Unificar efectos + linealidad en un mismo marco | Un único sistema para muchas características |
| Call-by-Push-Value | Unificar call-by-name y call-by-value | Semántica operacional más limpia |
| Tipos polarizados | Tipos positivos (data) vs. negativos (codata) | Mejor comprensión de la dualidad |
| Ornaments | Derivar sistemáticamente tipos relacionados | Autogenerar List a partir de Nat |
| Programación genérica a nivel de tipos | Reflexión sobre la estructura de los tipos | Derivar instancias automáticamente |
| Relaciones lógicas | Probar equivalencia de programas | Base de la verificación |
| Realizabilidad | Extraer programas de pruebas | Programas a partir de matemática, automáticamente |
| Teoría de tipos observacional | Igualdad sin axiomas | Cómputo + extensionalidad |
| Teoría de tipos de dos niveles | Separar el metanivel del nivel objeto | Staging/metaprogramación limpios |
| Teoría de tipos multimodal | Múltiples modalidades (necesidad, etc.) | Generalizar muchas características |
#Tipos modales graduados (ejemplo breve)
-- Granule: grades unify linearity and effects

id : forall {a : Type} . a [1] -> a   -- use exactly once
id [x] = x

dup : forall {a : Type} . a [2] -> (a, a)  -- use exactly twice
dup [x] = (x, x)

-- Grades form a semiring, combining naturally
-- One system handles linearity, privacy, information flow...#Conceptos prácticos
Algunos conceptos que no encajan en la estructura de niveles pero que importan en la práctica:
#Varianza
Si JsonResponse <: HttpResponse, ¿cuál es la relación entre List<JsonResponse> y List<HttpResponse>? Depende de cómo use el contenedor su parámetro de tipo.
Esta pregunta importa para todo tipo genérico. Podrías esperar que List<JsonResponse> sea siempre un subtipo de List<HttpResponse>. Pero en general eso está mal, y entender por qué es clave para escribir código genérico correcto.
La intuición: si de un contenedor solo podés leer (produce), entonces List<JsonResponse> puede reemplazar a List<HttpResponse>. Pediste respuestas HTTP, te doy respuestas JSON, las respuestas JSON son respuestas HTTP, todos contentos. Pero si en un contenedor podés escribir (consume), es al revés. Un contenedor que acepta cualquier respuesta HTTP puede aceptar respuestas JSON. Pero un contenedor que solo acepta respuestas JSON no puede reemplazar a uno que acepta cualquier respuesta HTTP, porque alguien podría intentar meterle una respuesta XML.
Los contenedores mutables son el caso problemático. Podés leer y escribir. Ninguna dirección del subtipado es segura. La decisión de Java de hacer covariantes los arrays fue un error que todavía estamos pagando. Podés meter un Integer en un Number[] que en runtime es en realidad un Double[], y explota.
// TypeScript: variance annotations

// Covariant (out): Producer<JsonResponse> <: Producer<HttpResponse>
interface ResponseSource<out T> {
    fetch(): T;
}
// If it produces JsonResponses, it produces HttpResponses

// Contravariant (in): Handler<HttpResponse> <: Handler<JsonResponse>
interface ResponseHandler<in T> {
    handle(x: T): void;
}
// If it handles any HttpResponse, it can handle JsonResponses

// Invariant: no subtyping relationship
interface ResponseCache<T> {
    get(): T;          // covariant use
    store(x: T): void; // contravariant use
}
// Both uses = invariant (no safe subtyping)#Tipos fantasma
Parámetros de tipo que aparecen en el tipo pero no en los datos. Se usan para hacer distinciones en tiempo de compilación.
Al principio suena inútil. ¿Para qué tener un parámetro de tipo que no afecta a los datos? La respuesta: para llevar información a nivel de tipos que el compilador chequea, aunque el runtime no la necesite.
Pensá en un UserId y un ProductId. Los dos son solo enteros en runtime. Pero mezclarlos es un bug. Con tipos fantasma (phantom types), Id<User> e Id<Product> son tipos distintos, aunque los dos contengan un único entero. El parámetro fantasma (User o Product) existe solo para el type checker. Costo cero en runtime. Seguridad completa en tiempo de compilación.
La Mars Climate Orbiter (1999) se perdió porque un equipo usaba unidades métricas mientras otro usaba unidades imperiales, y 327 millones de dólares se quemaron en la atmósfera marciana. Los tipos fantasma convierten las inconsistencias de unidades en errores de compilación: Distance<Meters> y Distance<Feet> no se pueden mezclar.
use std::marker::PhantomData;

// Unit types (no data, just type-level tags)
struct Meters;
struct Feet;

// Distance carries a unit, but only at type level
struct Distance<Unit> {
    value: f64,
    _unit: PhantomData<Unit>,  // zero runtime cost
}

impl<U> Distance<U> {
    fn new(value: f64) -> Self {
        Distance { value, _unit: PhantomData }
    }
}

// Can only add distances with the same unit
fn add<U>(a: Distance<U>, b: Distance<U>) -> Distance<U> {
    Distance::new(a.value + b.value)
}

let meters: Distance<Meters> = Distance::new(100.0);
let feet: Distance<Feet> = Distance::new(50.0);

// add(meters, feet);  // ERROR: expected Meters, got Feet
add(meters, Distance::new(50.0)); // OK: both Meters#Polimorfismo de filas
Funciones que trabajan sobre records con “al menos estos campos”, preservando los demás campos.
Los generics comunes abstraen sobre tipos. El polimorfismo de filas (row polymorphism) abstrae sobre la estructura de los records. Una función getName necesita records con un campo name. No le deberían importar los demás campos. El polimorfismo de filas te deja escribir esto: “dame cualquier record con al menos un campo name: String, y te devuelvo el nombre”.
Los campos extra pasan sin cambios. Si tenés { name: "Ada", age: 36, title: "Countess" } y llamás a getName, te devuelve “Ada”. La función ignora age y title, pero no te obliga a sacarlos antes. Es más flexible que el subtipado estructural porque es paramétrico: funciona de forma uniforme para cualquier campo extra.
Esto es común en los lenguajes funcionales con records (PureScript, Elm, OCaml) y resuelve el problema de escribir funciones que operan sobre “records con ciertos campos” sin atarse a un tipo de record específico.
-- PureScript: Row polymorphism

-- Works on ANY record with a name field
-- The | r means "and possibly other fields"
getName :: forall r. { name :: String | r } -> String
getName rec = rec.name

-- Preserves extra fields!
getName { name: "Ada", age: 36 }             -- "Ada"
getName { name: "Alan", email: "a@b.c" }     -- "Alan"

-- Can require multiple fields
greet :: forall r. { name :: String, title :: String | r } -> String
greet rec = rec.title <> " " <> rec.name

greet { name: "Lovelace", title: "Countess", birth: 1815 }
-- "Countess Lovelace"
-- The 'birth' field passes through, ignored but preserved#Lenguajes comparados
En lugar de rankear los lenguajes en una línea, esta sección ubica lenguajes populares sobre los ejes de la taxonomía. Los lenguajes reales son paquetes de trade-offs.
#Tablas comparativas
#Sistema de tipos central
| Lenguaje | Chequeo | Disciplina | Polimorfismo |
|---|---|---|---|
| Rust | Estático | Nominal | Paramétrico + traits |
| Haskell | Estático | Nominal | Paramétrico + typeclasses |
| OCaml | Estático | Nominal + estructural | Paramétrico + módulos |
| Scala | Estático | Nominal | Paramétrico + implicits |
| TypeScript | Gradual | Estructural | Paramétrico + uniones |
| Python | Dinámico | Nominal + protocols | Ad hoc en runtime |
| Java | Estático | Nominal | Paramétrico (con borrado) |
| C# | Estático | Nominal | Paramétrico |
| Go | Estático | Estructural | Paramétrico + interfaces |
| Kotlin | Estático | Nominal | Paramétrico + reified |
| C++ | Estático | Nominal | Templates |
| Lean/Coq | Estático | Dependiente | Dependiente completo |
#Características avanzadas
| Lenguaje | Inferencia | Linealidad | Efectos | Soundness |
|---|---|---|---|---|
| Rust | Bidireccional | Afín + lifetimes | Vía tipos | Sound |
| Haskell | HM extendido | Lineal opcional | Mónadas | Mayormente sound |
| OCaml | HM | Ninguna | Algebraicos | Sound |
| Scala | Bidireccional | Ninguna | Biblioteca | Unsound en los bordes |
| TypeScript | Por restricciones | Ninguna | Ninguno | Unsound* |
| Python | Mínima | Ninguna | Ninguno | Unsound |
| Java | Local | Ninguna | Ninguno | Mayormente sound |
| C# | Local | Ninguna | Ninguno | Sound |
| Go | Local | Ninguna | Ninguno | Sound |
| Kotlin | Local | Ninguna | Ninguno | Sound |
| C++ | Mínima | Manual/move | Ninguno | Fácil de romper |
| Lean/Coq | Bidireccional | Ninguna | Puro | Sound |
*TypeScript es unsound a propósito, por razones pragmáticas.
#Perfiles de lenguajes
#Rust
Ownership y tipado afín para la seguridad en sistemas.
El sistema de tipos de Rust está construido alrededor de la gestión de recursos. Los tipos afines (valores que se usan como mucho una vez) se combinan con el borrow checker para eliminar use-after-free, data races y leaks de recursos en tiempo de compilación. Los lifetimes son tipos de región que prueban que las referencias no viven más que aquello a lo que refieren.
Trade-offs: no tener garbage collector significa que algunos patrones (estructuras cíclicas) requieren rodeos. Contá con pelearte con el borrow checker unas semanas hasta que te haga clic. Pero para código de sistemas, las garantías de seguridad no tienen rival fuera de los lenguajes de investigación.
Ideal para: programación de sistemas, aplicaciones donde la performance es crítica, cualquier lugar donde importe la seguridad de memoria.
#Haskell
Polimorfismo paramétrico más codificación de efectos.
Haskell fue pionero de las typeclasses (polimorfismo ad hoc sin herencia) y demostró que registrar efectos mediante mónadas funciona a escala. El sistema de tipos soporta higher-kinded types, GADTs, type families y, con extensiones, se acerca a los tipos dependientes.
Trade-offs: la complejidad se acumula. Las extensiones interactúan de formas sorprendentes. La evaluación lazy complica razonar sobre la performance. Ser productivo en Haskell requiere internalizar conceptos que no se trasladan desde los lenguajes imperativos.
Ideal para: compiladores, sistemas financieros, cualquier lugar donde la corrección importe más que la velocidad de onboarding.
#OCaml
Programación funcional pragmática con fundamentos sound.
OCaml mantiene simple la inferencia de Hindley-Milner mientras agrega módulos con tipado estructural. El sistema de módulos habilita la abstracción y la compilación separada. OCaml 5 agregó efectos algebraicos, trayendo manejo de efectos de primera clase.
Trade-offs: menos expresivo que Haskell, menos bibliotecas que los lenguajes de uso masivo. Pero la simplicidad es intencional: el sistema de tipos se mantiene predecible.
Ideal para: compiladores (incluido el original de Rust), demostradores de teoremas, implementación de DSLs.
#Scala
Máxima expresividad sobre la JVM.
Scala empuja los límites de lo que se puede expresar en un lenguaje con tipado estático: path-dependent types, implicits para cómputo a nivel de tipos, tipos unión e intersección. Scala 3 limpia la sintaxis mientras agrega match types e inferencia explícita de términos.
Trade-offs: la expresividad genera complejidad. Los tiempos de compilación sufren. Algunos rincones son unsound. El sistema de tipos puede ser “demasiado poderoso” para equipos que no lo necesitan.
Ideal para: modelado de dominios complejos, big data (Spark), cualquier lugar donde necesites compatibilidad con la JVM y tipos avanzados.
#TypeScript
Tipado gradual estructural con fuerte sensibilidad al flujo.
TypeScript eligió el tipado estructural para modelar el duck typing de JavaScript, y el tipado gradual para permitir una adopción incremental. Su estrechamiento de tipos sensible al flujo está entre los mejores: el tipo de una variable cambia según el flujo de control. Los tipos unión y las uniones discriminadas traen los tipos de datos algebraicos a JavaScript.
Trade-offs: es unsound a propósito en varios lugares (parámetros de funciones bivariantes, type assertions). El objetivo es la usabilidad y el tooling, no las pruebas. any siempre es una vía de escape.
Ideal para: codebases grandes de JavaScript, equipos que migran de código sin tipos a código tipado, desarrollo frontend.
#Python
Flexibilidad en runtime con hints estáticos opcionales.
El sistema de tipos de Python está agregado de afuera: el runtime ignora por completo los type hints. Herramientas como mypy y pyright los chequean estáticamente. Esto permite una adopción gradual, pero significa que los tipos son consultivos, no obligatorios.
Trade-offs: sin garantías en runtime. La cobertura de tipos varía a lo largo del ecosistema. Pero la flexibilidad es intencional: Python prioriza “sacar las cosas adelante” por sobre probar corrección.
Ideal para: scripting, data science, prototipado rápido, cualquier lugar donde la velocidad de desarrollo le gane a la seguridad en runtime.
#Java
Tipado nominal empresarial con una evolución conservadora.
Los generics de Java usan type erasure (borrado de tipos) por compatibilidad hacia atrás, lo que limita lo que se puede expresar. El sistema de tipos es nominal: las declaraciones explícitas definen las relaciones. La evolución es lenta y deliberada.
Trade-offs: verboso. Inferencia limitada. Sin value types (hasta Valhalla). Pero la estabilidad y la compatibilidad hacia atrás importan para el software empresarial. El código escrito en 2004 todavía compila.
Ideal para: sistemas empresariales, desarrollo Android, cualquier lugar donde importe la estabilidad a largo plazo.
#C#
Tipado nominal pragmático con una evolución sostenida.
C# evoluciona más rápido que Java, agregando características como los nullable reference types (registro de null sensible al flujo), pattern matching y records. El sistema de tipos es nominal pero cada vez más expresivo.
Trade-offs: una historia centrada en Windows (aunque .NET Core es multiplataforma). Menos expresivo que Scala o Haskell. Pero la evolución es pragmática: características que funcionan en entornos empresariales.
Ideal para: desarrollo en Windows, desarrollo de juegos (Unity), sistemas .NET empresariales.
#Go
Minimalismo estructural.
Go limita deliberadamente el sistema de tipos. Las interfaces son estructurales (las implementás teniendo los métodos), los generics se agregaron a regañadientes. La filosofía: herramientas simples para problemas simples.
Trade-offs: la falta de expresividad implica código repetitivo. No tener tipos suma implica manejar errores con retornos múltiples. Pero la simplicidad ayuda al onboarding y al tooling.
Ideal para: infraestructura cloud, herramientas de CLI, servicios donde la simplicidad ayuda al mantenimiento.
#Kotlin
Null safety y smart casts integrados al sistema de tipos.
Kotlin trata los tipos nullable como ciudadanos de primera clase: String no es nullable, String? sí lo es, y el compilador te obliga a manejar la diferencia. Los smart casts estrechan los tipos automáticamente después de los chequeos. Si escribiste if (x is String), el compilador sabe que x es un String adentro de esa rama, sin cast. Combinado con sealed classes (tipos suma), data classes y corrutinas, Kotlin es como se vería Java si se diseñara hoy.
Trade-offs: sigue atado a la JVM para la mayoría de los casos de uso (Kotlin/Native y Kotlin/JS existen, pero están menos maduros). La superficie del lenguaje no para de crecer. Pero para Android y para trabajo del lado del servidor en la JVM, es una mejora estricta sobre el sistema de tipos de Java.
Ideal para: desarrollo Android, código del lado del servidor en la JVM, cualquier lugar donde quieras interoperar con Java con un sistema de tipos moderno.
#C++
Poder sin chequeos.
Los templates de C++ son Turing-completos, lo que habilita una metaprogramación extrema. La semántica de move aproxima los tipos afines, pero no se hace cumplir. El sistema de tipos puede expresar casi cualquier cosa pero no garantiza casi nada.
Trade-offs: es fácil escribir comportamiento indefinido. Los errores de compilación son famosos. Pero cuando necesitás abstracción sin overhead con control total, no hay nada que compita.
Ideal para: motores de juegos, sistemas embebidos, código de performance crítica donde el control importa más que la seguridad.
#Lean y Coq
Los tipos son pruebas.
Son asistentes de pruebas primero y lenguajes de programación después. Los tipos dependientes completos significan que los tipos pueden expresar cualquier proposición matemática, y los programas son pruebas de esas proposiciones. Chequear tipos es demostrar teoremas.
Trade-offs: escribir pruebas es difícil. Las bibliotecas son limitadas. Pero para software verificado (CompCert, seL4), son la referencia de oro.
Ideal para: verificación formal, formalización de la matemática, sistemas críticos que requieren pruebas.
#Resúmenes en una oración
| Lenguaje | Identidad central del sistema de tipos |
|---|---|
| Rust | Ownership y tipado afín para la seguridad de memoria |
| Haskell | Polimorfismo paramétrico más efectos monádicos |
| OCaml | Inferencia HM sound con módulos estructurales |
| Scala | Máxima expresividad sobre la JVM |
| TypeScript | Tipado gradual estructural con sensibilidad al flujo |
| Python | Flexibilidad en runtime con hints estáticos opcionales |
| Java | Tipado nominal empresarial conservador |
| C# | Tipado nominal pragmático con una evolución sostenida |
| Go | Minimalismo estructural por diseño |
| Kotlin | Null safety y smart casts sobre la JVM |
| C++ | Poder sin chequeos vía templates |
| Lean/Coq | Tipos dependientes donde los programas son pruebas |
#Síntesis
#Qué hace difíciles a los sistemas de tipos
#Decidibilidad
Cuanto más expresivo, más difícil de chequear automáticamente:
| Característica | Chequeo de tipos |
|---|---|
| Simplemente tipado | Decidible, tiempo lineal |
| Hindley-Milner | Decidible, exponencial en el peor caso |
| System F (rango N) | Chequeo decidible, inferencia indecidible |
| Tipos dependientes | Indecidible en general (requiere chequeo de terminación) |
#Inferencia
¿Cuánto puede deducir el compilador sin anotaciones?
| Característica | Inferencia |
|---|---|
| Tipos locales | Completa |
| Generics (HM) | Completa |
| GADTs | Parcial (requiere anotaciones en los matches de GADTs) |
| Rango superior | Ninguna (requiere foralls explícitos) |
| Dependientes | Casi ninguna (probar necesita guía) |
#Igualdad de tipos
¿Cuándo dos tipos son “el mismo”?
| Sistema | Igualdad |
|---|---|
| Simple | Sintáctica: Int = Int |
| Con alias | Estructural: type Age = Int, entonces Age = Int |
| Dependiente | Computacional: hay que evaluar para comparar |
| HoTT | Homotópica: caminos entre tipos |
#Interacción entre características
Las características muchas veces se componen mal:
- Subtipado + inferencia: hace la inferencia mucho más difícil
- Tipos dependientes + efectos: necesitan un cuidado especial (efectos en los tipos)
- Tipos lineales + funciones de orden superior: registro de ownership sutil
- GADTs + type families: pueden hacer que la inferencia sea impredecible
#Evidencia práctica: ¿los tipos realmente ayudan?
Las anécdotas dicen que los tipos atrapan bugs. Pero ¿qué dice la evidencia?
#Estudios empíricos
| Estudio | Hallazgo |
|---|---|
| Hanenberg et al. (2014) | Los tipos estáticos mejoraron el tiempo de desarrollo en tareas grandes, pero no en las chicas |
| Mayer et al. (2012) | Las anotaciones de tipos ayudaron a comprender el código, sobre todo el código desconocido |
| Gao et al. (2017) | ~15% de los bugs de JavaScript en los proyectos estudiados habrían sido atrapados por TypeScript/Flow |
| Ray et al. (2014) | Los lenguajes con sistemas de tipos más fuertes se correlacionaron con menos commits de corrección de bugs (estudio de GitHub sobre 729 proyectos, aunque la metodología y los tamaños de efecto fueron muy debatidos) |
| Microsoft (2019) | El 70% de las vulnerabilidades de seguridad en su código C/C++ eran problemas de seguridad de memoria (abordables con tipos al estilo de Rust) |
La evidencia es mixta pero en general positiva:
- Los tipos ayudan más en codebases grandes y con código desconocido
- Los tipos ayudan menos en scripts chicos, donde el overhead supera al beneficio
- Los tipos de seguridad de memoria (Rust) muestran las ganancias más claras en código crítico para la seguridad
- La adopción gradual (TypeScript) muestra una reducción medible de bugs incluso con cobertura parcial
#Impacto en el tooling
Los sistemas de tipos habilitan un tooling que los lenguajes sin tipos no pueden igualar:
| Capacidad | Habilitada por | Ejemplo |
|---|---|---|
| Autocompletado preciso | Información de tipos | El IDE conoce los métodos de una variable |
| Refactor seguro | Chequeo de tipos | Renombrar un símbolo en todo el codebase |
| Ir a la definición | Resolución de tipos | Saltar a la implementación real |
| Documentación en línea | Firmas de tipos | Ver los tipos de parámetros y de retorno |
| Detección de código muerto | Exhaustividad | Se marcan las ramas inalcanzables |
| Errores en tiempo de compilación | Chequeo de tipos | Atrapar errores antes de ejecutar |
Lenguajes como TypeScript transformaron el desarrollo en JavaScript principalmente a través del tooling, no de la seguridad en runtime. Los tipos existen en gran parte para potenciar la experiencia en el IDE.
El punto justo varía según el proyecto. Un script de fin de semana no necesita el borrow checker de Rust. Un motor de base de datos, sí.
#Verificación en la práctica
Los tipos dependientes y los asistentes de pruebas borran la línea entre programar y hacer matemática. ¿Cómo se usan en la realidad?
#Sistemas verificados reales
| Sistema | Qué prueba | Lenguaje/herramienta |
|---|---|---|
| CompCert | El compilador de C preserva la semántica del programa | Coq |
| seL4 | El microkernel no tiene bugs (corrección funcional completa) | Isabelle/HOL |
| HACL* | La biblioteca criptográfica es correcta y resistente a side channels | F* |
| Everest | Stack HTTPS verificado (TLS 1.3) | F*, Dafny, Vale |
| CertiKOS | Aislamiento en un kernel de sistema operativo concurrente | Coq |
| Iris | Framework de lógica de separación concurrente | Coq |
| Mathlib de Lean | Más de 200.000 declaraciones matemáticas | Lean 4 |
Estos son sistemas en producción, no juguetes. CompCert se usa en la industria aeroespacial. seL4 corre en helicópteros militares. HACL* está en Firefox y en Linux.
#El flujo de trabajo de la verificación
Escribir código verificado es distinto de programar normalmente:
1. SPECIFICATION
   Write a formal spec of what the code should do
   (This is often harder than writing the code)

2. IMPLEMENTATION
   Write the code that implements the spec

3. PROOF
   Prove the implementation satisfies the spec
   (Interactive: you guide the prover)
   (Automated: SMT solver finds proof or fails)

4. EXTRACTION
   Generate executable code from the verified artifact
(Coq → OCaml/Haskell, F* → C/WASM)#La carga de las pruebas
La proporción entre el código de prueba y el código de implementación da que pensar:
| Proyecto | Implementación | Prueba | Proporción |
|---|---|---|---|
| seL4 | ~10K líneas de C | ~200K líneas de prueba | 20:1 |
| CompCert | ~20K líneas de Coq | ~100K líneas de Coq | 5:1 |
| F* típico | varía | 2-10x la implementación | 2-10:1 |
Por eso la verificación se reserva para la infraestructura crítica, no para la lógica de negocio. Pero la proporción mejora a medida que las herramientas maduran.
#Verificación liviana
Las pruebas completas son caras. Los enfoques más livianos ofrecen garantías parciales:
| Enfoque | Qué obtenés | Costo |
|---|---|---|
| Tipos refinados (Liquid Haskell) | Probar propiedades vía SMT | Pocas anotaciones |
| Property-based testing (QuickCheck) | Encontrar contraejemplos | Escribir propiedades |
| Fuzzing | Encontrar crashes/bugs | Tiempo de CPU |
| Model checking | Explorar el espacio de estados | Construir un modelo |
| Diseño por contrato | Chequeos en runtime a partir de especificaciones | Escribir contratos |
Los tipos refinados son el punto justo para muchas aplicaciones: obtenés garantías significativas (límites de arrays, no nulo, positivo) sin pruebas completas. Liquid Haskell y F* hacen que esto sea práctico.
#Cuándo verificar
| Verificá cuando… | Salteate la verificación cuando… |
|---|---|
| Es crítico para la seguridad informática (cripto, autenticación) | Es un prototipo/MVP |
| Es crítico para la seguridad física (medicina, aeroespacial) | Es lógica de negocio |
| Es infraestructura de alta confiabilidad | Es código de UI |
| La corrección importa más que la fecha de entrega | Manda el deadline |
| Los bugs son catastróficamente caros | Los bugs son baratos de arreglar |
La mayor parte del código no necesita verificación formal. Pero para el código que sí, los tipos que pueden expresar y chequear pruebas son invaluables.
#El ranking de complejidad
| Puesto | Concepto | Aprenderlo | Implementarlo | Vale la pena para |
|---|---|---|---|---|
| 1 | ADTs + pattern matching | Bajo | Bajo | Todos |
| 2 | Generics | Bajo | Medio | Todos |
| 3 | Traits/typeclasses | Medio | Medio | Autores de bibliotecas |
| 4 | Tipos afines (Rust) | Medio | Medio | Programadores de sistemas |
| 5 | GADTs | Difícil | Medio | Autores de DSLs/compiladores |
| 6 | HKT | Difícil | Difícil | Entusiastas de FP |
| 7 | Sistemas de efectos | Difícil | Difícil | Diseñadores de lenguajes |
| 8 | Tipos refinados | Difícil | Difícil | Software verificado |
| 9 | Tipos dependientes | Muy difícil | Muy difícil | Investigadores, ingenieros de pruebas |
| 10 | Session types | Muy difícil | Muy difícil | Verificación de protocolos |
| 11 | Cúbica/HoTT | Extremo | Extremo | Matemática, fundamentos |
#Qué aprender según tus objetivos
| Tu objetivo | Enfocate en |
|---|---|
| Escribir mejor código en cualquier lenguaje | ADTs, pattern matching, generics, traits |
| Programación de sistemas | Tipos afines (aprendé Rust) |
| Diseño de bibliotecas | Generics, traits, tipos asociados |
| Programación funcional | HKT, typeclasses, efectos |
| Construir compiladores/intérpretes | GADTs, nociones básicas de tipos dependientes |
| Verificación formal | Tipos refinados, tipos dependientes |
| Investigación en lenguajes de programación | Todo, incluida HoTT |
#El futuro
Varias tendencias están cambiando la forma en que pensamos los tipos:
-
Los sistemas de efectos llegan al uso masivo: Unison y Koka marcan el camino. Esperá que más lenguajes registren efectos.
-
Tipos refinados en lenguajes prácticos: la verificación liviana se vuelve accesible.
-
Los tipos lineales se expanden: Rust demostró que los tipos afines funcionan a escala. Otros van a seguir.
-
Tipos dependientes graduales: meter los tipos dependientes en los lenguajes de uso masivo de forma incremental.
-
Mejor tooling: los errores de tipos son cada vez más claros. El soporte de los IDEs mejora. La brecha de UX se está cerrando.
#Conclusión
Los sistemas de tipos existen en un espectro que va desde el “autocompletado útil” hasta las “pruebas matemáticas chequeadas por máquina”. Dónde te conviene estar en ese espectro depende de qué estés construyendo.
Para la mayor parte del código, los conceptos de los niveles 1 y 2 (ADTs, generics, traits, pattern matching) eliminan los bugs que más tiempo de debugging hacen perder: null pointer exceptions, casos de enums olvidados, tipos que no coinciden. Están disponibles en Rust, Scala, Swift, Kotlin e incluso TypeScript.
Los conceptos del nivel 3 (HKT, tipos lineales, efectos) requieren más inversión, pero te permiten abstraer sobre contenedores, registrar recursos y probar pureza. El modelo de ownership de Rust muestra que los conceptos “difíciles” pueden volverse masivos cuando el tooling es el correcto.
Los conceptos del nivel 4 en adelante (tipos dependientes, session types, HoTT) son mayormente para investigadores y especialistas, pero de ahí salen las características masivas de mañana. Los tipos lineales eran “investigación” hasta Rust. Los sistemas de efectos podrían ser los siguientes.
La mejor inversión es entender las ideas por encima de la sintaxis. Una vez que asimilás “hacé que los estados ilegales sean irrepresentables”, lo vas a aplicar en cualquier lenguaje. Una vez que entendés por qué importan los tipos lineales, vas a valorar el borrow checker de Rust en lugar de pelearte con él.
#Apéndice: taxonomía de los sistemas de tipos
Este apéndice ofrece una taxonomía de referencia de las dimensiones de los sistemas de tipos. Estos conceptos sirven para entender en qué difieren los lenguajes, pero no son requisitos para el contenido principal.
#Inferencia de tipos de Hindley-Milner
Esta sección cubre cómo funciona la inferencia de tipos por dentro: sirve para entender el comportamiento del compilador, pero no hace falta para usar los sistemas de tipos de forma efectiva.
El tipado estático tradicionalmente significaba anotar todo. El infame de Java:
Map<String, List<Integer>> map = new HashMap<String, List<Integer>>();Esta verbosidad es la razón por la que muchos desarrolladores huyeron a los lenguajes dinámicos. Pero el tipado dinámico implica descubrir los tipos que no coinciden en runtime, muchas veces en producción.
¿Y si el compilador pudiera deducir los tipos? En 1969, Roger Hindley descubrió (y Robin Milner redescubrió de forma independiente en 1978) un algoritmo que puede inferir el tipo más general de cualquier expresión en cierta clase de sistemas de tipos, sin ninguna anotación.
La observación clave: incluso sin anotaciones, el código contiene información de tipos. Si escribís x + 1, el compilador sabe que x tiene que ser un número porque + requiere números. Si escribís x.len(), x tiene que ser algo con un método len. Estas restricciones se propagan por todo tu programa.
El algoritmo funciona así:
- Asigna variables de tipo nuevas a los tipos desconocidos (como en álgebra: sea
xuna incógnita) - Junta restricciones a partir de cómo se usan los valores (
x + 1significa quextiene que ser numérico) - Unifica las restricciones para encontrar la solución más general (resuelve las ecuaciones)
Lo de “más general” importa. Si escribís una función que funciona sobre cualquier lista, el algoritmo infiere “lista de cualquier cosa”, no “lista de enteros”. Obtenés la máxima reutilización automáticamente.
- La brevedad de Python con la seguridad del tipado estático
- Escribís código sin anotaciones de tipos; el compilador las deduce
- Atrapás los errores de tipos en tiempo de compilación, no en runtime
- El tipo inferido es siempre el más general, así que tu función sirve para todos los tipos que encajen
// Rust: The compiler infers all types here
fn compose<A, B, C>(f: impl Fn(B) -> C, g: impl Fn(A) -> B) -> impl Fn(A) -> C {
    move |x| f(g(x))
}

let add_one = |x| x + 1;        // inferred: i32 -> i32
let double = |x| x * 2;         // inferred: i32 -> i32
let add_one_then_double = compose(double, add_one);

// No type annotations needed, compiler infers everything
let result = add_one_then_double(5);  // 12
// Even complex generic code needs minimal annotations
fn map<T, U>(items: Vec<T>, f: impl Fn(T) -> U) -> Vec<U> {
items.into_iter().map(f).collect()
}
let numbers = vec![1, 2, 3];
let strings = map(numbers, |n| n.to_string());
// Compiler infers: T = i32, U = StringEl trade-off: algunas características avanzadas (GADTs, tipos de rango superior) rompen la inferencia y requieren anotaciones. Pero para el código de todos los días, obtenés la seguridad del tipado estático sin su verbosidad tradicional. Disponible en ML, OCaml, Haskell, Rust, F#, Elm y Scala.
#Más allá de HM: otras estrategias de inferencia
Hindley-Milner es la referencia de oro para la inferencia en lenguajes puramente funcionales, pero existen otras estrategias:
| Estrategia | Cómo funciona | Se usa en |
|---|---|---|
| Bidireccional | Los tipos fluyen tanto hacia arriba (inferencia) como hacia abajo (chequeo) | Rust, Scala, Agda |
| Basada en restricciones | Junta restricciones y las resuelve con SMT/unificación | Tipado gradual, tipos refinados |
| Local | Infiere dentro de las expresiones, exige declaraciones en los bordes | Java (var), C++ (auto) |
El tipado bidireccional es particularmente importante para los lenguajes modernos. En lugar de inferencia pura (de abajo hacia arriba) o chequeo puro (de arriba hacia abajo), los tipos fluyen en las dos direcciones. Cuando escribís let x: Vec<i32> = vec![1, 2, 3], el tipo esperado Vec<i32> fluye hacia abajo para ayudar a inferir el tipo de los elementos. Cuando escribís let x = vec![1, 2, 3], los tipos de los literales fluyen hacia arriba para inferir Vec<i32>.
Esto escala mejor que HM puro a sistemas de tipos más ricos. Los GADTs, los tipos de rango superior y los tipos dependientes funcionan todos bien con el tipado bidireccional, porque las anotaciones explícitas guían a la inferencia donde hace falta.
#Dimensiones ortogonales
Los sistemas de tipos no son una progresión lineal. Combinan ejes ortogonales de forma independiente:
CHECKING:     Static ← Gradual → Dynamic
EQUALITY:     Nominal ← → Structural
POLYMORPHISM: None → Parametric → Bounded → Higher-Kinded
INFERENCE:    Explicit → Local → Bidirectional → Full (HM)
RESOURCES:    Unrestricted → Affine → Linear
EFFECTS:      Implicit → Monadic → Algebraic
Los lenguajes reales eligen un punto en cada eje. Rust es estático + nominal + afín. TypeScript es gradual + estructural. Haskell es estático + nominal + higher-kinded + monádico. Las combinaciones forman el espacio de diseño.
#1. Momento del chequeo
| Enfoque | Cuándo se chequean los tipos | Ejemplos |
|---|---|---|
| Estático | En tiempo de compilación | Rust, Haskell, Java |
| Dinámico | En runtime | Python, Ruby, JavaScript |
| Gradual | Los dos, con fronteras | TypeScript, Python+mypy |
#2. Igualdad de tipos
| Enfoque | Los tipos son iguales cuando… | Ejemplos |
|---|---|---|
| Nominal | Tienen el mismo nombre declarado | Java, Rust, C# |
| Estructural | Tienen la misma forma/campos | TypeScript, interfaces de Go |
#3. Polimorfismo
| Tipo | Sobre qué abstrae | Ejemplos |
|---|---|---|
| Paramétrico | Variables de tipo (T) | Generics en todos los lenguajes tipados |
| Ad hoc | Implementaciones distintas por tipo | Sobrecarga, typeclasses, traits |
| De subtipos | Sustituibilidad | Herencia OOP, subtipado estructural |
| Acotado | Variables de tipo con restricciones | T: Ord, T extends Comparable |
#4. Inferencia de tipos
| Estrategia | Cómo se infieren los tipos | Ejemplos |
|---|---|---|
| Hindley-Milner | Global, tipos principales | ML, Haskell, OCaml |
| Bidireccional | Hacia arriba y hacia abajo del AST | Rust, Scala, Agda |
| Local | Solo dentro de las expresiones | var de Java, auto de C++ |
| Basada en restricciones | Resuelve sistemas de restricciones | TypeScript, sistemas graduales |
#5. Refinamiento con predicados
| Nivel | Qué expresan los tipos | Ejemplos |
|---|---|---|
| Simple | Solo tipos base | La mayoría de los lenguajes |
| Refinado | Tipos + predicados ({x: Int | x > 0}) | Liquid Haskell, F* |
| Dependiente | Los tipos se computan a partir de valores | Idris, Agda, Lean |
#6. Subestructural / registro de recursos
| Disciplina | Regla de uso | Ejemplos |
|---|---|---|
| Irrestricta | Cualquier cantidad de veces | La mayoría de los lenguajes |
| Afín | Como mucho una vez | Ownership de Rust |
| Lineal | Exactamente una vez | Linear Haskell, cálculos de investigación |
| Relevante | Al menos una vez | Sistemas de investigación |
| Ordenada | Una vez, en orden | Disciplinas de pila |
#7. Registro de efectos
| Enfoque | Qué se registra | Ejemplos |
|---|---|---|
| Ninguno | Efectos implícitos | Java, Python, Go |
| Monádico | Efectos en wrappers de tipos | IO de Haskell |
| Algebraico | Effect handlers de primera clase | Koka, OCaml 5 |
#8. Sensibilidad al flujo
| Enfoque | El tipo cambia con… | Ejemplos |
|---|---|---|
| Insensible | Fijo en la declaración | Java, C |
| Sensible | El flujo de control | TypeScript, Kotlin, Rust |
#9. Concurrencia / comunicación
| Enfoque | Qué se tipa | Ejemplos |
|---|---|---|
| Sin tipos | Sin chequeo de protocolos | La mayoría de los lenguajes |
| Marker traits | Capacidades Send/Sync | Rust |
| Session types | Máquinas de estados de protocolos | Investigación, Links |
Los lenguajes reales combinan estos ejes. Rust es estático + nominal + paramétrico + bidireccional + afín + sensible al flujo + marker traits. TypeScript es gradual + estructural + paramétrico + basado en restricciones + sensible al flujo. No hay una única combinación “mejor”; cada una sirve a objetivos distintos.
#El mapa de la expresividad
Cómo se relacionan los sistemas de tipos en términos de expresividad versus carga de anotaciones:
                    EXPRESSIVENESS
                    Low ──────────────────► High
                    │
         Simple     │  ML            Haskell+Exts
         Inference  │   │               │
                    │   ▼               ▼
                    │  Rust ────► Rust+GATs
                    │   │               │
                    │   │      Scala 3  │
                    │   │         │     │
                    │   ▼         ▼     ▼
                    │         OCaml+Mods
                    │              │
                    │              ▼
         Needs      │         F*/Lean ◄── Refinements
         Annotations│              │
                    │              ▼
                    │         Idris/Agda ◄── Full Dependent
                    │              │
                    │              ▼
         Proof      │         Coq/Lean4 ◄── Proof Assistant
         Required   │              │
                    │              ▼
                    │         Cubical ◄── HoTT
                    │
                    ▼
              ANNOTATION BURDEN
Cuanto más a la derecha vas, más podés expresar en los tipos. Cuanto más abajo vas, más trabajo tenés que hacer para dejar contento al type checker. Dónde terminás depende de qué estés construyendo y de cuánto dolor estés dispuesto a cambiar por garantías.
#Sistemas de tipos dinámicos
En los lenguajes dinámicos, los tipos existen y se chequean, solo que en runtime en lugar de en tiempo de compilación.
Los valores llevan etiquetas de tipo en runtime. Las operaciones chequean esas etiquetas antes de ejecutarse:
## Python: types checked at runtime
def add(a, b):
    return a + b

add(1, 2)       # Works: both ints
add("a", "b")   # Works: both strings
add(1, "b")     # TypeError at runtime!
El error de tipos igual ocurre. Solo que ocurre cuando ejecutás el código, no cuando lo compilás. Esto cambia la detección temprana de errores por flexibilidad y velocidad de desarrollo.
El tipado dinámico funciona bien para:
- Prototipado y exploración: cuando todavía no sabés qué forma van a tener tus datos
- Scripts y código pegamento: código de vida corta donde la velocidad de desarrollo importa más que el mantenimiento
- REPLs y desarrollo interactivo: feedback inmediato sin compilación
- Dominios muy dinámicos: serialización, ORMs y metaprogramación, donde los tipos estáticos se pelean con el problema
El tipado dinámico es “tipos chequeados más tarde”.
La pregunta no es “estático vs. dinámico” sino “¿cuánto de estático?”. Python con type hints, TypeScript en modo strict, Rust con registro completo de ownership: representan distintos puntos de un espectro. Elegí el punto que se ajuste a tu problema.
Python, Ruby, JavaScript, Lisp, Clojure, Erlang, Elixir. La mayoría tiene hoy sistemas de tipos opcionales (los type hints de Python, TypeScript para JavaScript).
#Tipado gradual
El tipado gradual mezcla chequeo estático y dinámico dentro del mismo lenguaje. Podés agregar tipos de forma incremental, y el sistema inserta chequeos en runtime en las fronteras entre el código tipado y el no tipado.
En un sistema con tipado gradual, podés dejar partes de tu código sin tipos (usando any o equivalente) mientras tipás por completo otras partes. El type checker verifica estáticamente las porciones tipadas. En runtime, se insertan chequeos donde el código tipado interactúa con el no tipado.
// TypeScript: gradual typing in action
function greet(name: string): string {
    return `Hello, ${name}`;
}

// Fully typed: checked statically
greet("Ada");  // OK at compile time

// Escape hatch: 'any' bypasses static checking
function processUnknown(data: any): void {
    // No compile-time checking on 'data'
    console.log(data.someProperty);  // Could fail at runtime
}

// The boundary: where typed meets untyped
function fromExternal(json: any): User {
    // Runtime validation needed here
    return json as User;  // Risky! No guarantee json matches User
}
La garantía gradual (gradual guarantee) es la propiedad formal que hace que esto funcione: agregar anotaciones de tipos no debería cambiar el comportamiento del programa (salvo que haya un error de tipos). Podés migrar de código sin tipos a código tipado de a una función por vez sin romper nada.
Esto permite una adopción incremental:
- Empezás con un codebase con tipado dinámico
- Agregás tipos primero en los caminos críticos
- Expandís la cobertura de tipos gradualmente
- Los chequeos en runtime atrapan las violaciones en las fronteras
#Blame tracking
Cuando ocurre un error de tipos en una frontera, ¿de quién es la culpa? El blame tracking (atribución de culpa) le atribuye los errores al lado no tipado de la frontera. Si el código tipado llama a código no tipado y recibe de vuelta un tipo equivocado, la culpa recae sobre el código no tipado.
## Python with type hints
def typed_function(x: int) -> int:
    return x + 1

def untyped_function(y):
    return "not an int"  # Bug here

## At runtime, the error is blamed on untyped_function
result: int = untyped_function(5)  # Runtime TypeError
TypeScript, Python (con mypy/pyright), PHP (con Hack), Racket (Typed Racket), Dart (antes de null safety), C# (con nullable reference types).
#Lecturas adicionales
Libros:
- “Types and Programming Languages”, de Benjamin Pierce, el libro de texto
- “Software Foundations”, gratis online, una introducción interactiva basada en pruebas
- “Programming Language Foundations in Agda”, tipos dependientes para programadores
- “Type-Driven Development with Idris”, de Edwin Brady, la introducción más práctica a los tipos dependientes
- “The Little Typer”, de Friedman y Christiansen, un recorrido socrático y amable por los tipos dependientes
Lenguajes para probar:
- Rust: la mejor introducción práctica a los tipos afines
- Haskell: HKT, typeclasses, GADTs, el estándar de la programación funcional
- Idris 2: los tipos dependientes más accesibles
- Koka: un diseño limpio de sistema de efectos
Papers:
- “Propositions as Types”, de Philip Wadler, cubre la correspondencia de Curry-Howard
- “Theorems for Free”, de Philip Wadler, qué garantiza la parametricidad
- “Linear Types Can Change the World”, por qué importa la linealidad
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo (en inglés).