Una prueba vale lo que vale su spec
La verificación formal no elimina el riesgo. Lo traslada a la spec, al modelo y a la trusted base. Cinco pruebas ejecutables en Lean 4 que compilan sin errores y aun así esconden bugs reales.
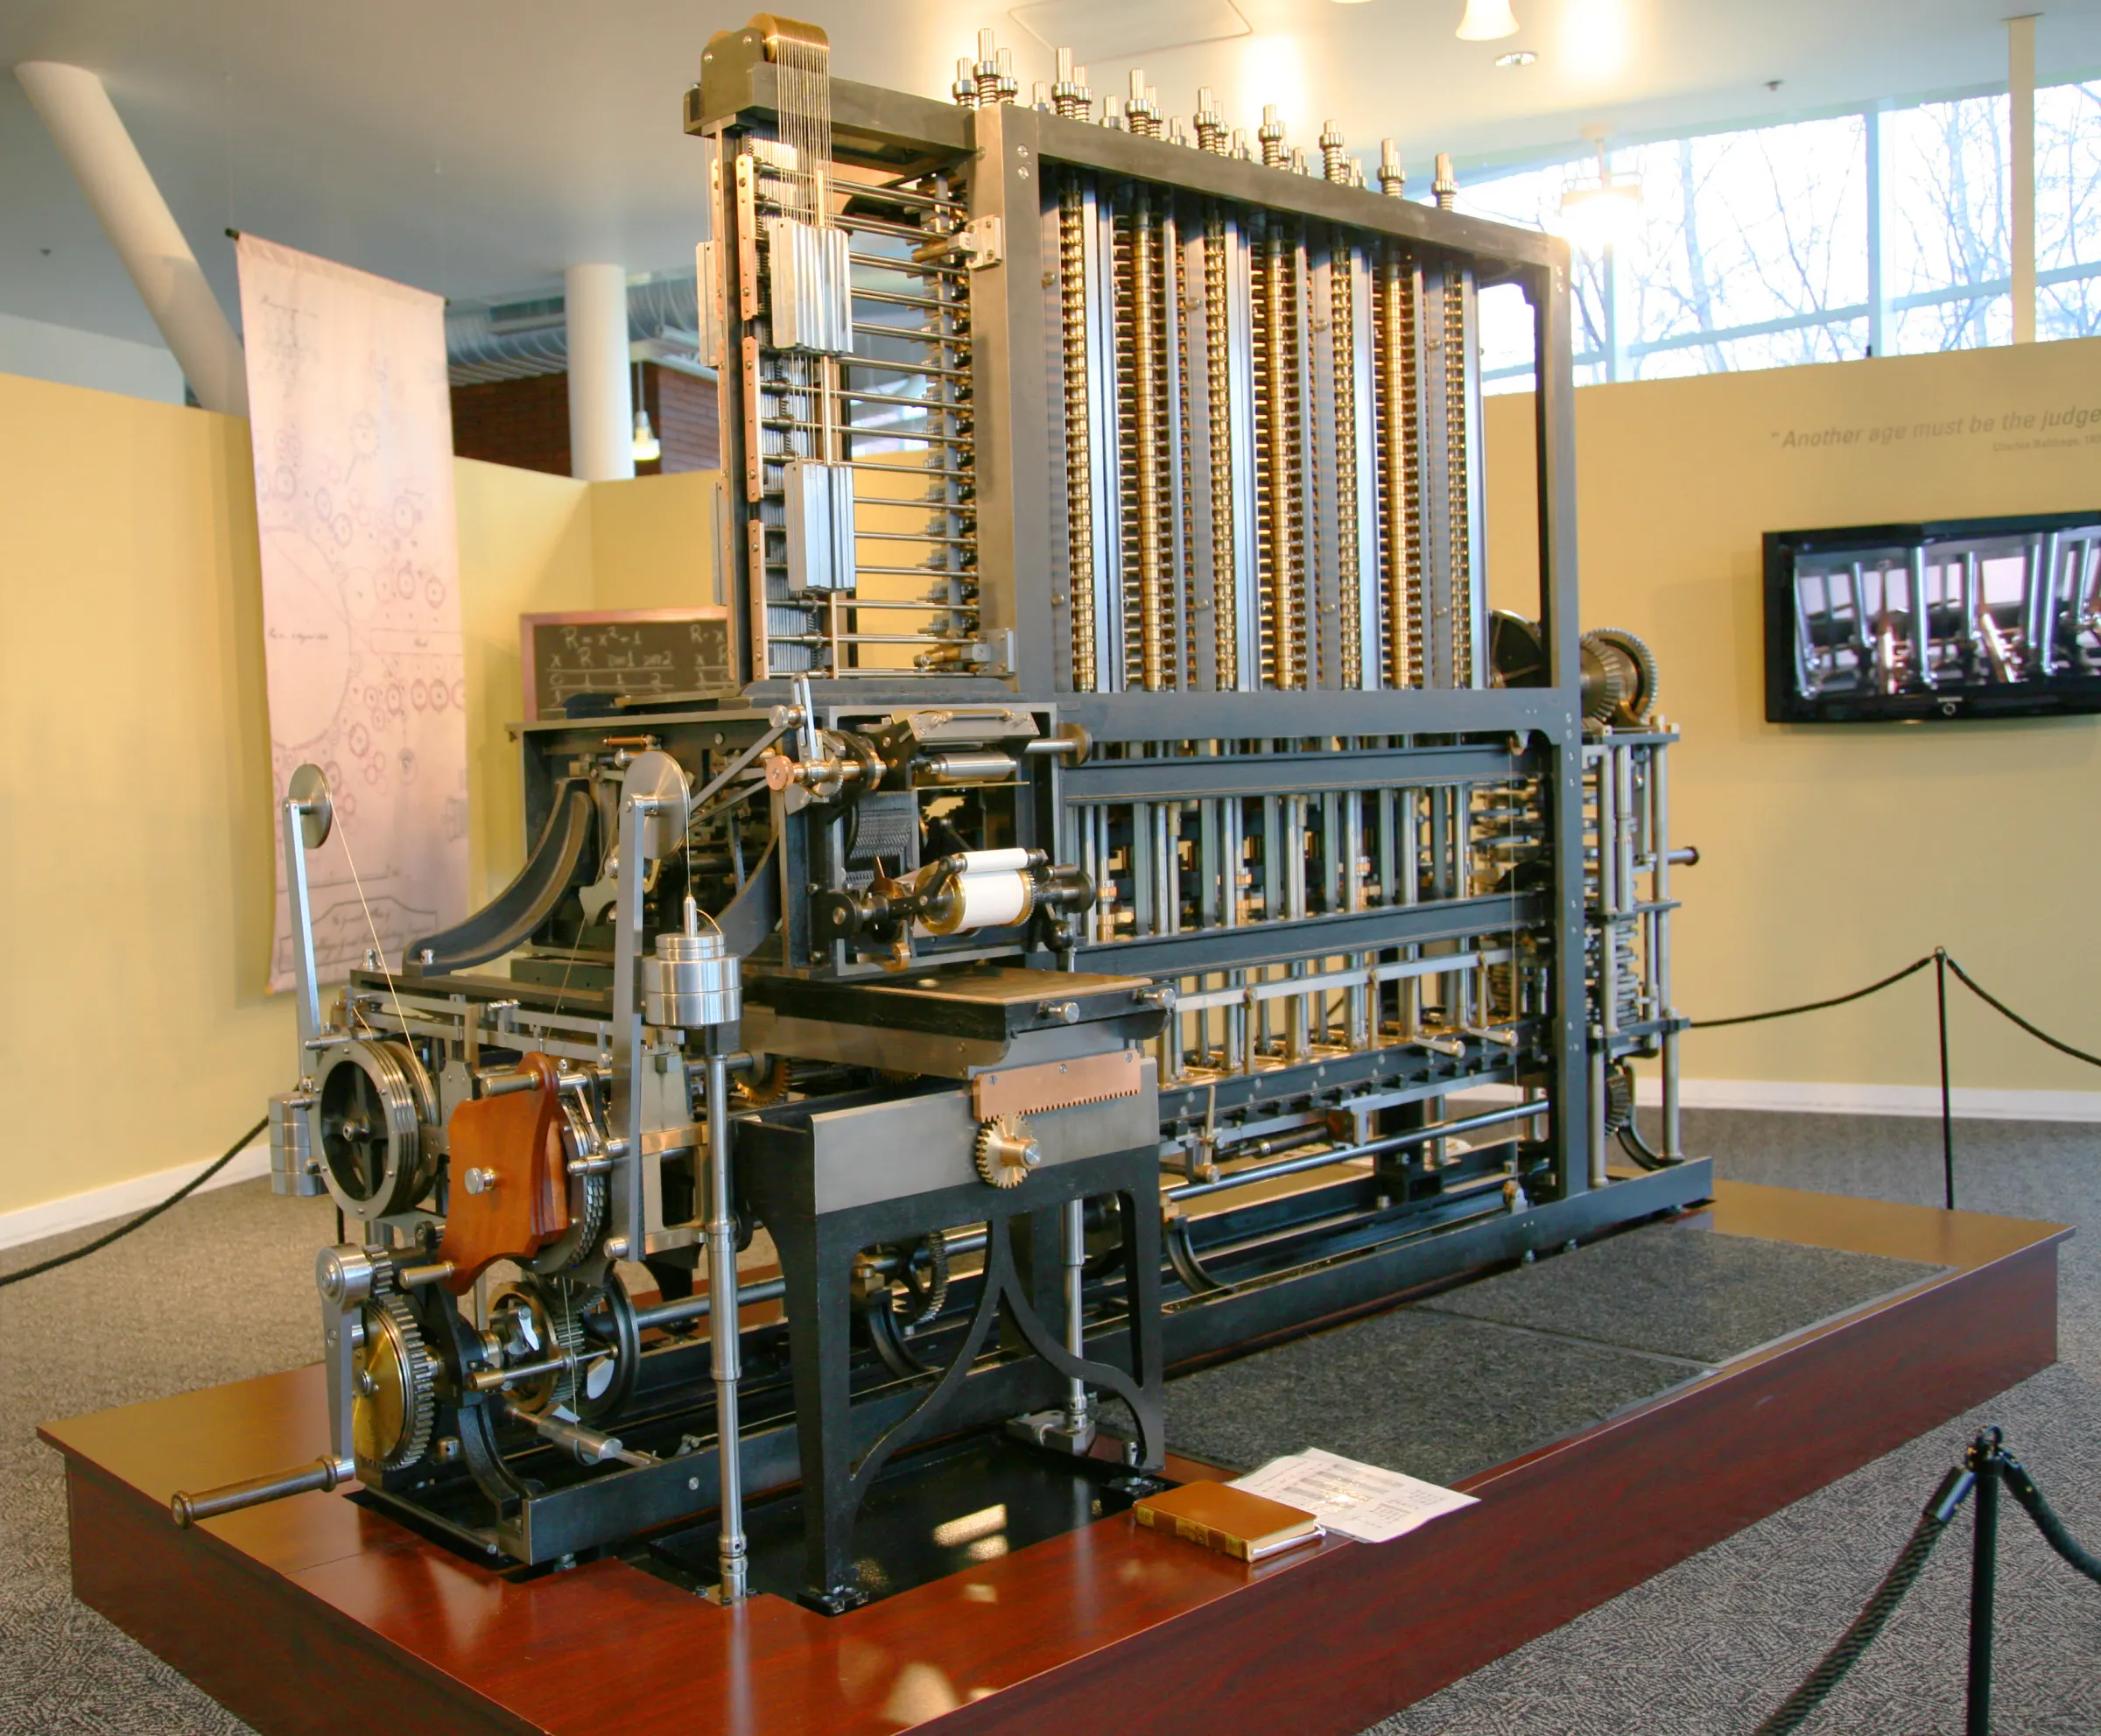
Sobre la imagen La máquina calcula exactamente lo que dice su diseño, hasta el último dígito. Si el diseño hace la pregunta correcta es algo que la máquina no te puede decir. La Máquina Diferencial N.º 2 de Babbage, una construcción funcional del diseño que dibujó entre 1847 y 1849. Foto: Jitze Couperus, CC BY 2.0, vía Wikimedia Commons.
Traducción automática del original en inglés, todavía sin revisar. Leer el original.
Quiero que Ethereum tenga más verificación formal, no menos. Por eso escribo esto.
Hay una forma infalible de desacreditar todo el esfuerzo de los métodos formales, y es venderlo de más. Si dejamos que “verificado formalmente” empiece a significar “seguro”, la primera vez que algo con esa etiqueta falle en producción todo el mundo se va a llevar la lección equivocada en el peor momento posible. Y la etiqueta ya se aplica a mucho más que smart contracts: circuitos de prueba ZK, clientes de consenso, la propia máquina virtual. Me gustaría adelantarme a eso, porque la herramienta es genuinamente una de las mejores que tenemos. Simplemente merece una afirmación más precisa que la que suele acompañarla. La gente que está construyendo modelos del protocolo en Lean está haciendo parte del trabajo más valioso del ecosistema, y quiero fortalecer la afirmación que su trabajo sostiene, no desgastarla. Así que, a lo largo de todo el texto, dá por sentado que el equipo es competente y que los métodos están maduros. Los huecos que voy a señalar no son errores de principiante. Son lo que queda después de que un buen equipo hizo todo bien.
Esta es la afirmación que voy a defender:
La verificación formal reduce una superficie, la brecha entre una implementación y su especificación, casi a cero. Lo que no hace es eliminar el riesgo. Lo mueve a otro lado: a la especificación, al modelo y a la trusted base. El modo de falla es confundir ese traslado con una eliminación.
Un teorema verificado por máquina no dice “el código es correcto”. Escrito completo, dice algo más cauteloso:
la implementación satisface la especificación, dentro de un modelo, módulo una trusted base, para las propiedades que a alguien se le ocurrió enunciar.
La primera cláusula es lo que la verificación realmente entrega, y lo entrega por completo. Los tests y los fuzzers muestrean el espacio de comportamientos; una prueba lo cubre entero. Todo lo que viene después de esa primera cláusula es juicio humano, y el checkmark no toca nada de eso. Cada uno de los ejemplos que siguen es una prueba completa en Lean 4, sin sorry. (El de la trusted base lleva un sorry a propósito, y lo voy a marcar cuando lleguemos.) Cada uno muestra la forma de un bug real que vive en alguna de esas cláusulas posteriores. El código compila, y lo podés correr vos mismo.
Hay una objeción que merece plantearse de entrada, porque atraviesa todo el texto: “Cada uno de estos casos es simplemente que la spec, el modelo o los axiomas están mal, y acertar con eso es justamente el objetivo del programa de verificación. Así que estás argumentando a favor del programa, no en contra.” Es cierto, y no es una refutación. Acertar con la spec, el modelo y la trusted base es el trabajo. Mi punto es que ese trabajo no es obviamente más fácil que escribir código correcto desde el principio, y que parte de él no se puede auditar desde dentro de la prueba. El peligro es cultural. Un equipo que lee el checkmark como si hubiera terminado ese trabajo, en vez de haberlo trasladado, termina mordido por un bug que técnicamente nunca estuvo ahí.
No digo que nada de esto sea nuevo. Cada uno de los cuatro huecos se entiende bien en la literatura de métodos formales, y un especialista los va a reconocer todos a primera vista. Lo que quiero agregar es énfasis, más tres cosas concretas: una pequeña demostración ejecutable de cada hueco, un mapeo a los lugares donde este ecosistema realmente perdió más plata, y la disciplina que se desprende de todo eso. Si hay una afirmación novedosa, es solo esta: no dejes que un checkmark verde reemplace en silencio ese trabajo.
#Primero, lo que la verificación realmente cierra
Los huecos solo significan algo medidos contra el poder, así que empecemos por el poder. Esto es lo que una prueba hace y ninguna suite de tests puede hacer. Modelá la palabra de máquina, enunciá la propiedad que te importa, y el tipo de overflow que destruye a un modelo ingenuo (el de “una prueba es sobre un modelo”, más abajo) deja de ser un riesgo y pasa a ser imposible:
def checkedAdd (a b : UInt8) : Option UInt8 :=
  if a.toNat + b.toNat < 256 then some (a + b) else none

-- whenever checkedAdd succeeds, the result is the true sum, no silent wrap, ever
theorem checkedAdd_never_wraps (a b r : UInt8) (h : checkedAdd a b = some r) :
    r.toNat = a.toNat + b.toNat := by
  unfold checkedAdd at h
  split at h
  · rename_i hlt; simp only [Option.some.injEq] at h; subst h; rw [UInt8.toNat_add]; omega
  · contradiction
El cuantificador hace todo el trabajo. Ese ∀ a b cubre acá las 256 × 256 entradas, y las 2²⁵⁶ × 2²⁵⁶ con el ancho completo, y la prueba resuelve todas de una vez. Un fuzzer solo puede muestrear ese espacio. El bug exacto con el que nos vamos a topar más abajo, un saldo que baja cuando depositás en él, ahora es inalcanzable, y lo es de forma demostrable:
theorem checkedAdd_never_loses (a b r : UInt8) (h : checkedAdd a b = some r) :
    a ≤ r := by
  have := checkedAdd_never_wraps a b r h
  rw [UInt8.le_iff_toNat_le]; omega
No es poca cosa. Una clase entera de bugs, eliminada para todas las entradas posibles, con una certeza que el testing no puede alcanzar. Por eso la verificación formal vale la pena, y por eso vale la pena describirla con precisión. Tenelo presente; el resto del texto trata sobre dónde termina su alcance.
#Una prueba solo restringe lo que se te ocurrió decir
Empecemos por la versión más simple. Decimos qué significa ordenar, “la salida está ordenada”, y probamos que una implementación lo cumple:
inductive Sorted : List Nat → Prop
  | nil  : Sorted []
  | one  : ∀ a, Sorted [a]
  | cons : ∀ a b l, a ≤ b → Sorted (b :: l) → Sorted (a :: b :: l)

def IsSortingSpec (f : List Nat → List Nat) : Prop := ∀ l, Sorted (f l)

def sortBad (_ : List Nat) : List Nat := []

theorem sortBad_correct : IsSortingSpec sortBad := by
  intro _; exact Sorted.nil
sortBad descarta tu entrada y devuelve la lista vacía. La lista vacía está ordenada, así que la prueba pasa. Lo que falta es el requisito de que la salida sea una permutación de la entrada, y como nadie lo escribió, nada impide la trampa. A este tamaño el hueco es obvio. El problema es que el mismo tipo de hueco no se vuelve más visible a medida que el sistema crece. Acá está en una transferencia:
def TransferSpec (f : Nat → State → State) : Prop :=
  ∀ amt s, amt ≤ s.alice →
    (f amt s).bob = s.bob + amt ∧ (f amt s).alice = s.alice - amt

def transferEvil (amt : Nat) (s : State) : State :=
  { alice := s.alice - amt, bob := s.bob + amt, deployer := s.deployer + amt }

theorem transferEvil_correct : TransferSpec transferEvil := by
  intro amt s _; exact ⟨rfl, rfl⟩
transferEvil le debita a Alice y le acredita a Bob exactamente como exige la spec. También le acredita en silencio al deployer en cada llamada. La spec fijó qué les pasa a Alice y a Bob y no dijo nada sobre nadie más, así que el robo le resulta invisible.
Para ser justos, la propiedad más fuerte atrapa la trampa enseguida:
def CompleteTransferSpec (f : Nat → State → State) : Prop :=
  ∀ amt s, amt ≤ s.alice →
    (f amt s).bob = s.bob + amt ∧
    (f amt s).alice = s.alice - amt ∧
    (f amt s).deployer = s.deployer        -- the clause that was missing

theorem transferEvil_not_complete : ¬ CompleteTransferSpec transferEvil := by
  intro h
  have hd := (h 1 { alice := 1, bob := 0, deployer := 0 } (by decide)).2.2
  exact Nat.succ_ne_zero 0 hd
“Entonces escribí la spec más fuerte.” Claro, y una buena metodología te empuja a hacerlo. Las condiciones de marco (frame conditions) convierten “lo que no cambia” en una obligación explícita; una spec de correctitud funcional completa intenta fijar el comportamiento por completo. Esa es la disciplina correcta, y los equipos serios la siguen. Pero mirá lo que pide, y lo que no te puede devolver. Una spec suele ser mucho más chica y clara que el código que gobierna, y esa es buena parte de la razón para escribirla. Su completitud es otra cuestión, y es justamente la que no podés saldar. Listar cada propiedad a la que podría apuntar un adversario, cada cuenta que tiene que quedar fija, cada invariante que tiene que sobrevivir a cada intercalado, es un trabajo sin fin. Ninguna prueba te da esa lista, y no hay ningún teorema que diga “ya nombraste todo lo que importa”. La verificación se queda callada sobre cada propiedad que no escribiste, y ahí es casi exactamente donde viven los bugs de seguridad.
#Una prueba es sobre un modelo, y el modelo no es lo que deployás
Este es el más filoso de los cuatro, porque una spec mejor no lo arregla. La propiedad está enunciada, la prueba es real, y aun así es un teorema verdadero sobre el universo equivocado.
Tomá un invariante que nadie discutiría: depositar en tu cuenta nunca baja tu saldo. Sobre los números naturales es un teorema:
def depositℕ (balance amount : Nat) : Nat := balance + amount

theorem deposit_never_loses_funds_ℕ (balance amount : Nat) :
    balance ≤ depositℕ balance amount :=
  Nat.le_add_right balance amount
La máquina en la que deployás no tiene números naturales. Tiene palabras de ancho fijo, y esas dan la vuelta (wrap around). El mismo enunciado, palabra por palabra, ahora es falso, y podés probar que es falso:
def depositWord (balance amount : UInt8) : UInt8 := balance + amount

theorem deposit_CAN_lose_funds_word :
    ¬ (∀ balance amount : UInt8, balance ≤ depositWord balance amount) := by
  intro h
  exact absurd (h 255 1) (by decide)         -- 255 + 1 wraps to 0

example : depositWord 255 1 = 0 := by decide
Una cuenta al máximo que recibe una unidad más termina sin nada. La prueba sobre ℕ “descartó” eso, en un universo donde de entrada no podía pasar. Esto no es académico. En 2018 el bug batchOverflow (CVE-2018-10299) vació el token ERC-20 de BeautyChain exactamente con esta aritmética: dos transferencias de 2²⁵⁵ sumaban 2²⁵⁶ y hacían que un saldo de 256 bits volviera a cero. Una prueba de conservación sobre ℕ habría aprobado el contrato vulnerable.
Ahora la objeción obvia, y es justa: ningún equipo competente modela la aritmética de tokens sobre ℕ. Usan razonamiento sobre bitvectors que captura exactamente la palabra de máquina, y este bug en particular no sobrevive a eso. De acuerdo. Pero la lección no es “elegí un tipo entero mejor”. Es que el alcance de una prueba termina en el borde de su modelo, y ese borde no se ve desde dentro de la prueba. Acá UInt8 es solo un sustituto. Poné un modelo de palabra de 256 bits impecable y lo único que hiciste fue mover el borde a otro lugar. El modelo sigue dejando algo afuera: el esquema de gas, la traducción de código fuente a bytecode, el scheduler, el hardware, los bytes que efectivamente se deployan. Un loop que probaste que termina igual se puede quedar sin gas y revertir, porque el costo nunca estuvo en el modelo. Dos clientes que refinan de forma demostrable la misma spec abstracta igual pueden partir la cadena, si la spec dejó abierta la codificación de bytes y cada uno la completó de manera distinta.
Hay otro hueco que ningún tipo entero toca, y es concreto, no filosófico. Una prueba sobre una especificación no es una prueba sobre la implementación que la ejecuta. Podés verificar un protocolo en Lean y no haber dicho nada sobre los codebases de los clientes que lo ejecutan, porque no se extraen de la prueba. Los buenos equipos lo saben y trabajan en eso, ya sea verificando los clientes directamente o usando la spec formal como oráculo de differential testing contra ellos. Nadie ignora el hueco. El punto es que cerrarlo es un segundo esfuerzo más o menos tan grande como el primero, y la prueba sobre la spec no lo hace por vos. El modelo con precisión de bits cierra el hueco aritmético y deja este completamente abierto.
Esta no es una historia sobre gente descuidada. Es la forma de los mayores éxitos del campo. seL4 y CompCert están verificados hasta supuestos que declaran abiertamente, sobre el compilador, el modelo de hardware y lo que simplemente queda fuera de alcance, y el riesgo que queda está en esos bordes y no en el núcleo verificado. La documentación de seL4 es refrescantemente directa al respecto: el resultado de no filtración vale solo para los canales de información que representa el modelo de hardware, así que los canales laterales de timing fuera de ese modelo quedan fuera de alcance, punto. CompCert es la versión alentadora de la misma historia. Años de fuzzing no encontraron bugs en su optimizador verificado, solo en el código no verificado que lo rodea. En los dos casos la prueba hizo su trabajo, y el borde era donde había que poner la atención. El paso de “el modelo sobre el que probé cosas” a “el sistema que realmente corre” es en sí mismo un supuesto. Lo podés achicar y escribir explícitamente, y la buena práctica lo hace, pero no lo podés convertir en un teorema desde dentro de la prueba, porque la máquina real no es un objeto matemático sobre el que la prueba pueda cuantificar.
#“El teorema chequea” no es “el sistema está verificado”
Una prueba es tan sólida como el kernel, los axiomas en juego y cualquier atajo que hayas tomado. Este es el hecho que sostiene esta sección: el kernel chequea tu prueba, pero no tiene forma de chequear si tus axiomas son verdaderos. Esa parte queda en manos de personas. Y un axioma necesario y uno ruinoso se ven idénticos: misma palabra clave, mismo checkmark verde.
No podés verificar nada que use criptografía sin asumir propiedades que no podés probar. Eso es normal y correcto:
axiom Hash : Nat → Nat
axiom hash_collision_resistant : ∀ a b, Hash a = Hash b → a = b

theorem ids_are_unique (a b : Nat) (h : Hash a = Hash b) : a = b :=
  hash_collision_resistant a b h
Ahora un axioma falso, salvo que no parece falso. Sobre los enteros o los reales, a * b / b = a es simplemente verdadero, y cualquiera que haya aprendido álgebra ahí lo va a dejar pasar asintiendo. Sobre una palabra de ancho fijo es falso, porque la multiplicación hace overflow:
axiom mul_div_cancel : ∀ (a b : UInt8), b ≠ 0 → a * b / b = a

theorem fee_recoverable (price qty : UInt8) (h : qty ≠ 0) :
    price * qty / qty = price :=
  mul_div_cancel price qty h
Lean acepta el axioma, y el plausible teorema “la comisión siempre es recuperable” apoyado sobre él. También va a probar que el axioma es falso, usando nada más que su propia lógica estándar, sin ayuda del supuesto trucho:
theorem mul_div_cancel_is_false : ¬ ∀ (a b : UInt8), b ≠ 0 → a * b / b = a := by
  intro h
  exact absurd (h 200 2 (by decide)) (by decide)   -- 200*2 = 144 (mod 256); 144/2 = 72 ≠ 200
O sea que el kernel aceptó el axioma y una refutación de ese mismo axioma, uno al lado del otro, sin una sola queja. Chequeó las pruebas. Nunca se formó una opinión sobre si el axioma era verdadero. Y ese es el peligro realista, no algún 0 = 7 flagrante que una revisión atraparía en la primera pasada. Es un axioma que importa en silencio la intuición del sistema numérico equivocado, o que describe el entorno, un modelo de memoria, un supuesto de costo o de timing, y le pifia por poco. Desde dentro de la prueba es indistinguible de uno que es exactamente correcto, y se vuelve más fácil de pasar por alto a medida que la spec crece. Un tercer agujero es todavía más silencioso: una prueba que quedó sin terminar y se shippeó en verde.
theorem solvency_preserved
    (assets liabilities : Nat) (h : liabilities ≤ assets) :
    liabilities ≤ assets + 1 := by
  sorry
Lean tampoco miente sobre esto. Imprime un warning y registra sorryAx. Que el warning haga fallar tu build es una decisión de política de CI, no un hecho sobre la prueba. “El pipeline está en verde” puede querer decir, en silencio, “la prueba chequea, y CI se configuró para no rechazar justo lo que habría atrapado esto”. El único chequeo que distingue los tres casos es preguntar sobre qué se apoya realmente cada teorema:
#print axioms ids_are_unique
-- [Hash, hash_collision_resistant]  ← necessary; must be reviewed by humans
#print axioms fee_recoverable
-- [propext, mul_div_cancel]          ← rests on the false axiom; the kernel raised no objection
#print axioms mul_div_cancel_is_false
-- [propext]                          ← refuted using only Lean's standard logic; the axiom was just wrong
#print axioms solvency_preserved
-- [sorryAx]                          ← unproven; a warning CI may have ignored
“Eso es mala praxis, no una limitación de la verificación formal.” Para el axioma falso, seguro. Pero el axioma necesario no es mala praxis. Es inevitable, y carga tanto peso y es tan indemostrable como el otro. Todo sistema verificado se apoya en una trusted base: el kernel, el elaborador, cualquier uso de native_decide (que reemplaza el kernel por el compilador), y un conjunto de supuestos honestos sobre criptografía y hardware que podrían estar sutilmente mal. No podés eliminar la trusted base. Solo podés auditarla. Así que el enunciado honesto es operativo. Un proyecto verificado es exactamente tan fuerte como su política de axiomas, su política de CI y su auditoría de dependencias, y el checkmark no garantiza ninguna de esas cosas.
#La verificación no te salva de un requisito equivocado, solo lo enuncia con precisión
Este es el caso más profundo, y el que más debería preocupar al programa, porque la prueba es real y la spec parece perfectamente razonable. Tomá un retiro, separado en sus dos efectos reales: pagarle al usuario, que en un sistema en vivo es la llamada externa que le pasa el control a un llamador posiblemente hostil, y actualizar el registro interno.
def pay   (amt : Nat) (w : World) : World := { w with pocketed := w.pocketed + amt }
def debit (amt : Nat) (w : World) : World := { w with recorded := w.recorded - amt }

def WithdrawSpec (before after : World) : Prop :=
  after.pocketed = before.pocketed + before.recorded ∧ after.recorded = 0
La spec dice: después de retirar el saldo completo, el usuario se embolsó ese saldo y no se le debe nada. Bastante razonable. Ahora dos implementaciones, una que paga antes de debitar y otra que debita antes de pagar:
def withdrawUnsafe (w : World) : World := let amt := w.recorded; debit amt (pay amt w)
def withdrawSafe   (w : World) : World := let amt := w.recorded; pay amt (debit amt w)

theorem unsafe_meets_spec (w : World) : WithdrawSpec w (withdrawUnsafe w) := by
  refine ⟨?_, ?_⟩ <;> simp [withdrawUnsafe, pay, debit]

theorem safe_meets_spec (w : World) : WithdrawSpec w (withdrawSafe w) := by
  refine ⟨?_, ?_⟩ <;> simp [withdrawSafe, pay, debit]
Las dos satisfacen la spec. El verificador está igual de contento con cualquiera, y “verificado” no te dice nada sobre cuál preferirías deployar. Pero corrélas bajo reentrancy, donde el atacante vuelve a entrar durante pay, antes de que se actualice el registro, y se separan. La propiedad que las distingue es la que nadie escribió:
-- The attacker re-enters during `pay`, before the record is updated.
def unsafeUnderReentrancy (w : World) : World :=          -- trace: pay; pay; debit; debit
  let amt := w.recorded                                  -- both calls see the same balance
  debit amt (debit amt (pay amt (pay amt w)))

def safeUnderReentrancy (w : World) : World :=            -- debit first ⇒ re-entry sees 0
  let amt := w.recorded
  let w1  := debit amt w
  pay amt (pay w1.recorded (debit w1.recorded w1))

def NoOverWithdrawal (run : World → World) : Prop :=
  ∀ w, (run w).pocketed ≤ w.pocketed + w.recorded

theorem safe_reentrancy_no_overwithdrawal : NoOverWithdrawal safeUnderReentrancy := by
  intro w; simp [safeUnderReentrancy, pay, debit]

theorem unsafe_reentrancy_overwithdraws : ¬ NoOverWithdrawal unsafeUnderReentrancy := by
  intro h
  exact absurd (h { recorded := 100, pocketed := 0 }) (by decide)   -- pockets 200, not 100
El orden seguro, de forma demostrable, nunca paga de más. El inseguro, de forma demostrable, sí: arrancalo con un saldo registrado de 100 y paga 200. Los dos tienen una prueba limpia de la misma spec. Toda la distancia entre “está bien” y “lo vaciaron” estaba en un único supuesto no enunciado, que la llamada externa no puede volver a entrar antes de la actualización del estado, que todos tenían en la cabeza y nadie puso en la spec. Esto es The DAO (junio de 2016) en miniatura, donde una llamada reentrante sacó alrededor de 3,6 millones de ETH volviendo a entrar durante el pago, antes de que se anotara el saldo. La prueba no era falsa. El requisito estaba incompleto, y la verificación lo reprodujo fielmente, con agujero y todo.
“Un equipo capaz no se quedaría en una relación de estado final. Una propiedad sobre trazas, una spec con tipos de efectos o un adversario explícito al que se le permite volver a entrar atraparían esto.” Concedido, y ese es el instinto correcto; las herramientas existen. Pero cada una de ellas necesita que decidas, de antemano, modelar la llamada externa como un punto de reentrada que controla un atacante. Esa decisión es exactamente el conocimiento que le faltaba a todo el ecosistema en 2016. La propiedad tenía que conocerse antes de poder escribirse, y cuanto más rico es el formalismo, más de estas decisiones te pide acertar. No podés probar que tu conjunto de propiedades está completo. Te enterás de que no lo estaba, normalmente después del exploit. La verificación convierte “¿este código es correcto?” en “¿enunciamos todas las propiedades que importan?”, y la segunda pregunta no viene con checkmark.
#Dónde nos deja esto
No estoy argumentando en contra de la verificación formal. Estoy argumentando en contra de una forma de describir lo que te da.
Hace algo real y poco común. Elimina la clase de bugs “el código no hace lo que dice la spec”, por completo, para cada entrada que el modelo permite. Esa clase es grande y peligrosa, y limpiarla vale muchísimo esfuerzo. seL4 y CompCert son hitos precisamente porque la limpiaron en sistemas reales.
Lo que hace es limpiar esa única superficie y concentrar el resto del riesgo en tres lugares a los que el checkmark no llega:
- la especificación, que puede estar incompleta o fielmente equivocada;
- el modelo, donde podés tener un teorema verdadero sobre el universo equivocado, con una brecha de refinamiento respecto de la máquina real que no se ve desde dentro de la prueba;
- la trusted base, los axiomas que el kernel nunca juzga y la política de CI que nunca define.
Las pérdidas que este ecosistema realmente sufrió coinciden con esos tres, no con la brecha entre implementación y spec que una prueba cierra. The DAO fue un requisito que nadie había terminado. Los vaciamientos por overflow se le habrían escapado a una prueba hecha sobre el modelo aritmético equivocado, y los habría atrapado una hecha sobre el modelo correcto, que es todo el punto sobre la elección del modelo. Las divisiones de consenso viven en el borde entre una spec y los clientes independientes que la implementan. Un checkmark verde da la sensación de haber respondido todo esto. No lo hizo, y en el caso del overflow solo responde si justo elegiste el modelo que se lo permite.
Así que el eslogan no debería ser “verificado formalmente, por lo tanto seguro”. Más cerca de la verdad:
La verificación convierte una búsqueda abierta de bugs en una lista precisa y acotada de cosas que todavía tenés que hacer bien: la spec, el modelo, la trusted base. Esa lista es donde ahora vive el trabajo real, y merece más escrutinio una vez que el checkmark está en verde, no menos.
En la práctica, eso significa tratar los huecos como parte del trabajo de verificación, no como notas al pie:
- Acompañá cada spec funcional con sus propiedades de completitud: conservación, “nada más cambia”, totalidad, permutación. Seguí preguntándote qué deja sin restringir la spec.
- Verificá sobre el tipo que realmente deployás, y meté los costos en el modelo. Si no podés, escribí el refinamiento a la máquina real como un supuesto explícito, y tratá ese supuesto como superficie de ataque.
- No dejes que una prueba sobre la spec reemplace una garantía sobre la implementación. Verificá también el cliente, o hacele differential testing contra la spec ejecutable. La distancia entre “el protocolo es correcto” y “este nodo es correcto” es trabajo real.
- Corré
#print axiomsen CI sobre cada teorema que shippeás, y hacé que el conjunto de axiomas y la política desorrysean cosas que una persona apruebe. - Escribí los supuestos no enunciados (atomicidad, no reentrancy, orden) y probá las propiedades que dependen de ellos, en vez de quedarte en la spec de estado final.
Hacé eso, y la verificación cumple lo que promete. Tratá el checkmark como la línea de llegada y cambiaste una auditoría real por la sensación de una. La herramienta es excelente. La línea de llegada simplemente está más lejos de lo que sugiere el checkmark, y decirlo con claridad es, creo, la mejor forma de ayudar a un esfuerzo que merece funcionar.
Los cinco ejemplos, la demostración positiva de arriba más los cuatro huecos, están como código fuente completo de Lean 4 que compila en github.com/unbalancedparentheses/verified-still-broken, y chequean con nix run. El único warning es el sorry intencional del ejemplo de la trusted base, cuya presencia es justamente el punto.
#Referencias
- The DAO (junio de 2016), reentrancy, ~3,6M ETH. Gemini Cryptopedia, The DAO Hack; Chainlink, Reentrancy Attacks and The DAO Hack.
batchOverflow/ BeautyChain (BEC), abril de 2018. NVD, CVE-2018-10299.- seL4, lo que asumen las pruebas (incl. canales laterales fuera del alcance del modelo). What the Proofs Assume.
- CompCert, la trusted computing base. Monniaux & Boulmé, The Trusted Computing Base of the CompCert Verified Compiler; resultado de fuzzing: Yang et al., Finding and Understanding Bugs in C Compilers (PLDI 2011).
Escrito con un LLM, como todo lo de este sitio. Las ideas y los errores son míos. Cómo escribo (en inglés).